Google Flights 是一种广受欢迎的航班搜索服务,将航班时刻、航空公司和票价信息汇总在一起,蕴含大量航班数据,包括票价、时刻表和航空公司详情。
遗憾的是,Google 并未为该平台提供公开 API,这意味着如果您想大规模采集信息——例如监测票价趋势或搭建自己的比价工具——就需要对该网站进行数据抓取。
本文将介绍三种实现方法:使用 Python(配合 Playwright)、调用第三方 Google Flights API,以及使用无代码工具,同时还会讨论如何应对反爬措施,并对这几种方案进行对比。
对这一服务进行数据抓取,可以为多种用途挖掘有价值的航班数据:无论是追踪票价、比较航空公司选项,还是开展市场调研,Google Flights 都能提供大量有助于决策的信息。
例如,您可以追踪票价随时间的变化、分析价格趋势、找到更合适的预订时机,并对比不同航空公司和日期的票价。
然而,由于动态内容加载和反爬虫防护机制的存在,如果没有合适的工具和方法,采集这些数据会相当有挑战性,不过本文会帮您规避这些问题。接下来,让我们一起看看如何抓取 Google Flights 数据。
如何使用 Python 抓取 Google Flights 数据
抓取 Google Flights 数据的一种方法是使用 Python 编写自定义爬虫。Google Flights 是一种大量依赖 JavaScript 动态加载结果的网站,因此普通的 HTTP 请求无法获取全部航班数据。
您可以借助工具自动化操作一个无头浏览器,例如使用 Playwright(或Selenium)。这样一来,您的脚本就能在 Google Flights 页面上执行搜索、等待结果加载,然后提取数据,解析页面的 HTML。下面是使用 Playwright 的详细步骤说明,包含用于扩展规模的代理使用方法。
步骤一:搭建 Python 与 Playwright 环境
首先,安装Playwright:
pip install playwright
安装其浏览器驱动:
playwright install
如果您打算解析 HTML,还需要安装相应的解析库(如 beautifulsoup4),不过 Playwright 也可以直接通过 CSS 选择器获取文本。接下来,新建一个 Python 脚本并导入所需模块。
步骤二:启动无头浏览器
使用 Playwright 启动无头浏览器并打开 Google Flights 页面,例如:
import asyncio
from playwright.async_api import async_playwright
async def fetch_flights(departure, destination, date):
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        context = await browser.new_context()
        # Optionally, set a proxy for this context to avoid IP blocks
        # context = await browser.new_context(proxy={"server": "http://<PROXY_IP>:<PORT>"})
        page = await context.new_page()
        await page.goto("https://www.google.com/travel/flights")
        # Fill the search form
        await page.fill("input[aria-label='Where from?']", departure)
        await page.fill("input[aria-label='Where to?']", destination)
        await page.fill("input[aria-label='Departure date']", date)
        await page.keyboard.press("Enter")  # start search
        await page.wait_for_selector("li.pIav2d")  # wait for flight listings to load
        # Extract flight results
        flights = []
        flight_items = await page.query_selector_all("li.pIav2d")
        for item in flight_items:
            airline = await item.query_selector("div.sSHqwe.tPgKwe.ogfYpf")
            price = await item.query_selector("div.FpEdX span")
            time = await item.query_selector("span[aria-label^='Departure time']")
            # Get inner text from elements
            airline_name = await airline.inner_text() if airline else None
            price_text = await price.inner_text() if price else None
            dep_time = await time.inner_text() if time else None
            flights.append({"airline": airline_name, "price": price_text, "departure_time": dep_time})
        await browser.close()
        return flights
# Example usage:
results = asyncio.run(fetch_flights("LAX", "JFK", "2025-12-01"))
print(results)
在上述代码中,我们加载 Google Flights 搜索页面,输入出发地、目的地和日期,然后等待航班结果加载。每条航班结果都包含在一个 class 为 pIav2d 的 HTML <li> 元素中(页面上用于承载列表项的容器)。
Playwright 的 API 支持获取每个元素的内部文本,我们将其存入 Python 的字典列表中以便后续使用。
步骤三:处理动态内容与分页
Google Flights 默认通常只显示有限数量的结果。要加载全部结果,您可能需要滚动页面或点击“显示更多航班”按钮。使用 Playwright,您可以在循环中模拟点击该按钮,直到不再有新结果加载为止,从而确保获取与查询相关的全部航班列表。
例如,您可以这样实现:
# Pseudocode: click "Show more flights" until it disappears
while True:
    try:
        more_button = await page.wait_for_selector('button[aria-label*="more flights"]', timeout=5000)
        await more_button.click()
        await page.wait_for_timeout(2000)  # small delay to load next batch
    except TimeoutError:
        break
该循环会尝试查找并点击“显示更多航班”按钮,当按钮不再出现时(即表示所有结果已加载完毕)便退出循环。
步骤四:使用代理实现规模化
如果您打算频繁或大规模抓取 Google Flights 数据,就需要接入代理服务器以避免触发 IP 速率限制。Playwright 支持为每个浏览器上下文单独设置代理,使用轮换住宅代理服务(例如 MarsProxies 或类似服务),有助于将请求分散到不同的 IP 地址,防止 Google 识别并封锁您的爬虫。
步骤五:保存并分析数据
提取完成后,您可以将采集到的航班数据保存为文件(如 JSON、CSV 等)以供分析,例如将结果列表保存为 JSON 文件以便后续处理。拿到数据后,您可以分析价格趋势、将其导入数据库,或用于其他应用程序。
按照上述步骤,您实际上构建了一个模拟真实用户搜索行为并采集结果的 Google Flights 爬虫。不过要注意,抓取 Google Flights 这类复杂网站,需要谨慎处理动态内容和反机器人机制,这也正是接下来要讨论代理与 CAPTCHA 应对方法的原因。
2026 年稳定抓取 Google Flights 航班数据
获取住宅代理使用 API 获取 Google Flights 数据
如果编写完整的浏览器自动化程序听起来有些繁琐,或者您需要更快捷的方案,可以考虑使用第三方 API。虽然 Google 并未官方提供 Google Flights API,但已有多项服务将搜索抓取功能封装成 API:这些服务在后台完成浏览器模拟、代理管理和 CAPTCHA 识别等繁重工作,并将结构化数据直接返回给您。
一个常见的例子是SerpApi 的 Google Flights API,它支持查询 Google Flights 搜索结果并以 JSON 格式返回数据。
使用 API 的方式很简单:发送一个包含查询参数(如出发地、目的地、日期等)的 HTTP 请求,API 就会以 JSON 格式返回航班数据。下面是一个使用 SerpApi 的 Python 简单示例:
import requests
params = {
    "engine": "google_flights",
    "q": "Flights from NYC to LON, one-way, 2025-12-25",  # search query or use departure/arrival codes
    "api_key": "YOUR_SERPAPI_API_KEY"
}
response = requests.get("https://serpapi.com/search", params=params)
data = response.json()
# Extract some information from the results
for flight in data.get("best_flights", []):
    airline = flight.get("airline")
    price = flight.get("price")
    print(airline, price)
在这段代码中,我们向 SerpApi 的端点发送了一个带查询参数的请求。SerpApi(及类似服务)会在内部完成 Google Flights 搜索,并返回结果。
通常,返回的 JSON 中会包含主要航班选项的结构(常见字段如 best_flights 或 other_flights),其中包括航空公司名称、价格、起降时间、时长、经停次数等详细信息。您只需解析这段 JSON 即可获取所需数据,无需自行处理页面导航或 HTML 解析。
使用数据抓取 API 的优势在于速度快、使用简单:只需几行代码,即可获得可直接使用的数据。这类 API 还会处理 IP 轮换,并稳定地从 Google Flights 中提取数据。例如,即便 Google 尝试拦截自动化查询,SerpApi 也能帮助您获取完整数据。
相应的代价是成本:这类 API 通常需要订阅或按请求付费,且每月查询次数可能受限。不过对许多项目而言,这种便利性是值得的,尤其是当您没有时间维护自定义爬虫时。
抓取 Google Flights 数据的无代码方案
不会编程也没关系,市面上有多种数据抓取工具,让您无需编写代码即可抓取 Google Flights 数据。Octoparse、ParseHub、Apify 等工具都提供了易于上手的界面,帮助您从网站中提取信息。
下面以 Octoparse 为例,介绍一种无代码的实现方式。
Octoparse 提供自动识别功能,甚至还针对 Google Flights 数据预置了专用模板。这意味着您只需将Octoparse 指向 Google Flights 的页面,它便会自动尝试识别票价、航空公司名称、时间等元素。
以下是简要的操作步骤:
- 输入 URL
启动 Octoparse(桌面应用或云平台),输入您想抓取的 Google Flights 结果页面 URL,可以是通用的 Google Flights 搜索页面,也可以是预先填好参数的具体搜索链接。启动任务后,Octoparse 会在其界面中加载该页面。
2. 自动识别并调整数据字段
Octoparse 通常能自动识别航班列表的重复模式,并提议相应的数据字段(如航空公司名称、价格、时长、经停次数)。您可以检查这些字段,并根据需要进行调整,例如如果还需要航班时长或经停次数,请确保已勾选相应字段。
Octoparse 支持您直接点击页面元素来采集数据,或在后台调整 CSS 选择器。网站的分页或滚动加载同样可以处理:它可能会自动应对无限滚动,您也可以将其配置为点击“加载更多”按钮(如果页面上存在该按钮)。
3. 运行爬虫
字段设置完成后,即可运行抓取任务。Octoparse 会依次浏览 Google Flights 的结果页面,抓取每条航班列表中的可用数据并进行汇总,您可以实时查看它逐页点击并采集信息的过程。
如果 Google 弹出 CAPTCHA 验证,部分无代码工具甚至能集成相应的绕过方案(例如 Octoparse 内置了 CAPTCHA 识别和 IP 轮换功能)。
4. 导出数据
运行完成后,您可以将抓取到的航班数据导出为 CSV、Excel、JSON 等格式,或直接导出到 Google Sheets,便于后续分析或导入数据库。
使用无代码工具对技术能力的要求很低,优势在于配置速度快,按照可视化向导操作,几分钟内便可得到结果。此外,这些平台通常还提供云端抓取选项,即抓取任务可在其服务器上完成,您无需担心 IP 被封(它们通常自带 IP 代理池)。
不足之处在于灵活性有限:您的能力会受到工具自身功能的制约。一旦 Google 调整网站结构,您可能需要重新配置爬虫,或等待工具提供商更新模板。
应对反爬虫机制
由于 Google 清楚有人可能会尝试自动化提取数据,Google Flights 设有相应的反爬虫机制。在抓取 Google Flights 数据时,尤其是大规模抓取,您可能会遇到 IP 封锁或 CAPTCHA 验证。以下是应对这些障碍的方法:
- IP 轮换与代理
同一 IP 地址频繁发送请求,很快会触发 Google 的防护机制(可能遭到封锁或弹出 CAPTCHA 验证)。使用轮换代理是避免被检测的关键。
代理网络会定期或按请求为您的爬虫分配新 IP,高质量的住宅代理是理想选择,因为它们通过真实消费者的网络连接传输流量,让您的请求看起来更接近普通用户的行为。
- 处理 CAPTCHA
如果 Google 怀疑存在机器人活动,可能会触发 reCAPTCHA 验证。人工解决 CAPTCHA 在大规模数据抓取中并不现实,因此需要相应的解决方案来处理这些验证。一种方法是接入第三方 CAPTCHA 破解服务(如 2Captcha、AntiCaptcha 等),这些服务可以付费识别图像或语音类型的 CAPTCHA。
使用 Playwright 或 Selenium 时,您也可以通过放慢操作速度、启用有头(非无头)模式,并使用恰当的 User-Agent 字符串使其看起来像真实浏览器,从而尝试规避 CAPTCHA 验证。
实际操作中,绕过反爬虫机制需要不断尝试和调整。建议先从小规模的抓取会话开始,观察是否被屏蔽,再据此调整策略:提高轮换频率、在操作之间加入随机等待时间,或接入可以自动处理这些问题的网络爬取工具或 API。
多数情况下,仅凭这两种简单的方法,就足以顺畅地抓取 Google Flights 数据,不会遇到烦人的中断。
扩展您的数据抓取规模:自研代码、API 与无代码方案对比
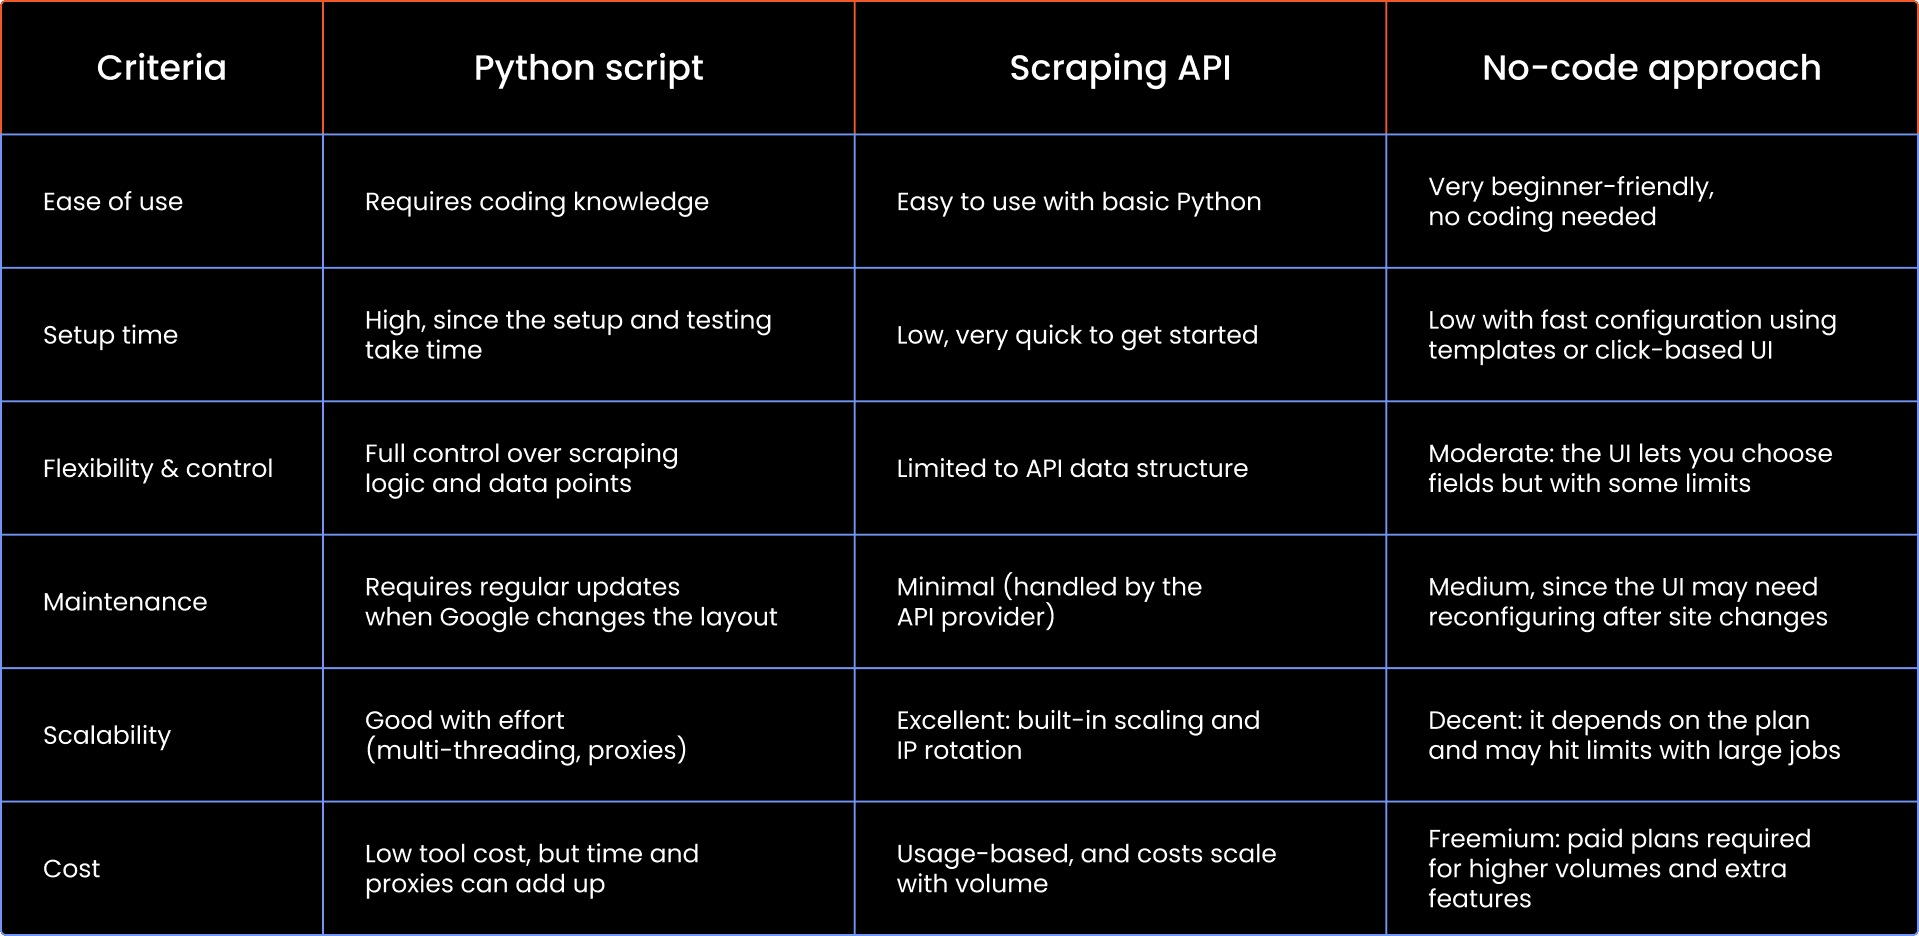
前面介绍了三种方法,它们各自表现如何呢?选择自己编写脚本、使用 API,还是采用无代码方案,取决于您的具体需求和资源情况。下面是一个简要对比:
结语
抓取 Google Flights 数据的理由有很多,从分析价格趋势、搭建比价聚合平台,到单纯寻找更优惠的机票。无论选择哪种抓取方式,合适的工具和稳健的策略都至关重要。别忘了加入我们的Discord 社区,与其他用户交流、获取技巧并分享经验!
抓取 Google Flights 数据是否合法?
抓取 Google Flights 上的公开数据可能违反 Google 的服务条款,但在大多数司法辖区并不违法。请务必查看相关网站的条款,并合理控制抓取行为(例如避免给服务器造成过大压力、合理控制请求频率等)。
适合抓取航班数据的工具有哪些?
编程实现:Python + Playwright;快速获取结果:SerpApi 等类似 API;无需编程:Octoparse 或 ParseHub。请根据自身技术水平和需求选择合适的方案。
抓取时如何应对 CAPTCHA 验证和 IP 封禁?
使用轮换代理可以避免 IP 被封禁,必要时还可借助 CAPTCHA 破解服务。许多 API 和高级无代码工具通常会自动处理这些问题。
可以抓取哪些航班详情数据?
几乎所有您需要的数据都可以获取:可以从 Google Flights 的搜索结果中抓取航空公司名称、航班号、价格、飞行时长、经停次数、起降时间等信息。