无头浏览器是什么?优势、使用场景与工具
无头浏览器是一种在后台运行、不显示可见窗口的浏览器,您可以借助 Selenium、Puppeteer、Playwright 等工具以无头模式控制浏览器,自动完成原本需要由真人手动操作的任务。
本文将介绍无头浏览器的工作原理,解释它在哪些任务中更受青睐,并展示 Selenium、Puppeteer、Playwright 等工具如何控制无头浏览器。
什么是无头浏览器?
提到“浏览器”,大多数人会想到 Chrome、Firefox、Safari,甚至 Brave 或 Opera。点击标签页,输入网址,页面便会显示——这是日常的浏览体验。
但这并不是浏览网页的唯一方式。
还有另一种浏览方式:安静、可控,专为希望从网络中获取更多价值的人而设计。您可能需要抓取商品信息、测试网站在不同地区用户面前的渲染效果,或是在每次部署后于 CI/CD 流水线中自动运行界面检查。
对于这类任务,无头浏览器正是适合的工具。
无头浏览器与常规浏览器对比
可视化界面
无可见窗口运行,在后台加载页面并执行 JavaScript
显示完整的浏览器窗口,包含标签页、菜单、页面内容、弹窗等可视化元素
速度
省去可视化界面,使浏览器自动化速度更快,但仍会加载资源并处理动态内容
更适合手动使用,但不适合需要反复执行或在后台运行的自动化任务
资源占用
更适合服务器环境、自动化测试、数据抓取、性能监控和生成 PDF,但仍比普通的 HTTP 请求更消耗资源
为呈现完整浏览体验而占用更多资源,适合真人直接操作浏览器的场景
调试
难以直接查看,通常需要借助截图、日志、追踪记录或保存的 HTML 才能了解运行情况
调试更便捷,因为您可以直接观察页面加载、检查元素并与网站交互
适用场景
适合跨浏览器测试、无头测试、数据抓取、浏览器自动化、渲染 JavaScript、监控页面及生成 PDF
更适合人工浏览、视觉检查、布局审查、交互测试以及排查自动化流程失败的问题
无头浏览器的工作原理
本质上,它仍是一个完整的浏览器:拥有相同的引擎、相同的执行逻辑,也能请求页面并与之交互,只是运行时没有图形用户界面——没有标签页,没有窗口,屏幕上什么都看不到。
无头浏览器完全通过代码运作,您可以在终端或脚本中对其进行控制,常用工具包括 Puppeteer、Playwright 或 Selenium:它会打开页面、点击按钮、执行 JavaScript,而这一切都发生在您看不到的地方。
这正是无头浏览器在浏览器自动化中威力巨大的原因:没有可视化开销,不会因渲染标签页而占用额外内存——只有速度与可控性。
尽管“看不见”,无头浏览器仍会完成常规浏览器的全部工作:下载资源、解析 HTML 和 CSS、发送 AJAX 请求,甚至构建完整的 DOM。
区别在于:除非您主动要求(例如截图或生成 PDF),否则无头浏览器不会进行任何可视化渲染。
这也让自动化更安全、更快速:没有图形界面意味着更少的系统依赖,使无头浏览器非常适合 Docker 容器、远程环境或大规模机器人部署。
为什么要使用无头浏览器?
人们选择无头浏览器的原因因需求而异:自动化工程师追求速度,QA 测试人员看重可重复性,SEO 从业者则想获取 Googlebot 能看到而真人看不到的数据洞察。
但无论您是哪一种角色,原因其实很简单:您需要的是常规浏览器无法提供的能力。接下来就来看看这种能力究竟是什么。
执行速度更快
日常浏览时,您需要完整的视觉体验;而在无头浏览器中,这恰恰是第一个被舍弃的部分——没有动画效果,没有屏幕渲染,只有代码在默默运行。
在无头模式下,浏览器省去多余环节、直接执行任务。无论使用 Selenium 还是 Puppeteer,脚本的运行速度都会因页面本身及其加载负担而有所提升。
您可以对数千个网址批量执行无头浏览器测试,或在云端部署浏览器自动化,无需承担完整图形桌面环境所需的 GPU 和内存开销,不过资源占用仍会随工作量和并发数增加而上升。
自动化
在无头浏览器模式下,脚本可以加载页面、填写表单、点击按钮、执行 JavaScript,而不会把资源浪费在图形绘制上。
这种更轻量的方式让浏览器自动化更快、更干净:依赖项越少,出现图形相关错误或时序问题的概率就越低。
这正是自动化工程师、网络安全专家和 DevOps 团队在搭建自动化测试或在 CI/CD 流水线中部署机器人时,更倾向于使用无头浏览器库的原因。
资源占用更低
您是否想过,为什么同时打开几十个标签页会让浏览器变得卡顿?这是因为每个页面并非静止不动,而是在持续渲染画面、占用内存并消耗 CPU 时间。
无头浏览器省去了这部分开销。
借助无头浏览器,脚本能够像常规浏览器一样加载页面并与之交互,却不必承担可视化渲染的开销——这意味着更低的内存占用、更小的 CPU 压力,以及更少的 GPU 资源浪费。
对数据抓取、浏览器自动化或无头测试而言,这种效率极具价值。无头浏览器工具让您无需高配置设备,也能同时运行数百项自动化测试。
无头浏览器的常见使用场景
在合适的场景下,无头浏览器的效率远高于常规浏览器:没有多余的渲染,也没有图形界面拖慢速度。但在实际应用中,这究竟意味着什么?这种效率又如何转化为实际成果?
无头自动化测试
每次点击网站上的按钮,背后都发生着许多事情:API 被调用、JavaScript 执行、DOM 元素随之响应。对开发者来说,仅仅构建这些功能还不够,还需要对其进行测试。而在发布周期紧张的情况下,依靠人工逐一测试每一项交互显然难以规模化。
这正是无头自动化测试发挥作用的地方:借助 Selenium、Playwright、Puppeteer 等无头浏览器工具,您可以编写测试脚本,模拟登录、提交表单、点击导航项等真实用户行为,并验证一切是否按预期运行。
由于无头浏览器无需“看见”界面,它们以无头模式运行,省去渲染环节,专注于逻辑本身。这不仅加快了自动化测试的速度、降低了内存占用,还能避免图形界面相关问题导致的测试结果不稳定。
无头浏览器测试已成为现代 CI/CD 流水线的核心环节之一,对于每周甚至每天都要提交代码的敏捷团队而言尤为重要。这套方案能提供一套快速、轻量且可靠的测试层。
数据抓取
如今,大多数企业都清楚自己所需的数据就在网上,难点在于如何获取这些数据。
您可能正盯着一份理想的商品列表、价格表或法律文件,却发现既没有 API,也没有导出按钮,更没有结构化数据——这时,数据抓取便派上用场。
而要做好这件事,往往需要借助无头浏览器。
原因在于:现代网站大量使用依赖 JavaScript 的框架,您想要的数据往往并不存在于原始 HTML 中,而是在页面完全渲染后才会显示出来,传统的抓取工具根本无法获取。
但 Puppeteer 这类无头浏览器工具可以做到:在无头模式下,它们像真实用户一样加载页面、等待数据出现,再将其提取出来。这使得以下操作成为可能:
- 使用来自公开渠道的真实最新数据训练 AI 模型
- 在不被察觉的情况下开展竞品监控
- 收集及时、相关且高度定制化的市场情报
无论是处理结构化列表,还是抓取登录墙背后的动态内容,无头浏览器都能在不产生任何可视化开销的前提下,为您提供所需的真实度与可控性。
性能监控
无论您是技术型 SEO 专家,还是单纯想深入了解网站性能的人,最有效的方法之一就是自行运行测试——不仅仅查看前端加载时间,而是借助 Puppeteer、Playwright 等无头工具深入分析真实的性能指标。
例如,您可能想测试以下指标:
- 首字节时间(服务器响应速度)
- 首次内容绘制(页面内容首次出现的时间)
- 可交互时间(页面能够响应点击的时间)
- 最大内容绘制(最大图片元素的加载时间)
- 第三方脚本的影响(广告、分析工具、聊天插件等)
- Core Web Vitals 综合指标
测试这些指标并不需要图形界面,您可以借助 Puppeteer 等工具启动无头模式的 Chrome。
无头浏览器让您能够以无头模式完整加载页面,包括全部 JavaScript、第三方资源和动态内容,效果与真实用户所见一致,却始终无需启动可见的浏览器窗口。这意味着您既能精准评估网站性能,又能让整个过程保持轻量且全自动化。
生成截图
需要截屏吗?如果只是偶尔截取几张,手动工具完全够用。但如果需要在多个设备或地区自动截取数百张截图,那么“无头浏览器”(headless browser)就是最佳解决方案。
Puppeteer、Playwright 等无头浏览器工具支持脚本化控制每一步:何时打开页面、等待什么元素加载、截取哪部分内容、以及保存图片的位置——全程以无头模式运行,无需启动可视化浏览器界面。
正因如此,开发团队常用无头浏览器来完成以下任务:
- 在移动端、平板和桌面端的不同视口下截取整页截图
- 借助代理监控落地页在全球各地的渲染效果
- 将产品页面存档,用于合规审查、审计或内容核验
- 每次代码推送后自动生成截图
与图形界面工具不同,无头浏览器即使面对 JavaScript 较重或加载较慢的页面,也能提供像素级精准的真实用户视图截图。您可以等待特定 DOM 元素出现、去除横幅或弹窗、或在截图前滚动页面。
这些无头浏览器使用场景的共同点是:都需要发送大量自动化请求。如果同一个 IP 发出的请求过多,网站会察觉异常,随之而来的就是 CAPTCHA 验证、封锁,甚至更严重的封禁。
这正是轮换住宅代理池的意义所在。它可以为每批请求分配不同的 IP 地址,使无头浏览器的流量更接近真实用户行为,也更难以预测。如果您还需要随时管理代理,我们的安卓代理服务器应用可以让您在手机上单击一键切换代理。
如果您的无头浏览器任务需要在短时间内访问成百上千个页面,这一点尤为重要。合理的代理配置能让任务运行得更顺畅、更快速、更不易被察觉。
常用的无头浏览器工具
在比较这些工具之前,我们先区分“浏览器”和“控制器”这两个概念。
无头浏览器指的是以无界面方式运行的浏览器本身,而 Playwright、Puppeteer、Selenium 等浏览器自动化工具则负责以无头或有界面模式控制这些浏览器。
下面来看看开发者、QA 测试人员和自动化工程师常用的几款可靠工具。
Puppeteer
简介
Puppeteer 是一个 Node.js 浏览器自动化库,支持用 JavaScript 或 TypeScript 控制 Chrome、Chromium 或 Firefox。
适用场景
适合以 Chrome 为主的 JavaScript 或 TypeScript 项目自动化。当您需要直接控制页面行为、网络请求、截图或 PDF 生成时,Puppeteer 是不错的选择。
优势
- 能很好地处理 JavaScript 渲染的页面
- 支持拦截和控制浏览器请求
- 可对基于 Chrome 的工作流进行精细控制
- 可在无头与有界面模式之间切换,便于调试
- 支持截图和 PDF 生成
局限
- 在 Python、Java 或 C# 项目中使用 Puppeteer 不够顺手
- 不太适合类似 Safari 的 WebKit 测试
适用情形
页面在 JavaScript 执行前几乎没有可用内容
这种情况常见于产品网格、控制台、搜索结果以及加载后才完成渲染的页面。此时应选用 Puppeteer,因为它可以等待渲染完成后再提取内容。
团队已经在用 Node.js 开发
如果您的爬虫其余部分用 JavaScript 或 TypeScript 编写,Puppeteer 可以让自动化层保持在同一技术栈中。
您主要关注 Chrome 浏览器
当工作流以 Chrome 为核心时,选择 Puppeteer,因为它能直接控制页面行为、网络请求和输出结果。
您需要精简浏览器加载的内容
Puppeteer 可以监听每个网络请求,并拦截那些消耗流量却对任务无实际帮助的请求。
输出结果需要是可视化的
这款无头浏览器默认支持截图和 PDF 生成,适合需要可视化输出的场景。
Playwright
简介
Playwright 是一种浏览器自动化框架,支持用 JavaScript、TypeScript、Python、Java 或 .NET/C# 以无头或有界面模式控制 Chromium、Firefox 和 WebKit。
适用场景
当您需要可靠的跨浏览器测试、跨编程语言的浏览器自动化,以及会话密集型工作流时,Playwright 是更合适的选择。
优势
- 会自动等待元素加载完成后再进行交互
- 得益于浏览器上下文(browser contexts)功能,Playwright 可以隔离 Cookie、存储和会话,而无需每次都启动新浏览器
- Playwright 提供多种调试工具,如测试追踪、截图、视频和测试报告
局限
- 对于简单的数据抓取任务来说可能显得过于复杂
适用情形
团队使用多种编程语言
Playwright 支持 JavaScript、TypeScript、Python、Java 和 C# 等多种工作流。
正在 CI/CD 中构建自动化测试
Playwright 具备可重复执行的浏览器测试功能,非常适合在每次部署后检查用户流程的团队。
需要进行会话隔离
浏览器上下文功能可以更轻松地隔离 Cookie、存储和会话,而无需每次都启动全新浏览器。
正在抓取或测试动态页面
相比基于固定等待的简单脚本,Playwright 能更可靠地等待元素、页面跳转和网络请求完成。
需要基于代理的地理定位测试
当您需要测试页面在不同地区的渲染效果,同时保持浏览器会话井然有序时,这款工具非常合适。
Selenium
简介
Selenium 是一种通过 WebDriver 控制真实浏览器的浏览器自动化框架。WebDriver 是一套标准接口,让代码能够向浏览器发送指令,例如打开页面、点击元素、填写表单或检查屏幕显示内容。
适用场景
如果您的项目已依赖 WebDriver,Selenium 是合适的选择,因为它提供了一套跨语言、跨设备、跨浏览器环境控制浏览器的标准方式。这使它在老旧 QA 系统、分布式测试环境以及超出简单 Chrome 工作流的浏览器覆盖需求中格外实用。
优势
- 适配传统及企业级 QA 技术栈
- 支持 Java、Python、C#、JavaScript、Ruby 和 Kotlin
- 基于标准化的 WebDriver 模型
局限
- 相比多数无头浏览器方案更为笨重
- 网络请求检查不如 Puppeteer 或 Playwright 直观
适用情形
公司已有 Selenium 测试体系
它能让您继续沿用团队现有的自动化体系
QA 团队使用 Java、Python、C#、Ruby 或混合技术栈
Selenium 支持多种编程语言,不同团队无需切换技术栈即可使用
需要在远程浏览器设备上运行测试
Selenium Grid 可以将浏览器测试分发到不同的设备和环境中执行
需要兼容 WebDriver
Selenium 构建在 WebDriver 之上,这是通过代码控制浏览器的标准接口
目标是维护企业级浏览器自动化,而非从零搭建小型爬虫
相比轻量级的纯抓取工作流,Selenium 更适合长期运行的 QA 系统
HtmlUnit
简介
HtmlUnit 是一个基于 Java 的浏览器模拟器,无需打开真实浏览器即可加载页面、提交表单、管理 Cookie,并运行部分 JavaScript。关键在于,它并不像 Chrome、Firefox 或 WebKit 那样进行真实渲染,这也是它在某些任务上表现出色、而在另一些任务上力不从心的原因。
适用场景
当目标页面足够简单、不需要真实浏览器渲染时,这款模拟器就能派上用场。
优势
- 专为 Java 程序设计
- 适合简单自动化任务,如打开页面、查找表单、填写输入项
- 能处理部分由 JavaScript 驱动的模型
局限
- 并非真正的渲染浏览器
- 应对现代重度 JavaScript 应用时可能力不从心
- 不适合大规模网络爬取
- 默认不提供可视化输出
适用情形
正在处理静态页面
如果数据存在于 HTML 中,HtmlUnit 无需启动 Chrome 或其他完整浏览器,就能抓取页面并提取所需内容。
正在 Java 项目中测试简单表单
HtmlUnit 可以在同一套 Java 技术栈中加载页面、填写字段、提交表单并检查结果。
需要快速进行冒烟测试
如果您只是需要验证页面能否加载、链接是否有效、表单是否正常响应,HtmlUnit 比启动完整的无头浏览器更快捷。
正在对内部页面进行网络爬取
对于简单的管理后台、文档页面或服务端渲染的内部工具,HtmlUnit 可以在不进行可视化渲染的情况下浏览链接并提取内容。
如何实现无头浏览
理论讲得够多了,是时候动手实践了。如果您想认真实践无头浏览,下一步就是找到适合自己工作流的工具。
想要完全掌控 Chrome 并进行简单脚本编写?我们将带您了解 Puppeteer。需要在 Chrome、Firefox 和 Safari 之间灵活切换进行无头测试?我们会展示 Playwright 如何干净利落地完成这项工作。更偏好经过充分验证、支持多种语言和复杂无头自动化的工具?Selenium 同样为您准备好了。
配置 Puppeteer
按照以下简单步骤配置 Puppeteer 并运行一个基础脚本:
第一步:安装 Puppeteer
开始无头浏览并不需要手动安装 Chrome。Puppeteer 已经内置了与 Chrome 兼容的 Chromium 版本——这是 Chrome 背后的开源引擎。您只需打开终端,执行一条命令即可。命令如下:
npm install puppeteer
如果 PowerShell 或终端提示 “npm” 无法识别,不用担心,这只说明需要先安装 Node.js。从官方网站下载 Node.js 并安装,然后重新执行该命令。
安装好 Node 和 npm 后,您就可以在无头模式下启动 Chrome,用于数据抓取、自动化脚本,或是干净利落地执行 CI/CD 流水线任务。
第二步:编写一个基础脚本
我们从一个简单实用的例子开始:以无头模式启动 Chrome,访问 Wikipedia 首页,并打印页面标题。这是您首次真正体验无头自动化与无头浏览的实际效果。
打开您常用的代码编辑器(本文使用 Visual Studio Code),新建一个 JavaScript 文件,然后执行以下代码:
const puppeteer = require('puppeteer');

(async () => {
    const browser = await puppeteer.launch(); // Headless by default

    const page = await browser.newPage();

    await page.goto('https://www.wikipedia.org/');

    const title = await page.title();

    console.log('Page title:', title);

    await browser.close();

})();
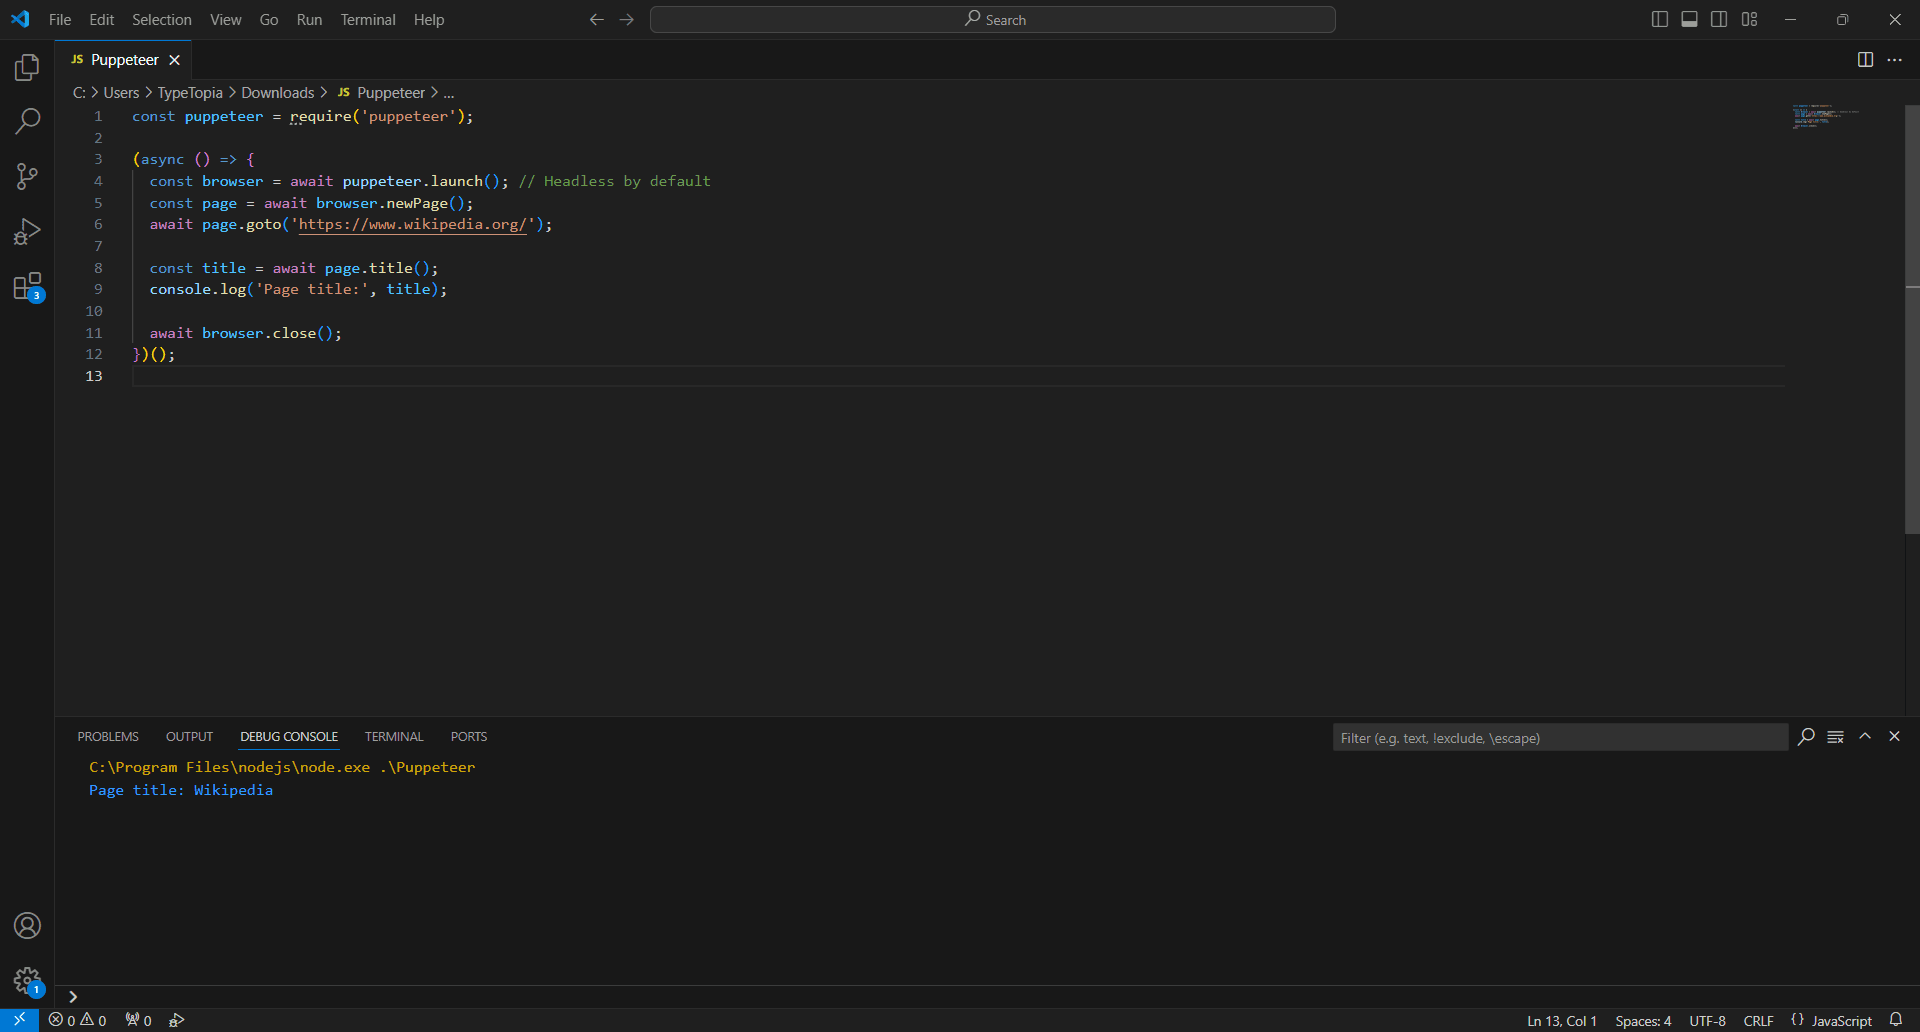
这样,真正的自动化基础就搭建完成了,接下来您可以让脚本按需求自由扩展。
配置 Playwright
既然您已经看到 Puppeteer 的使用有多简单,接下来我们再进一步。Playwright 能让您对不同浏览器实现更精细的控制,配置起来同样简单,操作如下:
第一步:安装 Playwright
打开终端,执行以下命令:
npm install -D @playwright/test
Playwright 是一个 Node.js 库,需要在 Node.js 环境中运行。如果您的设备尚未安装 Node.js,npm install -D @playwright/test 命令将无法执行,因为 npm(Node Package Manager)是随 Node.js 一同安装的。
您可以前往 nodejs.org 直接获取。安装好 Node 和 npm 后,Playwright 便可顺利安装。
第二步:安装浏览器
由于 Playwright 支持 Chromium、Firefox、WebKit 三大引擎,您可以通过一条命令分别安装这些浏览器,非常简便。在终端中执行:
npx playwright install
第三步:编写您的第一个脚本
和 Puppeteer 示例一样,我们从一个简单的 Playwright 脚本开始:打开一个无头浏览器,访问 Wikipedia,并输出页面标题。
打开您常用的代码编辑器(推荐使用 Visual Studio Code),新建一个 JavaScript 文件,粘贴以下代码:
const { chromium } = require('playwright');

(async () => {
     const browser = await chromium.launch(); // Launches headless Chrome by default

     const page = await browser.newPage();
     await page.goto('https://www.wikipedia.org/');

     const title = await page.title();

     console.log('Page title:', title);

     await browser.close();
})();
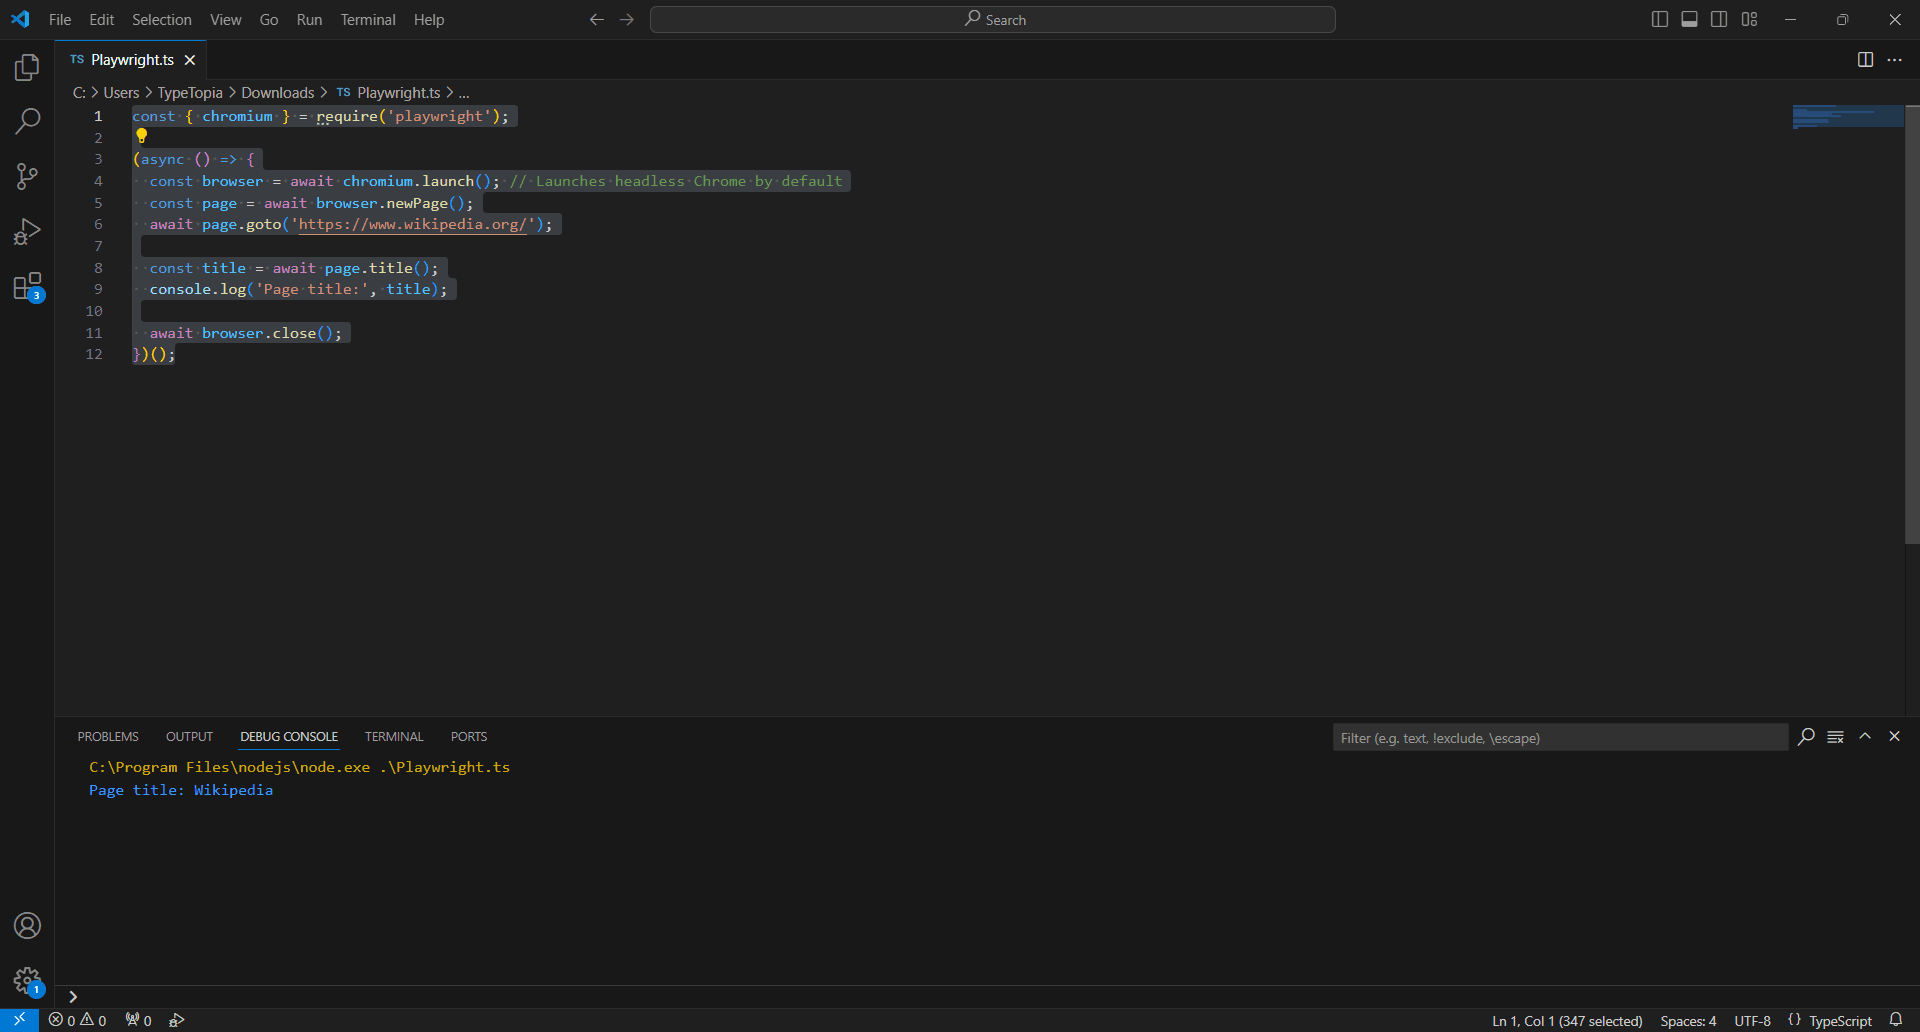
完成基础配置后,您可以根据自己的工作流程和使用场景自由修改脚本。
配置 Selenium
虽然 Selenium 并非最轻量的方案,但当您的无头测试或自动化需求需要覆盖多种浏览器、运行环境和编程语言时,它依然是值得信赖的选择。
以下是让 Selenium 支持无头浏览器测试的简单步骤:
第一步:安装 Selenium
Selenium 的安装方式因所使用的编程语言而异。Java、Python、C# 和 Ruby 各自略有不同。为简单统一起见,本文将使用 JavaScript。
这样既能保持内容简洁,又能与本文示例保持一致。要为 JavaScript 安装 Selenium,请在终端中执行:
npm install selenium-webdriver
完成后,您的 Selenium 工具链便已准备就绪,可用于在真实网站上进行无头浏览器测试。
第二步:下载浏览器驱动
有一点 Selenium 并不会帮您做:它不会内置浏览器引擎。
这与 Puppeteer 或 Playwright 等自带 Chromium 的工具形成了明显对比。使用 Selenium 时,您需要手动下载与已安装浏览器版本匹配的驱动程序。
由于本次自动化配置使用的是 Chrome,我们将使用 ChromeDriver。
请前往ChromeDriver 官方下载页面,选择与您系统中 Chrome 版本匹配的驱动。如果不确定当前 Chrome 的版本,打开 Chrome 并输入:
chrome://settings/help
下载正确的驱动后,解压文件夹,您会看到一个名为 chromedriver.exe 的文件。
除非您打算在多个项目中频繁复用,否则无需将其添加到系统 PATH 中。为简化操作,只需将 chromedriver.exe 文件放入 Selenium 测试脚本所在的同一文件夹即可,这样代码便能直接找到并启动它,无需额外配置。
这是个小细节,但能避免版本冲突问题,让无头浏览器测试流程更加顺畅。
第三步:将 Selenium 指向 ChromeDriver 可执行文件
最后把这些步骤整合起来。安装好 Selenium 并下载好 ChromeDriver 后,就可以开始测试了。
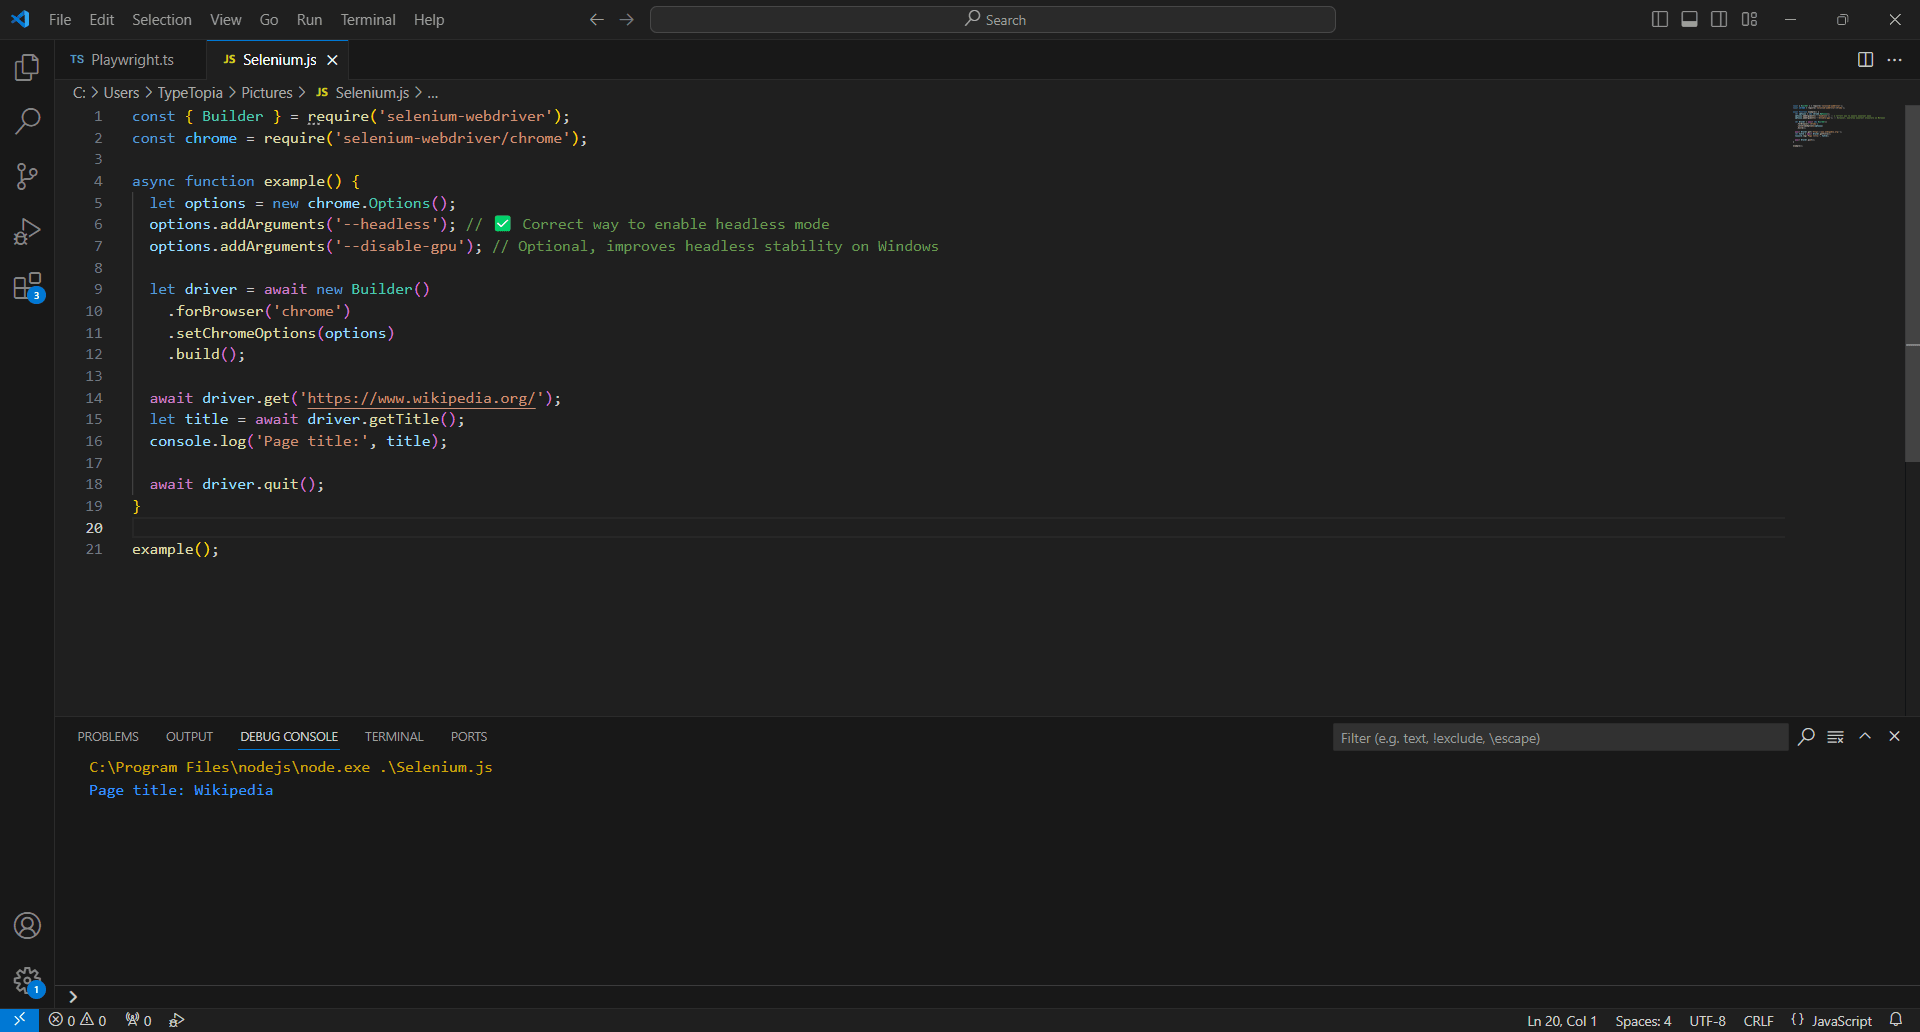
以下是使用 Selenium 在 JavaScript 中运行无头 Chrome 的简单脚本:
const { Builder } = require('selenium-webdriver');
const chrome = require('selenium-webdriver/chrome');

async function example() {
  let options = new chrome.Options();
  options.addArguments('--headless'); // Correct way to enable headless mode
  options.addArguments('--disable-gpu'); // Optional, improves headless stability on Windows

  let driver = await new Builder()
    .forBrowser('chrome')
    .setChromeOptions(options)
    .build();

  await driver.get('https://www.wikipedia.org/');
  let title = await driver.getTitle();
  console.log('Page title:', title);

  await driver.quit();
}

expample();
无头浏览器最佳实践
一些隐藏的坑可能会迅速打乱您的无头浏览工作流程。以下最佳实践可帮助您避开常见陷阱,充分发挥无头浏览器库的作用。
谨慎处理 JavaScript 渲染
如果您曾用网络爬虫或抓取工具访问某个页面,结果只得到一个没有数据的空壳页面,这并非脚本出错,而是 JavaScript 在作怪。
现代网站不再一次性加载全部内容。首次加载的往往只是一个基础框架,真正的数据内容是在此之后由 JavaScript 触发加载的。因此,如果您的无头浏览器过早开始抓取,将完全错过这些数据。
根据所使用的浏览器不同,以下是避免此问题的方法:
Puppeteer
Puppeteer 并不“知道”页面何时渲染完您需要的数据。它只能识别页面在技术层面是否加载完成(load、domcontentloaded 事件),却无法判断那些异步 JavaScript 是否已经渲染出您真正关心的内容。
如果您在进行用于数据抓取、测试或 CI/CD 流程的浏览器自动化,这个时间差就至关重要。
幸运的是,Puppeteer 让您能完全掌控这段等待时间。您可以使用 waitForSelector() 等待特定元素出现,也可以用 waitForNetworkIdle 等到浏览器停止发出请求为止,甚至还可以用 waitForTimeout() 自定义延迟时间。
这并非“智能”等待,但足够精确:您来决定页面何时就绪,Puppeteer 则按您的指令执行。
Playwright
与需要您自行定义等待条件的 Puppeteer 不同,Playwright 默认内置了这套逻辑。它不会在脚本执行后就直接默认页面已就绪,而是会自动等到 DOM 稳定或关键元素出现为止。除非您手动覆盖该设置,否则 Playwright 已经在为您执行智能等待。
Selenium
使用 Selenium 时,时间控制需要您自己负责。与会等待 DOM 稳定的 Playwright,或能直接使用 waitForSelector() 等简洁等待方法的 Puppeteer 不同,Selenium 要求您自行判断内容何时出现,并围绕这一点构建自己的等待逻辑。
这通常意味着需要引入额外的等待库、定义全局策略,或在脚本中大量使用 try/catch 代码块以避免脆弱的执行失败。这些操作都不算直观,如果您在大规模进行浏览器自动化,很容易在某个环节出现疏漏。
轮换代理以避免被检测
即便是适合用于无头浏览的代理库,也无法摆脱 IP 被封禁的风险。
一旦您开始大规模使用浏览器自动化,尤其是用于网络爬取或自动化脚本,就会对网站的防护机制造成压力,而大多数网站都早有防备。若用单个 IP 向其发送大量请求,便会触发速率限制、被判定为机器人,甚至彻底被拉黑。如果您的目标是多账户管理或修改浏览器指纹特征,而非单纯的自动化,反检测浏览器可能更适合您——可查看我们整理的反检测浏览器对比,挑选适合自己的方案。
代理能很好地解决这一问题。借助住宅轮换代理池,您的无头浏览流量不会显得突兀:每隔几次请求,IP 就会发生变化,从外部来看,这就像是一群普通用户产生的正常流量,而非机器人农场。
如果您想在 Chrome 中快速管理代理,又不想修改系统设置,MarsProxies Chrome 扩展程序可让您一键切换代理。
接下来,我们看看如何在前面提到的各个工具中配置代理:
Puppeteer
在 Puppeteer 中配置代理非常简单:只需在启动无头 Chrome 时传入代理服务器参数,再用 page.authenticate() 处理认证信息即可。
代码如下:
const puppeteer = require('puppeteer');

(async () => {
  const browser = await puppeteer.launch({
    headless: true,
    args: ['--proxy-server=http://ultra.marsproxies.com:44443']
  });

  const page = await browser.newPage();
  await page.authenticate({
    username: 'mr45184psO8',
    password: 'MKRYlpZgSa_country-us_city-miami_session-iuzoneff_lifetime-30m'
  });

  await page.goto('https://httpbin.org/ip');
  console.log(await page.content());
  await browser.close();
})();
即使是 HTTPS 网站,也请使用“http://”,Puppeteer 会在后台自动处理SSL。另外,请确保在 newPage() 之后立即调用 page.authenticate(),以避免出现 407 错误。
Playwright
与将代理绑定到整个浏览器实例的 Puppeteer 不同,Playwright 允许您按浏览器甚至按上下文分别设置代理。如果您需要在同一个无头浏览器会话中切换多个代理身份,这会非常实用。
实际使用方式如下:
const { chromium } = require('playwright');
(async () => {
  const browser = await chromium.launch({
    proxy: {
      server: 'http://ultra.marsproxies.com:44443',
      username: 'mr45184psO8',
      password: 'MKRYlpZgSa_country-us_city-miami_session-iuzoneff_lifetime-30m'
    }
  });
  const page = await browser.newPage();
  await page.goto('https://httpbin.org/ip');
  console.log(await page.content());
  await browser.close();
})();
Selenium
Selenium 在代理认证方面并不友好。虽然它可以通过 Chrome 启动参数正常处理基础的代理路由,但完全不支持需要用户名和密码的代理。
解决办法是:在代理端将您的 IP 加入白名单。完成后,就无需再传入认证信息,可以直接将代理地址传给无头 Chrome 启动配置,如下所示:
const { Builder } = require('selenium-webdriver');
const chrome = require('selenium-webdriver/chrome');
(async () => {
  const proxy = 'http://ultra.marsproxies.com:44443';

  const options = new chrome.Options();

  options.addArguments(`--proxy-server=${proxy}`);
  const driver = await new Builder()
    .forBrowser('chrome')
    .setChromeOptions(options)
    .build();
  await driver.get('https://httpbin.org/ip');

  console.log(await driver.getPageSource());
  await driver.quit();
})();
管理超时与延迟
如果您的数据抓取脚本在点击、滚动、提交等操作上都以机器般的速度执行,很容易显得十分突兀。因此,加入简短、自然的延迟是明智的做法。
以下是如何将延迟与超时设置和代理配合使用,以避免被检测:
Puppeteer
以下代码展示了如何将超时设置与代理配合使用:
const puppeteer = require('puppeteer');

// Helper function for delay
function delay(time) {
  return new Promise(function(resolve) {
    setTimeout(resolve, time);
  });
}
(async () => {
  const browser = await puppeteer.launch({
    headless: true,
    args: ['--proxy-server=http://ultra.marsproxies.com:44443']
  });
  const page = await browser.newPage();

  // Authenticate to the proxy server
  await page.authenticate({
    username: 'mr45184psO8',
    password: 'MKRYlpZgSa_country-us_city-miami_session-iuzoneff_lifetime-30m'
  });

  // Go to the target page
  await page.goto('https://httpbin.org/ip', {
    waitUntil: 'networkidle2', // Wait until all network activity stops
    timeout: 30000             // 30-second timeout for loading
  });
  // Introduce a delay to mimic human-like behavior
  await delay(2000); // Wait 2 seconds
  // Extract and print page content
  const content = await page.content();

  console.log(content);

  await browser.close();
})();
page.goto() 中的 timeout 选项可确保脚本不会无限等待:如果页面在 30 秒内未加载完成,Puppeteer 会报错退出。
waitUntil: 'networkidle2' 条件会让 Puppeteer 一直等到页面停止发出网络请求为止,这对动态网站尤其有用。
随后,自定义的 delay() 函数会在与页面内容交互前加入 2 秒的停顿。这种停顿能使行为更接近真人操作,有助于在数据抓取或无头浏览器测试过程中避免被检测。
Playwright
使用以下脚本可在 Playwright 中实现超时设置:
const { chromium } = require('playwright');

// Helper delay function
function delay(time) {
  return new Promise(resolve => setTimeout(resolve, time));
}
(async () => {
  const browser = await chromium.launch({
    proxy: {
      server: 'http://ultra.marsproxies.com:44443',
      username: 'mr45184psO8',
      password: 'MKRYlpZgSa_country-us_city-miami_session-iuzoneff_lifetime-30m'
    }
  });
  const context = await browser.newContext();
  const page = await context.newPage();

  // Set navigation timeout to 30 seconds
  page.setDefaultNavigationTimeout(30000);
  // Go to the target page
  await page.goto('https://httpbin.org/ip', {
    waitUntil: 'networkidle' // Wait for no ongoing network requests
  });
  // Introduce a short delay to mimic human behavior
  await delay(2000); // 2-second pause
  const content = await page.content();

  console.log(content);
  await browser.close();
})();
我们将代理认证、超时设置与延迟注入结合起来,以控制浏览器自动化的节奏和行为。setDefaultNavigationTimeout(30000) 这一行代码可确保任何导航操作(例如 goto)如果耗时超过 30 秒,就会被中止。
这能防止脚本在加载缓慢的页面上卡死。waitUntil: 'networkidle' 条件会一直等到没有活跃网络连接为止,因此对异步加载内容的页面非常可靠。
最后,delay() 函数会加入 2 秒的停顿,用以模拟真实用户在操作之间的停顿。在存在反机器人防护的网站上进行数据抓取或自动化脚本操作时,这种节奏控制尤其有用,因为它能让您的流量看起来更接近真实用户行为。
Selenium
Selenium 在超时与等待处理上不如 Puppeteer 或 Playwright 这类无头浏览器库那样顺畅。在 Selenium 中,您需要分别管理 pageLoad、script、implicit 等多种超时类型,而且它们的表现并不总是可预测。
下面是这段脚本的 JavaScript 版本:
const { Builder, By, until } = require('selenium-webdriver');
const chrome = require('selenium-webdriver/chrome');

// Helper delay function
function delay(time) {
  return new Promise(resolve => setTimeout(resolve, time));
}

(async () => {
  const proxy = 'http://ultra.marsproxies.com:44443';
  const options = new chrome.Options();

  options.addArguments(`--proxy-server=${proxy}`);
  const driver = await new Builder()
    .forBrowser('chrome')
    .setChromeOptions(options)
    .build();
  try {
    // Set a 30-second timeout for page loads
    await driver.manage().setTimeouts({ pageLoad: 30000 });
    // Navigate to the page
    await driver.get('https://httpbin.org/ip');
    // Optional: Wait for a specific element to appear (if needed)
    await driver.wait(until.elementLocated(By.css('body')), 10000);
    // Wait 2 seconds to mimic human behavior
    await delay(2000);

    const content = await driver.getPageSource();
    console.log(content);
  } finally {
    await driver.quit();
  }
})();
这段 Selenium 脚本通过代理服务器运行无头 Chrome 浏览器,并同时设置了页面加载超时和人为延迟,以使行为更接近真人。脚本首先通过 Chrome 选项配置代理,然后设置 30 秒超时,确保页面不会无限挂起。
结论
如果您一路读到这里,那真得为您鼓掌——您现在已经对无头浏览器了如指掌。本文带您了解了无头浏览器的工作原理、Puppeteer 与 Playwright 等工具的对比,以及在机器人承担主要工作时,如何借助住宅代理保持不被检测。
另外,别忘了查看我们的IXBrowser 集成指南。
您已经见识过其中的优点(速度快)、缺点(身份验证繁琐)和痛点(Selenium 的超时问题)。但现在,您已经掌握了应对之道。愿您的脚本一次通过、代理始终未被封禁、DOM 等待永不超时。加油,开发者,您能做到。
什么是无头浏览器测试?
无头浏览器测试是指在不打开可见浏览器窗口的情况下运行自动化浏览器测试。Selenium、Puppeteer、Playwright 等工具可以在无头模式下控制浏览器,在后台测试页面行为。
无头浏览器比常规浏览器更快吗?
速度差异主要取决于页面和具体工作流程。但理论上,由于无需渲染完整的可视化界面,无头浏览器在自动化场景中速度更快。它仍会加载资源、执行 JavaScript,并在后台处理动态内容。
无头浏览器能被检测到吗?
可以,网站能够检测到无头浏览器,尤其是在 Selenium、Puppeteer 或 Playwright 等自动化工具控制浏览器的情况下。检测系统可能会寻找浏览器环境中的细微信号,例如 navigator.webdriver 属性、缺失或异常的浏览器功能、canvas 输出、WebGL 表现、GPU 信息、IP 信誉、请求时间间隔以及会话模式。
哪种无头浏览器工具适合用于测试?
Playwright 适合用于测试,因为它能更好地解决现代测试中常见的复杂问题。Selenium 和 Puppeteer 同样可以打开并控制无头浏览器,但 Playwright 在动态页面、浏览器上下文、多种浏览器引擎、等待机制以及基于代理的工作流程方面,提供更简洁的配置方式。
什么时候应该使用常规浏览器而非无头模式?
当您需要实际查看屏幕上的操作情况时,应使用常规浏览器而非无头模式。例如调试失败的脚本、检查页面布局、识别弹窗或 CAPTCHA,以及测试可视化行为。