Twitter(现已更名为 X)依然是获取对话、趋势、观点和品牌信号的有效来源,但大规模采集数据远比发送几个请求复杂。本文将介绍什么是数据抓取 API、它与官方 Twitter API 的区别、可供选择的工具,以及如何搭建一套 Twitter 数据抓取工作流程。
X 近年来收紧了访问限制和平台规则,而数据抓取 API 可以处理采集、代理、重试和结构化输出等环节,从而让 Twitter 数据抓取变得更简单。
什么是 Twitter 数据抓取 API?
数据抓取 API 是一种服务,让您的应用程序通过 API 端点请求公开的 X 页面或数据集,并获得结构化结果。一个好用的 Twitter 数据抓取工具应当能处理数据采集过程中的大部分环节。
您无需自行搭建基于浏览器的 Twitter 数据抓取工具,只需针对主页、帖子、搜索关键词或其他支持的输入类型发起请求,由服务商负责管理采集基础设施,并将可直接使用的数据提供给您。
两者的关键区别在于 API 的提供方式:官方 Twitter API 是面向开发者的接口,内置身份验证、权限管理和速率限制;而 Twitter 数据抓取服务则借助自身基础设施采集公开内容,再通过 API 将结果提供给用户。
当应用程序超出某个端点的限制或使用上限时,X 会返回 HTTP 429 响应。
常见的使用场景包括情感分析、市场调研、竞争对手监控、学术研究、趋势追踪,以及采集 Twitter 上的话题信号。借助不同的服务商,您可以抓取推文、主页、话题标签、媒体内容、回复、转发、浏览量以及粉丝数等数据。
配合 Python、JavaScript、数据库和数据管道使用时,结果通常以 JSON 格式提供;而导出为 CSV 和 Excel 格式,则便于将 Twitter 数据抓取所得的数据用于分析流程。
如何选择合适的 Twitter 数据抓取 API
不同的数据抓取工具在支持字段和处理规模上差异较大,订阅前请务必核实。
数据覆盖范围与支持类型
首先确定您需要哪些数据记录。明确范围后,Twitter 数据抓取的调度和审计都会更加容易,而完整的元数据也有助于验证抓取结果。
部分服务专注于主页和帖子数据,另一些则能够采集搜索结果、推文串、回复、粉丝、媒体内容或按日期筛选的结果。请务必核实具体字段和限制,不要假设所有服务商支持的 Twitter 数据都相同。
可扩展性与可靠性
测试阶段可能只需几百次请求,而生产环境中的 Twitter 数据抓取则可能涉及成千上万甚至数百万条结果。请关注并发控制、重试机制、代理基础设施以及明确的超时设置,可靠性至关重要,因为反复失败会带来额外的工程成本。
集成难易程度
您选择的 API 访问方式应当适配现有应用程序,且每次 API 调用都应得到清晰、可预期的结果。请关注是否提供 REST 端点、SDK、文档和可运行的代码示例,由于 Python 只需少量代码即可完成数据采集和存储,因此被广泛使用。
导出格式与价格
请按照对您而言重要的计价单位(例如请求次数、结果条数、API 额度或算力)来比较价格。Scrapingdog 的 Twitter 端点每次请求收费 5 个额度,而 Bright Data 每月提供 5,000 条免费数据,按量计费价格为每 1,000 条记录 1.5 美元。
Apify 采用灵活的平台架构,提供包含 5 美元 Actor 使用额度的免费方案,单个数据抓取 Actor 则单独计价。同样,ScrapingBee 和 ScraperAPI 也采用基于额度的计费方式,并提供免费试用和多种付费档位。
法律、道德与合规方面的考量
公开并不代表可以不受限制地使用。X 现行的服务条款规定,未经明确书面许可,用户不得抓取其服务,同时也禁止在未获得单独授权的情况下,通过其公开接口以外的方式访问相关服务。
如果数据集中包含可识别个人身份的信息,还可能涉及隐私法规。在欧盟,GDPR 的核心原则包括合法性、目的限制、数据最小化、存储限制和问责制。
在进行 Twitter 数据抓取之前,应先查看平台条款、所在司法辖区的相关法律,以及您的具体使用目的。
常用的 Twitter 数据抓取 API
您需要的工具取决于数据类型、数据量以及基础设施需求;同时,所选的 Twitter 数据抓取工具也应与项目所需的速度和深度相匹配。
Scrapingdog
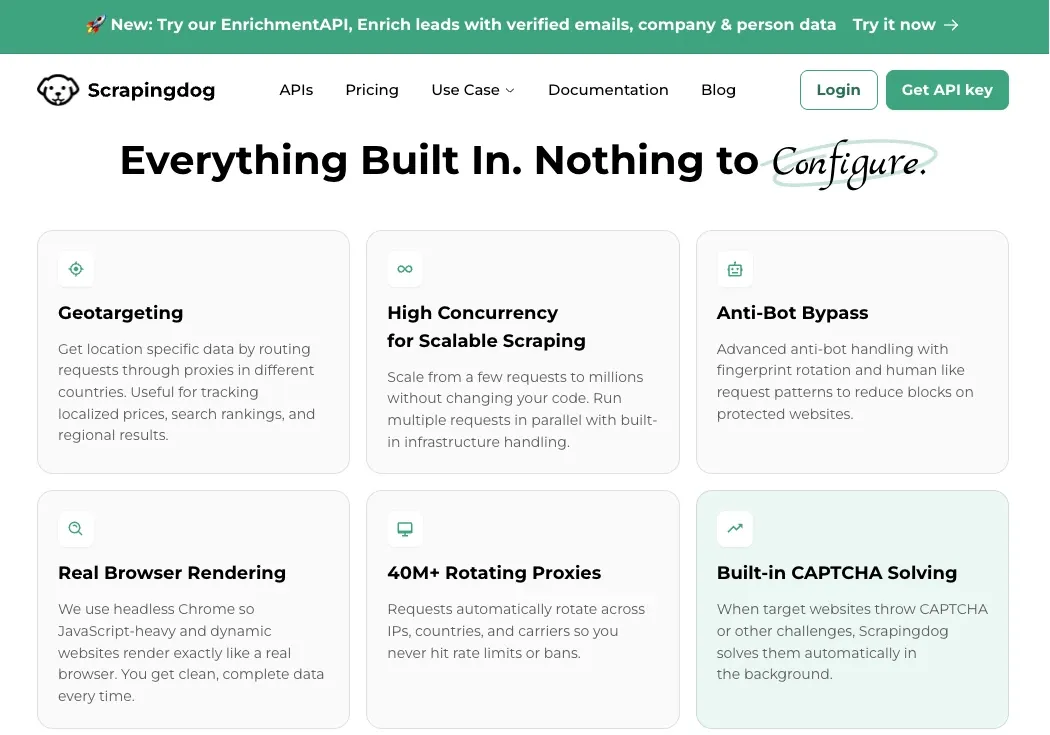
Scrapingdog 为主页和帖子提供专门的端点;根据其当前定价页面,Twitter 服务每次请求收费 5 个额度,但随着用量增加,实际单价会有所下降。
其突出优势在于配置简单,可以轻松嵌入简短的工作流程。Scrapingdog 提供免费套餐(100 次请求额度,不支持并发),Lite 方案(200,000 个额度,5 个并发)价格为 40 美元/月。
Bright Data
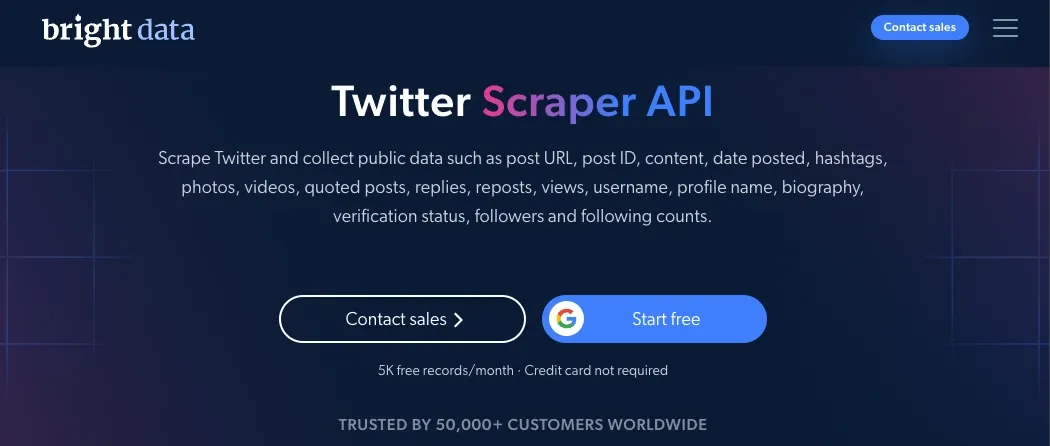
Bright Data 为帖子和主页提供专门的 X 数据抓取工具,支持字段包括帖子内容、话题标签、媒体内容、回复、转发、浏览量、主页详情和粉丝数。其定价页面目前显示每月提供 5,000 条免费数据,按量计费价格为每 1,000 条记录 1.5 美元。
它适合对并发能力和托管基础设施要求较高的大型工作流程,此时 Twitter 数据抓取工具能够实现良好的扩展。
Apify
Apify 是一个平台,而非单一的数据抓取工具,您可以在其中选择不同的 Twitter 数据抓取 Actor。价格因 Actor 和计费方式而异,Apify 还提供包含 5 美元使用额度的免费方案。
您可以测试具体实现、安排定时运行、使用 Webhook,并将结果对接到其他服务。Starter 方案价格为 19 美元/月(每个算力单位 0.2 美元),包含在线客服支持,以及 Apify 商店插件的折扣。
ScraperAPI
ScraperAPI 具备代理处理、自动重试和结构化数据输出等功能。其文档提供了用于搜索和采集推文级数据的结构化 Twitter 端点,输出结果为 JSON 而非原始 HTML,可以减少数据提取和推文数据标准化所需的工作量。
价格为 49 美元/月,可获得 100,000 个 API 额度,并提供免费额度和试用用于测试。该服务适合希望在同一方案中同时满足通用网络爬取与 Twitter 数据抓取需求的团队,也适用于需要抓取 Twitter 数据的多来源项目。
ScrapingBee
ScrapingBee 并非专为 Twitter 打造的产品,而是一种通用的网络爬取 API,提供代理轮换、JavaScript 渲染、自动重试和提取规则等功能,并能够返回结构化结果。
方案起价为 19 美元/月,可获得 75,000 个额度,并包含 1,000 个免费额度用于测试。如果 X 只是您工作流程中众多目标网站之一,使用 ScrapingBee 进行 Twitter 数据抓取是比较合理的选择,对于需要从多个域名抓取数据的团队同样适用。
如何使用 Twitter 数据抓取 API
一套 Twitter 数据抓取流程通常包括:
- 确定数据来源,例如主页、搜索关键词或帖子链接
- 发送请求
- 验证并标准化响应数据
- 存储结果
- 安排任务调度并监控错误
以下是一个通用的 Python 示例:
import os
import requests

API_KEY = os.environ["TWITTER_SCRAPER_API_KEY"]

params = {
    "api_key": API_KEY,
    "query": "web scraping",
    "num": 50,
}

response = requests.get(
    "https://example-scraper-api.com/twitter/search",
    params=params,
    timeout=30,
)

response.raise_for_status()
data = response.json()

for item in data.get("tweets", []):
    print(item.get("text"))
不同服务商的端点名称各不相同,请以最新的官方文档为准。您需要完成身份验证、请求特定的数据片段、校验其有效性,然后将 Twitter 数据提取到所需字段中。
在执行定时的 Twitter 数据抓取任务时,应加入分页和检查点机制;遇到临时性失败时使用指数退避策略,并留意 429 响应。当请求频率或发布次数超出限制时,X 平台会返回 429 响应代码。
代理也是该技术栈的一部分:托管式 Twitter 数据抓取工具可以内置代理,而自定义方案则可能使用轮换的住宅代理池。根据 MarsProxies 2026 年的指南,抓取 Twitter 时常用轮换住宅代理,它们并不能替代请求节奏控制或平台限制。
在更复杂的项目中,采集范围可能不止于帖子,还包括话题标签、推文串、媒体链接、回复链、主页和粉丝数据。Twitter 数据抓取工具可以对这些记录进行标准化处理,从而实现更全面的 Twitter 数据抓取。
随后,这些记录可以进入分析阶段。在为分析目的提取数据时,应对 ID、日期、作者字段和互动指标进行标准化处理,以便下游系统能够一致地比较这些记录。
2026 年抓取 Twitter 数据,不再被封锁
立即抓取常见误区及应对方法
这种情况很常见:当抓取工具开始出现故障时,您应检查 IP 的信誉、请求频率、会话行为,以及响应内容是否发生变化。
在抓取 Twitter 数据时,另一个常见问题是速率限制。配置得当的 Twitter 抓取工具应降低请求速度,而不是反复以最快速度发起请求:应放慢请求频率,在可用时遵循 retry-after 信号,并使用分页而非一次性发送大量请求。
不完整的数据更难察觉:即使某次 Twitter 数据抓取请求成功,返回的记录数也可能因为搜索条件变化、账号不可用或端点存在结果数量限制而减少,因此需要同时记录请求的数量与实际返回的数量。
持续抓取 Twitter 数据时,维护同样重要,因为 X 可能随时调整页面行为和访问要求;因此应持续监控响应数据结构,并在数据抓取过程中测试关键字段是否正常,同时对 Twitter 抓取工具进行版本管理。
最后,只采集真正需要的数据,并为涉及隐私的信息制定保留规则。
结论
数据抓取 API 可将抓取基础设施封装在标准 API 接口之后,从而简化公开数据的采集;关键在于根据数据覆盖范围、规模、集成需求和合规要求选择合适的供应商。
Scrapingdog、Bright Data、Apify、ScraperAPI 和 ScrapingBee 采用了不同的实现方式;在搭建长期工作流程之前,应比较各家的端点、计费方式、导出功能、稳定性与维护成本。
常见问题
使用数据抓取 API 是否合法?
合法性取决于所抓取的数据、所在司法辖区、使用目的以及平台的具体条款。X 当前的服务条款规定,除非获得书面明确授权,否则禁止抓取数据;而在处理个人数据时,还需遵守 GDPR 等隐私法规。
数据抓取 API 能提取哪些官方 API 无法获取的数据?
这取决于具体供应商提供的内容。部分供应商可提供公开页面信息,例如个人资料、推文、话题标签、回复、媒体内容、浏览量和粉丝数据,其数据格式或组合方式与官方 API 不同。
数据抓取 API 的费用是多少?
例如,Scrapingdog 每次请求消耗 5 个积分,Bright Data 每 1000 条记录收费 1.5 美元,ScraperAPI 起价为 49 美元/月,ScrapingBee 起价为 19 美元/月,Apify 的费用则因 Actor 而异。
能否通过数据抓取 API 抓取历史推文?
有时可以,但历史数据的覆盖范围取决于供应商、端点以及可用的源数据。在假设可以获取任意时间范围的数据之前,应先确认该抓取工具是否支持日期筛选、归档数据或基于搜索的采集方式。
如何将数据抓取 API 集成到数据管道中?
可将该 API 用作采集层:发送已认证的请求、对结果进行分页、校验并规范化响应数据、存储记录,然后设置定期运行计划并监控错误。可通过 Webhook 或批处理任务,将输出数据接入数据库和分析系统。