所有调用外部资源的 Python 应用程序都会面临服务器宕机的问题:如果应用程序用于获取数据的外部服务器出现故障,而您又没有设置 Python 请求超时参数,应用程序就可能因此卡死。
为避免这种情况,本文将介绍如何设置连接超时和读取超时,并处理可能出现的问题。读完本文后,您将了解超时错误的原理,以及在不同场景下应如何设置合适的超时值,以获得理想的性能表现。
如果您正在使用 Python 进行数据抓取,那么设置 Python 请求超时参数可以防止您的爬虫因某个无响应的服务器而卡住。
配置 Python 环境
要在应用程序中使用超时参数,您需要完成三项准备工作:首先,根据您的操作系统下载 Python并安装(如果尚未安装),然后安装 Python Requests 库。
打开终端,输入以下命令。
python -m pip install requests
如果您使用的是 Python 3,请改用以下命令。
python3 -m pip install requests
第三步是可选的,但我们建议您使用集成开发环境(IDE)编写代码,例如 Microsoft 的 Visual Studio Code,或专为 Python 设计的 PyCharm。
Python requests 库中的超时是什么
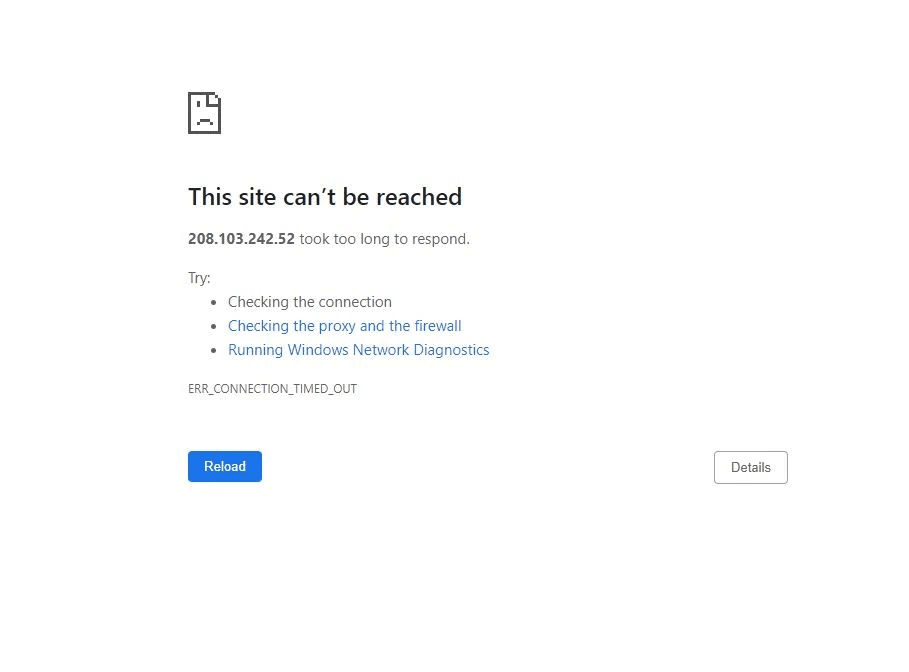
“连接超时”错误是连接超时的典型例子,它表示服务器未能响应您的浏览器。当浏览器与无响应的服务器通信一段时间后,就会提示超时错误。浏览器等待服务器响应的这段时间间隔,就是超时参数。
Python Requests 库支持设置两种超时参数:连接超时参数用于定义应用程序尝试连接服务器的最长时间,而读取超时则是应用程序等待服务器返回所请求数据的时间间隔。您也可以只设置一个超时参数,让它同时作为连接超时和读取超时的值。
如何在 Python Requests 库中设置超时
设置超时值能显著提升应用程序的性能:一方面,它可以快速提示您或用户连接出现了问题;另一方面,假如应用程序一直在循环尝试连接一个无响应的服务器,就会不断消耗设备资源(CPU 时间、网络套接字、已分配内存等)却徒劳无功。
在进行数据抓取时,处理连接超时错误尤为重要,因为您的应用程序需要访问数十个服务器。如果因某次连接失败而卡住,爬虫的运行速度就会变慢,抓取到的数据也会比预期少。
接下来,我们将演示如何使用 Visual Studio Code 为 GET HTTP 请求设置超时参数。首先,新建一个 Python 文件,并保存到您选择的位置,别忘了在文件名末尾加上 .py 扩展名,以确保在 Python 环境中执行。
在新打开的文件中,粘贴以下代码。
import requests
res = requests.get(
 "https://marsproxies.com/proxies/residential-proxies/",
timeout=10
)
print(res.text)
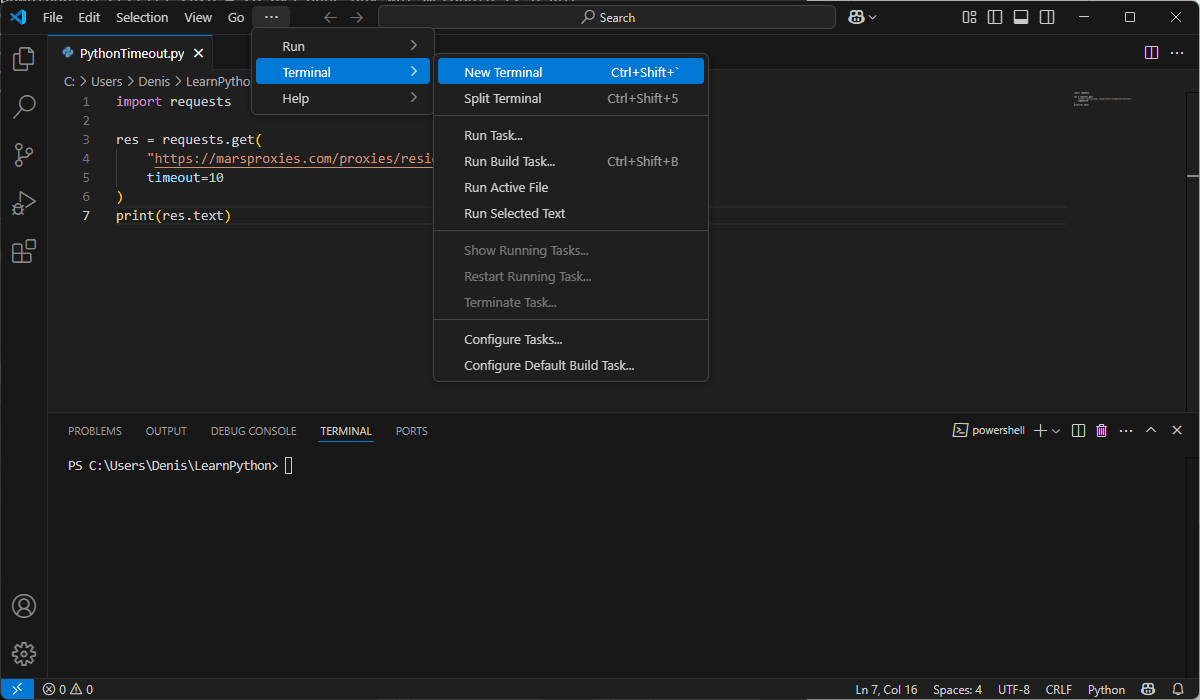
如果需要指定具体路径,请使用以下命令。假设您将文件保存在 C:\Users\Jane\LearnPython 目录下,则输入这行命令。
cd C:\Users\Jane\LearnPython
终端现在已经切换到您保存文件的目录,您可以使用以下命令执行代码。
Python filename.py
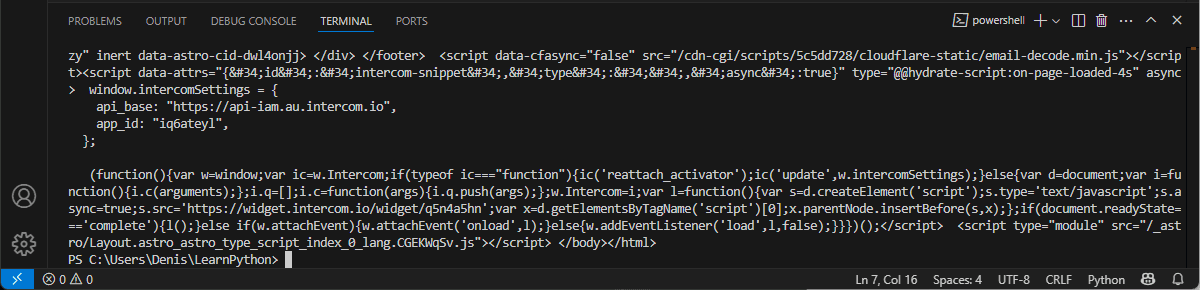
我们已经成功抓取了住宅代理落地页的完整 HTML 文档。现在让我们稍微调整一下,将 GET 请求的超时时间设置为极短的 0.001 秒。
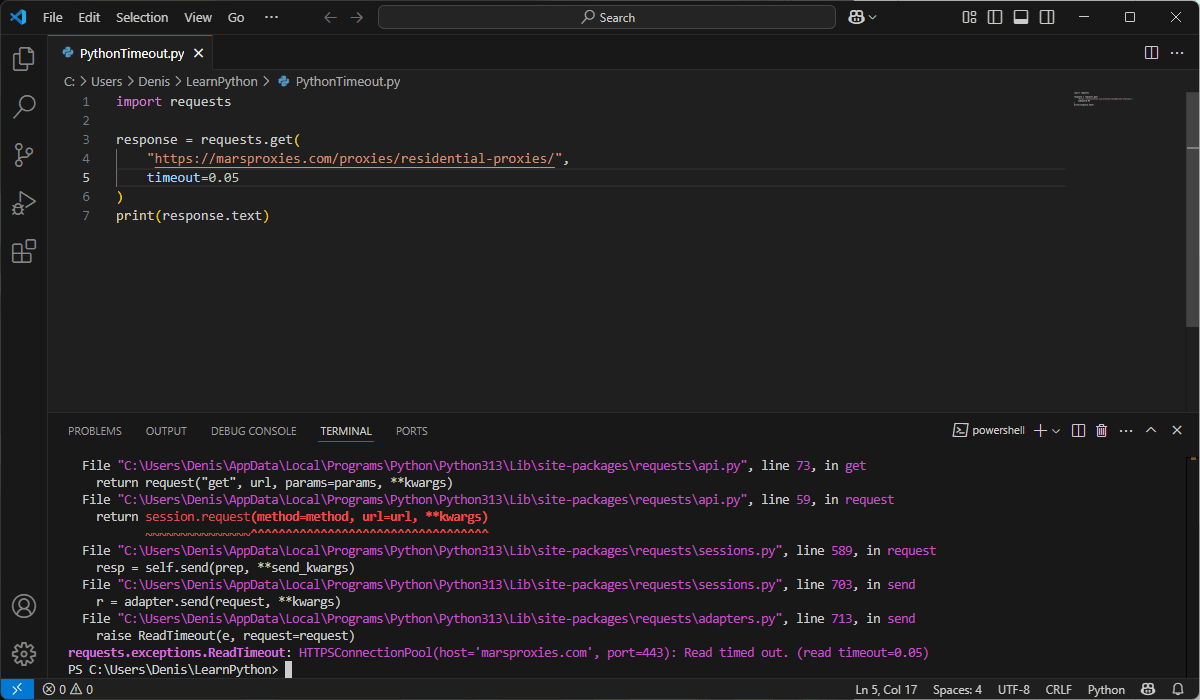
终端现在显示 readtimeout 错误
requests.exceptions.ReadTimeout: HTTPSConnectionPool(host='marsproxies.com', port=443): Read timed out. (read timeout=0.001)
虽然初始连接成功了,但 0.001 秒远远不足以从服务器抓取并返回所需的数据。这同时也说明,设置过短的超时时间并不可取,因为服务器根本来不及及时满足客户端的请求。
设置元组形式的超时值
大多数情况下,您需要同时设置连接超时和读取超时这两个值,以避免因参数设置不当而引发超时异常错误。
例如,您可能希望将连接超时设置得短一些,比如 1 到 3 秒,以避免应用程序反复尝试连接一个已离线的服务器。但对于需要收集在线数据的 HTTP 请求来说,几秒钟可能并不够用,尤其是当数据还包含图片和视频内容时。这种情况下,您可以用以下代码分别为这两种场景设置连接超时。
import requests
res = requests.get(
 "https://marsproxies.com/proxies/residential-proxies/",
   timeout=(1, 5)
)
print(res.text)
可以看到,Python 的语法让同时设置两种超时变得非常简单:只需在超时参数中填入连接和读取的值,并用逗号隔开即可。
请注意,超时值默认是未定义的,这意味着如果您不特意设置,应用程序在发送 GET、POST 等请求时会无限期地卡住。
处理 POST 请求
前面我们演示了如何为 GET HTTP 请求设置超时值,但实际上您也会经常用到 POST 请求,例如需要登录某个网站才能获取所需数据。
首先,请查阅合乎道德的数据抓取准则,确保不会抓取受密码保护的个人身份信息或受版权保护的内容。确认一切合规后,可参考以下代码示例来处理 POST 请求。
import requests
res = requests.post(
"https://dashboard.marsproxies.com/login/",
 data={"username": "test", "password": "pass"},
 timeout=10
)
print(res.text)
请注意,实现登录功能需要编写更复杂的代码来处理CSRF 令牌以及维持登录状态所需的 Cookie。不过,上面的代码片段仅展示了如何为 POST HTTP 请求设置超时限制。
处理超时异常
设置超时限制固然重要,但处理超时错误同样不可忽视。首先,您需要清楚问题的根源——在成百上千行终端输出中逐条查找读取超时信息效率很低。请使用以下代码来指定错误信息。
import requests
try:
 res = requests.get(
  "https://marsproxies.com/proxies/residential-proxies/",
timeout=0.001
    )
 print(res.text)
except requests.Timeout as e:
  print(e)
这里我们设置了一个极低的数值,用来演示超时是如何发生的。实际使用中,您会为服务器获取数据设置更长的最长等待时间。来看看终端中发生了什么。
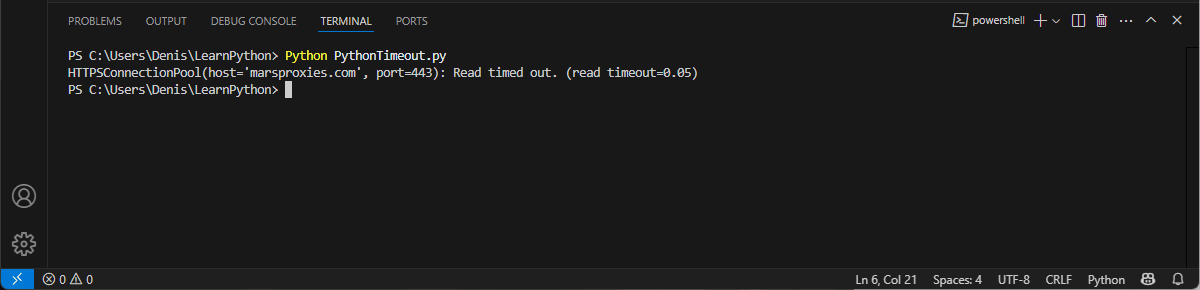
现在不再显示几十行输出,而是用一行代码就能指明问题所在。让我们再做些自定义,把 'print(e)' 这部分改成以下内容。
print("The request failed due to slow server responses.")
括号内的内容可以随意填写,这样就能为每个请求指定错误信息,方便您快速定位问题根源。另外请注意,我们还改用了 'try' 和 'except' 语句,这是处理超时问题的一种常见且高效的方式。
超时管理的最佳实践
现在的大多数应用程序都会与外部数据库和 API 通信,以获取更丰富的内容,但这也让它们更容易受到临时网络问题的影响。如果超时设置不当,应用程序常常会卡死或崩溃,导致用户流失。以下是解决此类问题的几点建议。
使用超时参数
这一点虽然显而易见,但有些开发者还是会忽略:默认情况下超时是没有限制的。因此应用程序可能一开始运行得很好,直到某次超时发生——随后应用程序会无限循环执行失败的请求方法,直到根本问题得到解决,这可能导致应用程序卡死甚至崩溃。
设置合适的超时值
在前面的示例中,我们设置了极低的超时值,以便演示错误是如何发生的,但在实际应用中不建议这样做。通常连接超时值会比读取超时值短,因为连接服务器的速度远快于从服务器抓取数据的速度。
具体的超时参数在很大程度上取决于网络结构、目标数据大小、您所在的地理位置、服务器软硬件配置等因素。以下超时值仅供参考,帮助您大致了解设置范围。
- 数据抓取。将连接超时设置为 1 到 5 秒、读取超时设置为 5 到 30 秒,可以为爬虫抓取数据留出充足时间。您还可以实现重试机制,每次重试时将读取超时值增加几秒钟,以应对临时性的网络问题。
- API:API 通常是更快速、更可靠的数据交换方式。此时可将连接超时设置为 1 到 3 秒、读取超时设置为 2 到 10 秒,如果请求的数据量较小,还可以适当调低这些数值。
- 内部数据库。与同一网络内的资源通信时,可以将连接超时设置为较低的 1 秒、读取超时设置为 1 到 3 秒,从而加快应用程序的响应速度。
设置全局超时
有时您可能需要为应用程序发出的所有网络请求设置一个全局超时值,这时可以使用 requests.Session() 对象,为每个 HTTP 请求指定所需的参数。
例如,Session 对象常用于管理 Cookie,让后续每个请求都自动携带 Cookie,从而保持用户的登录状态。下面是一个设置全局超时值的简单代码示例。
import requests
session = requests.Session()
session.timeout = 5
try:
 res = session.get("https://marsproxies.com/")
    print(f"Success: {res.status_code}")
except requests.exceptions.Timeout:
   print("Failed: Timed out")
try:
res = session.get("https://marsproxies.com/proxies/residential-proxies/")
    print(f"Success: {res.status_code}")
except requests.exceptions.Timeout:
    print("Failed: Timed out")
在这个示例中,我们设置了 5 秒的全局超时,并向我们网站的两个页面分别发送了 GET 请求。结果会打印出连接成功时的 200 状态码,或是 'Failed: Timed out' 错误提示。
监控并调整超时值
定期检查应用程序的性能表现,有助于发现已有或潜在的问题。建议您定义 P95 和 P99 延迟百分位:前者表示 95% 的请求能在该时长内完成,后者表示 99% 的请求能在该时长内完成。更稳妥的做法是,将超时值设置得略高于这两个数值,为正常的网络波动留出一些余地。
常见的超时问题及应对方法
虽然设置超时相对简单,但您仍可能遇到一些问题。以下是三种需要了解的常见场景。
未设置超时值
最明显的问题是完全没有设置超时。正如我们之前所说,默认值是未定义的,因此您的应用会无限期地持续发出 HTTP 请求,消耗资源、拖慢速度,甚至导致崩溃。
异常处理不当
即使正确设置了超时,您的应用仍可能出现卡顿或停机。请仔细检查是否在 try 和 except 代码块中正确设置了异常,同时请使用 requests.exceptions 函数来识别并解决错误。
超时设置过于激进
将超时设置得过短看似能让应用运行得更快,但这往往会产生虚假的服务器宕机误报。如果将读取超时设为 0.01,应用会无法获取数据——这并非因为无法连接到服务器,而是因为没有足够的时间来接收信息。
结语
在本指南中,您已学会使用 GET 或 POST 请求方法设置超时值。此外,我们还简要介绍了如何处理超时异常。如果您觉得本指南有帮助,请持续关注我们的博客,我们将持续更新Python 数据相关内容,例如如何编写重试请求。
考虑在性能关键型请求中切换编程语言?我们的Go 与 Python 对比文章详细分析了各自的优势。另外,也可以查看我们关于HTTPX 与 Requests 与 AIOHTTP 对比的文章。
如果您使用超时来抓取在线数据,我们还建议您查看我们的网络数据抓取指南。此外,如果您有建议或想向我们的代理专家提问,欢迎加入日益壮大的Discord 社区。
Requests 中的超时是什么?
Python Requests 库中的超时是一个参数,用于定义应用程序等待服务器响应的最长时间。连接超时是指建立与服务器连接所需的时间;而读取超时则定义了服务器响应的最长等待时长。
为什么在 HTTP 请求中设置超时很重要?
由于初始超时参数未定义,如果不手动设置超时,您的应用可能会在连接失败时陷入循环。应用可能会无限期地尝试连接服务器或等待响应,从而浪费资源,甚至导致崩溃。
连接超时与读取超时有什么区别?
连接超时定义了应用尝试连接服务器的最长时间,读取超时则指定了应用等待服务器响应的最长时间。
Python 中的默认超时是多少?
Python 中的默认超时是未定义的,这意味着它会无限期地持续下去。
可以为所有请求设置默认超时吗?
可以,您可以使用 requests.Session() 对象为所有请求设置全局超时。这样,会话的超时参数会应用于所有请求,但单个请求的设置值仍可覆盖该全局设置。