如果您既关注房地产行业、又热衷大数据,那么您多半已经不止一次想过要从 Zillow 抓取数据。无论是追踪当前市场趋势、对比不同平台的房源,还是挖掘潜在客户线索,实时获取房地产数据都是一项极具价值的资产。
本文将带您用 Python 构建 Zillow 爬虫,介绍所需的核心工具,并探讨如何高效地规模化与自动化您的数据抓取流程。
了解 Zillow 网站结构
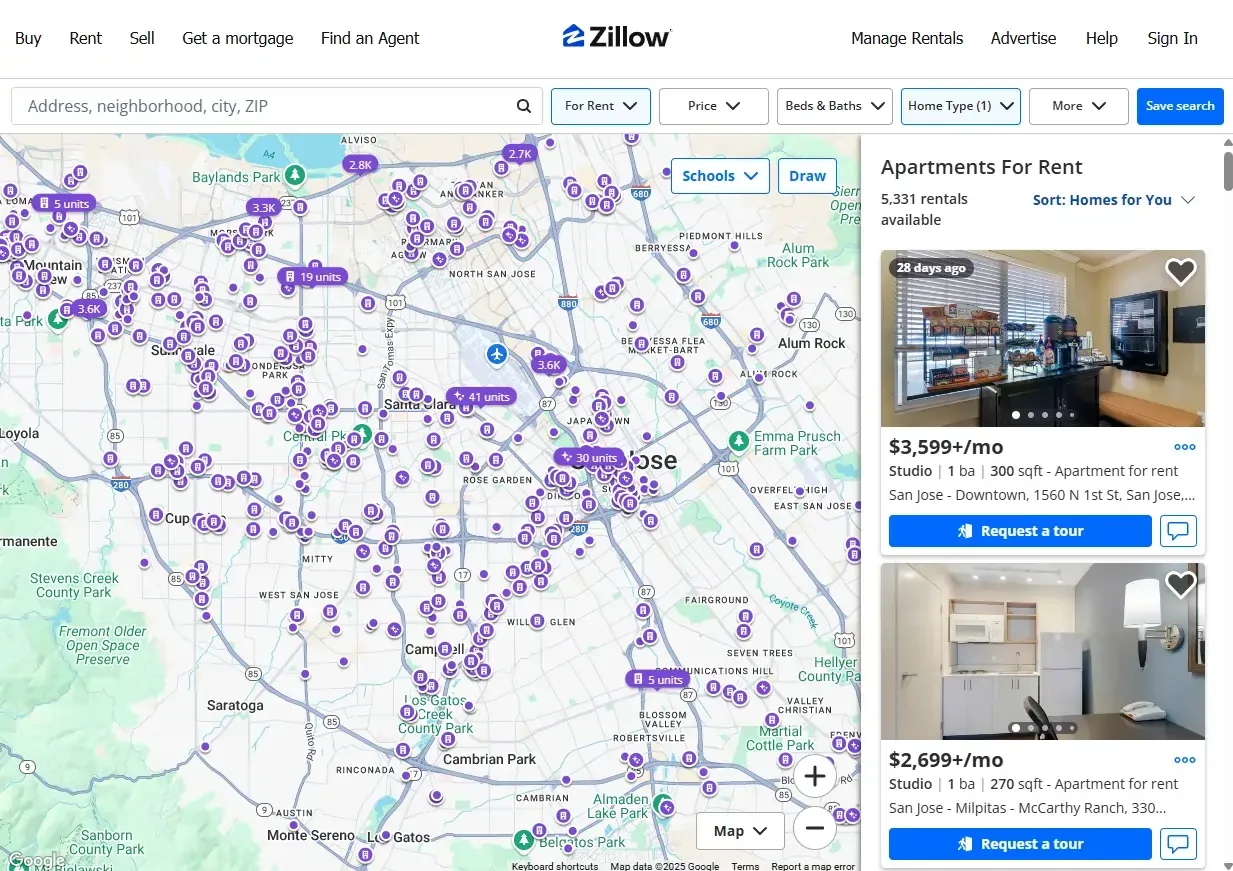
在深入代码等更复杂的内容之前,我们需要先了解 Zillow 网站的结构,以及它如何呈现我们所需的房地产数据。
前端结构
Zillow 网站包含多种类型的页面,其中与我们最相关的有以下两种:
- 搜索结果页:这类页面按价格、位置或卧室数量等条件筛选并展示房源列表。
- 房源详情页:点击某个房源后,您会进入一个展示该房源完整信息的页面。
这两类页面都包含结构化数据,这些数据既可能以静态方式渲染,也可能通过动态方式加载。了解这些页面的布局是成功抓取 Zillow 网页内容的关键。
JavaScript 渲染内容
Zillow 的许多内容是在页面首次加载后通过JavaScript动态加载的。这意味着仅查看原始 HTML(尤其是使用 requests 等库时)无法获取您想要的数据,您需要定位嵌入的 JSON 数据,或使用无头浏览器完整渲染页面后再进行解析。
使用浏览器开发者工具
要定位数据来源,请执行以下步骤:
- 在 Chrome 或 Firefox 中打开 Zillow 搜索页面
- 右键点击房源卡片,选择“检查”以打开开发者工具
- 进入 Network 标签页,筛选XHR请求,查找 JSON API 请求
- 或者,查看 Elements 标签页,寻找包含嵌入数据的<script type="application/json">标签
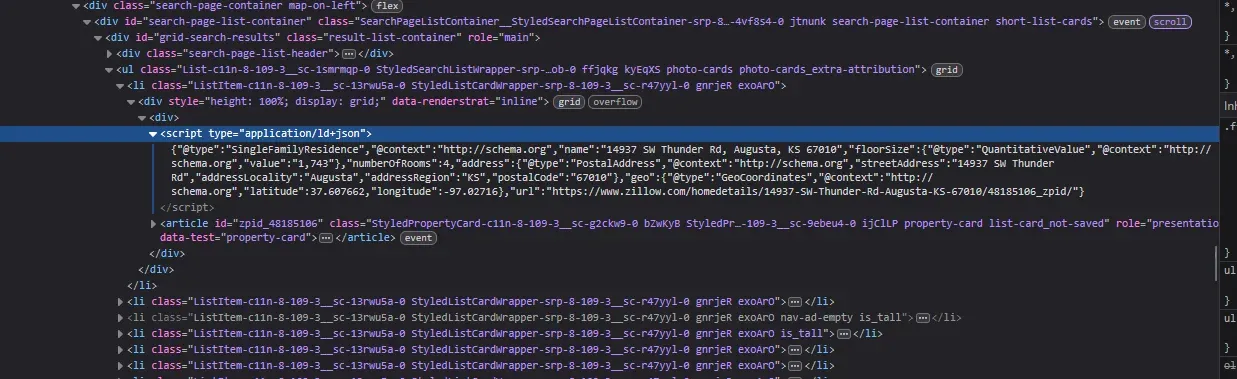
相比抓取可见的 HTML 内容,提取这类嵌入数据能获得更稳定、更结构化的数据来源。
Zillow 数据抓取的工具与技术
要成功从 Zillow 提取数据,您需要合适的工具和技术,具体选择取决于您的数据抓取目标。
编程语言与库
Python 因其成熟的生态系统和易用性,成为网络爬取领域广泛使用的语言。以下是几个核心库:
- requests:处理 HTTP 请求以获取 HTML 内容
- BeautifulSoup:解析并遍历 HTML 和 XML 内容
- lxml 和 parsel:提供 XPath 和 CSS 选择器支持,实现快速解析
要一次性安装所有这些库,请使用以下命令:
pip install requests beautifulsoup4 lxml parsel
借助这些库,您可以高效地从 Zillow 搜索结果页和房源详情页中提取房地产数据。
更倾向于使用 Go 而非 Python?我们的Golang 网络爬虫指南详细介绍了如何用 Go 从零构建爬虫
无头浏览器
对于通过 JavaScript 渲染的内容,可以考虑使用无头浏览器:
- Selenium:自动化浏览器操作,加载完整页面
- Playwright:一种更快速的现代工具,支持多种浏览器和上下文环境
对于 JavaScript 执行后才会出现的 Zillow 房源数据,这些工具是进行数据抓取不可或缺的。
基于 API 的方案
您也可以借助第三方 API,由其代为处理数据抓取:
- Apify:提供 Zillow Scraper Actor,可输出结构化数据,并支持分页、筛选等功能
这类服务可以减少开发工作量,但可能成本较高,或存在不合理的数据限制。
无代码工具
对于没有编程背景的用户来说,无代码抓取工具可以说是救星:
- Octoparse:拖拽式界面,支持任务调度和数据导出
- ParseHub:支持可视化选择页面元素,并提供条件判断和循环功能
这些工具简化了 Zillow 数据的抓取流程,但灵活性不及基于代码的方案。
如何用 Python 构建 Zillow 爬虫
现在,让我们进入正题——如何用 Python 构建 Zillow 爬虫,获取所有宝贵的房地产数据!
第一步:搭建环境
首先,安装必要的工具:
pip install requests beautifulsoup4 pandas
此命令将安装所有所需的库(即 requests、BeautifulSoup 和 Pandas)
正如前文所述,Zillow 网站结构中包含 JavaScript 渲染内容。为了让爬虫能够解析这部分内容,您需要一个无头浏览器。这里我们选择 Selenium,使用以下命令:
pip install selenium
您也可以选择搭建虚拟环境,以便更方便地管理依赖包。
第二步:获取搜索结果
Zillow 的 URL 中包含位置、价格区间、房屋类型等搜索筛选条件,例如:
base_url = "https://www.zillow.com/homes/for_sale/Los-Angeles,-CA_rb/"
使用 requests 或 Selenium 访问该页面
第三步:解析房源列表
Zillow 通常会在 <script> 标签中以嵌入 JSON 的形式包含结构化数据:
from bs4 import BeautifulSoup
import requests
import json

headers = {'User-Agent': 'Mozilla/5.0'}
response = requests.get(base_url, headers=headers)
soup = BeautifulSoup(response.content, 'html.parser')

for script in soup.find_all('script'):
   if 'application/json' in script.get('type', ''):
       json_data = script.string
       break

parsed = json.loads(json_data)
在 JSON 结构中查找 searchResults 或 listResults 等字段,以提取以下信息:
- 地址
- 价格
- 卧室数/卫生间数
- 房源链接
第四步:获取房源详细信息
访问每个房源链接以获取更多房产数据,重点关注:
- 纳税记录
- 建造年份
- 占地面积
- 室内设施
如有需要,可使用类似的解析技术或无头浏览器。
第五步:处理分页
Zillow 的结果以分页形式呈现,URL 中通常包含页码或分页参数:
for page in range(1, 10):
       url = f"https://www.zillow.com/homes/for_sale/Los-Angeles,-CA/{page}_p/"
    # fetch and parse each page
重要提示:请始终注意速率限制,并在请求之间加入延迟,从而更不易被察觉地持续抓取 Zillow 数据。
第六步:数据存储
将结果以便于使用的格式存储:
import pandas as pd

df = pd.DataFrame(property_list)
df.to_csv("zillow_data.csv", index=False)
df.to_json("zillow_data.json")
您也可以使用 SQLite 等数据库进行本地存储,或连接远程数据库以实现规模化。
进阶抓取技巧
绕过反爬措施
和其他网站一样,这个房源网站在怀疑您进行数据抓取时,可能会拦截可疑流量。为降低这种风险,可以尝试:
- 轮换代理,选择 MarsProxies 等信誉良好的代理供应商
- 使用不同的 User-Agent 修改请求头
- 加入随机等待时间
要添加 User-Agent 请求头和延迟,可尝试以下命令:
import random, time
user_agents = ["UA1", "UA2", "UA3"]
headers = {"User-Agent": random.choice(user_agents)}
time.sleep(random.uniform(2, 5))
处理 JavaScript 渲染内容
使用无头浏览器(此处为 Selenium)提取完全加载后的数据:
from selenium import webdriver
from selenium.webdriver.chrome.options import Options

options = Options()
options.add_argument('--headless')
driver = webdriver.Chrome(options=options)
driver.get(base_url)
data = driver.page_source
driver.quit()
性能优化
您可以通过异步或多线程方法提升抓取速度:
- asyncio + aiohttp 实现并发 HTTP 请求
- 使用 Python 多线程同时处理多个页面
可以通过以下方式实现:
import asyncio
import aiohttp

async def fetch(session, url):
    async with session.get(url) as resp:
      return await resp.text()
监控与维护
没有什么是一成不变的,Zillow 也不例外。由于其网站结构可能发生变化,建议设置以下机制:
- 日志记录,用于捕获异常故障
- 解析错误告警
- 定期验证关键选择器和数据字段的测试
规模化您的 Zillow 爬虫
云端部署
将爬虫部署到各类云平台,是实现 Zillow 爬虫规模化升级的高效方式。您可以尝试以下方案,根据自身需求找到合适的选择:
- AWS Lambda 或 EC2,适用于事件驱动或长期运行的任务
- Google Cloud Functions 或 App Engine
- Azure Web Apps,支持托管带定时任务的爬虫
调度与自动化
自动化是高效爬虫运行的另一项关键要素,可通过以下方式实现:
- 使用 cron 定时任务(在 Linux 上执行 crontab -e)
- Windows 任务计划程序
- Airflow 等工具,适用于复杂的 ETL 工作流
数据管道集成
最后,将数据输出集成到以下系统中:
- PostgreSQL 或 MongoDB
- 云存储(S3、GCS)
- Power BI、Tableau 等分析工具,用于构建数据看板
自建 Zillow 爬虫的替代方案
如果您觉得这一切有些复杂、耗时,或者根本不想自己动手搭建 Zillow 爬虫,还有不少现成的替代方案可供选择。
如果您更倾向于使用现成数据,以下 API 或许能帮到您:
- Zillow Bridge API(官方提供,但限制相当多)
- Estated:提供地块级数据和房产分析
- Mashvisor:面向房地产投资者,提供市场趋势分析
您也可以使用现成工具或托管服务:
- Apify 提供的 Zillow 数据抓取工具
- 托管在Scrapy Cloud 或 AWS 上的 Scrapy 爬虫
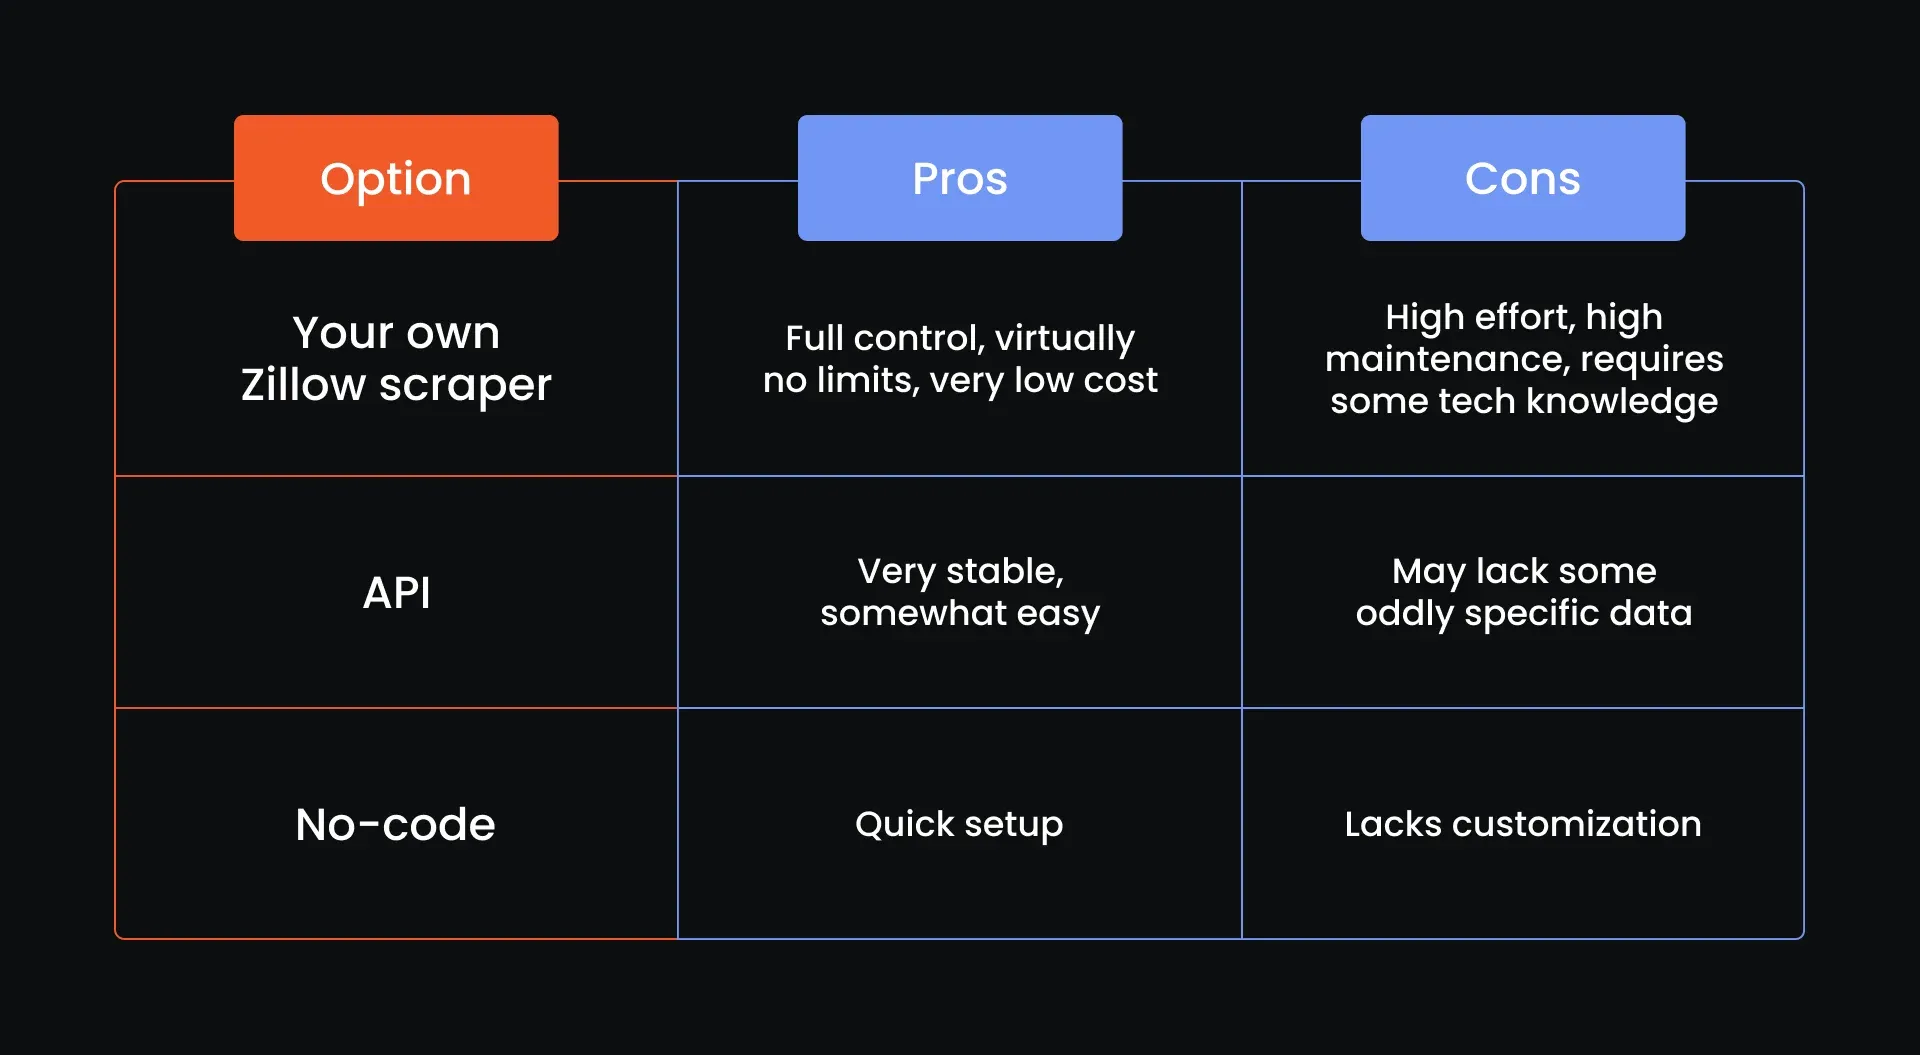
下面来比较一下各种开展 Zillow 数据抓取的方式:
结语
抓取 Zillow 数据能为房地产领域带来有价值的数据洞察和商业机会。无论是追踪价格趋势、整理房源数据集,还是开发获客工具,用 Python 构建 Zillow 爬虫都能为您提供所需的灵活性和掌控力。
从了解 Zillow 的网站结构,到部署可规模化的抓取流程,我们已经逐一讲解。无论您选择自建方案,还是借助第三方工具,关键在于在不断变化的 Zillow数据抓取领域中保持合规、审慎和灵活应变。欢迎查看我们关于如何抓取 Airbnb 数据的文章。
一如既往,如果您遇到困难,或者这篇指南让您感到一头雾水,欢迎到我们的Discord 频道寻求帮助,不用拘束,直接进来打个招呼就好!
可以从 Zillow 房源中提取哪些类型的数据?
通过抓取 Zillow 数据,您可以提取所需的各类房地产数据,包括价格、地址、卫生间数量、卧室数量、占地面积、建造年份、建筑面积、房产税、上市天数、经纪人信息、房源链接,甚至房源图片。
Zillow 是否提供官方 API?
是的,Zillow Bridge API 是官方 API,但其访问权限十分有限,适用的使用场景也很少,因此大多数开发者由于这些限制转而采用数据抓取方式。
如何在抓取 Zillow 数据时避免被封锁?
要尽量减少被封锁的情况,可以使用来自信誉良好的代理供应商(例如 MarsProxies)的轮换代理,持续更换 User-Agent,并对部分请求进行限速,使行为更接近真实用户。
从 Zillow 抓取数据的数量是否有限制?
虽然 Zillow 并未公布具体的数量限制,但频繁或激进的数据抓取可能触发速率限制或 IP 封禁,请务必合规、谨慎地进行数据抓取。