过去十年间,网络数据生成量大幅增长。据Statista 预测,到 2025 年,全球在线数据生成量将超过 181 ZB。据福布斯报道,这种数据爆炸式增长给当代企业带来了挑战,尤其是在捕获和分析视频广告、图片素材、用户生成内容等视觉信息方面。
这增加了对数据抓取工具的需求,这些工具擅长从网站提取数据。您可以把数据抓取想象成一个虚拟助手,专门为您搜寻相关信息。
数据抓取,又称在线数据提取或在线数据收集,是从网站上收集信息的过程。该过程通常需要借助网络爬虫,并使用代理服务器同时抓取多个网站的数据。收集到的数据通常以 XML、JSON、CSV 等格式存储,以便后续分析。
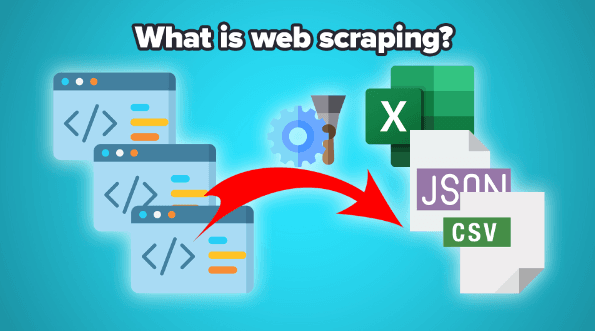
网络数据抓取工具是一种自动化工具,用于从网站和公开的在线文档中提取数据。其重要性不言而喻:原本需要数周甚至数月才能完成的人工收集工作,抓取工具只需几个小时即可完成。同时,网络数据抓取工具还能避免人为错误,提高数据的可靠性和质量。
在介绍高效的 Selenium 数据抓取软件和常见的数据抓取技术之前,我们先来了解一下它最常见的使用场景。
市场调研
企业借助数据抓取获取并比较商品价格、分析用户评价、监控竞争对手的营销策略。
学术研究
科学家通过抓取数据节省时间,为科研获取更多信息。例如,医疗卫生领域的科学家会抓取公共卫生数据,以更好地了解流行性疾病。
新闻网站
新闻网站可以从同意共享数据的公开域名中提取数据,并将其用于自己的网站以吸引更多流量,天气预报机构就是一个例子。
个人项目
假设您正在寻找价格合适的租房选项,与其手动浏览几十个租房网站,不如抓取这些网站,根据自己的需求筛选出合适的房源。
人力资源
人力资源专员会从在线招聘机构或 LinkedIn 等社交网络收集数据,以找到最符合其需求的候选人档案。
了解数据抓取的伦理与合法性问题
如您所见,数据抓取有多种使用场景,因此您的抓取流程和抓取工具的选择在很大程度上取决于具体用途。从使用静态 HTML 代码的网站获取数据,与从动态交互式网站中提取数据是截然不同的。
数据抓取技术是指搜索、识别和收集数据的操作方法。每当您上网查询产品价格(比如机票价格),将其记录下来,再到其他网站重复这一操作进行比较时,您实际上就是在进行人工数据抓取。不过值得指出的是,“数据抓取”这一说法通常专指自动化抓取技术,因为自动化正是其核心卖点。
还需要指出的是,由于存在多起滥用事件,数据抓取一直是一个敏感话题。剑桥分析丑闻中,该公司非法抓取了 8700 万个 Facebook 用户资料,给数据抓取行业造成了长期的负面影响。因此,建议在开始之前先了解数据抓取相关的合法性与伦理问题。
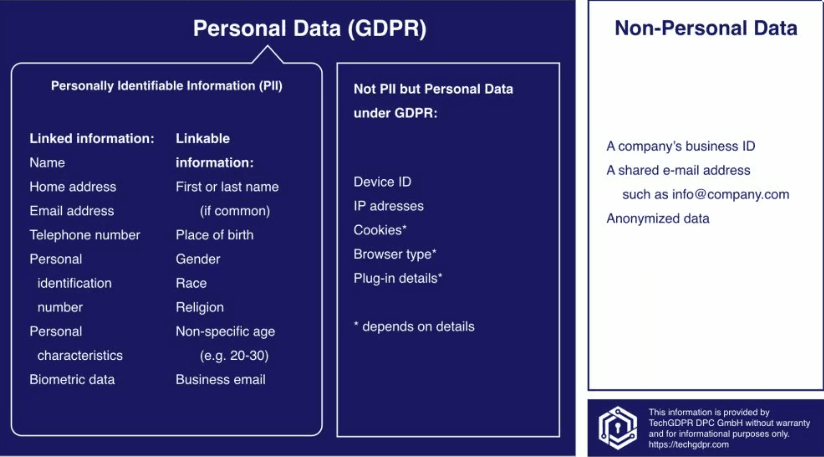
人们普遍认为,收集个人身份信息(PII)并不可取。真实姓名、电话号码、住址、工作信息等都属于个人隐私信息,即便这些信息发布在公开论坛或社交网络上,也同样受到保护。在欧洲,《通用数据保护条例》(GDPR)专门用于防止此类信息被滥用。如果您的业务模式依赖此类信息,就必须了解 GDPR 的相关规定,并对存储的数据进行加密。
请注意版权限制:您必须确认目标网站同意共享图片、视频等数据。例如,未经许可抓取图片素材并重复使用,可能导致高额诉讼。您可以在服务条款和 Robot.txt 文件中查找版权相关信息。
最后,请尊重网站所有者。抓取受密码保护的数据可能侵犯隐私。同时,切勿用过多并发请求给网站造成过大负担,并务必查看 Robot.txt 文件中规定的限制范围。
数据抓取核心术语
在介绍数据抓取工具和常见抓取技术之前,先了解核心术语十分必要。这不仅有助于您理解网站结构,还能帮助您为自身需求选择合适的抓取工具。
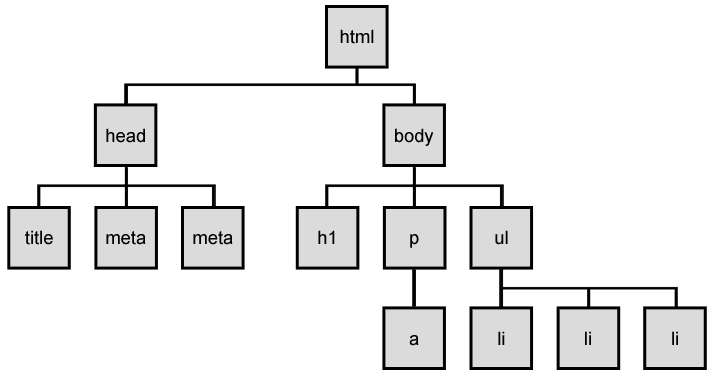
HTML(超文本标记语言)是网站的基础。它是一种用于组织网页主要内容结构的语言,包括段落、标题、反向链接、视频等元素。举例来说,如果您要抓取一个使用 HTML 组织价格信息的汽车销售网站,就需要一种专为 HTML 数据抓取设计的工具。
然而,HTML 网站功能有限,难以吸引现代用户的注意力,因此您常常会遇到 DOM 树。DOM(文档对象模型)充当 HTML 与 JavaScript 等编程语言之间的桥梁,JavaScript 用于为网站添加动态元素,例如醒目的广告弹窗和下拉菜单。
每当浏览器加载网站时,都会生成一份列出所有元素(包括标题、图片等)的 DOM 文档。抓取 DOM 树的过程称为 DOM 解析,它可以让数据收集更加结构化,但也需要更深入的 HTML 知识。幸运的是,Beautiful Soup 等工具可以提供帮助。
获取所需数据不一定非要依赖数据抓取,API 是数据抓取之外一种出色的替代方案。API(应用程序编程接口)用于规范双方之间的信息交换。例如,您的新闻网站想使用某机构的天气预报数据,由于这对双方都有利,对方可能会开放一个公开 API 供您提取数据。
这就引出了最后一个术语:机器人检测系统。许多网站希望避免被抓取,因为它们认为这是一种不正当竞争行为,或是不必要的资源消耗。但实际上,大多数处理在线数据的企业本身也在进行数据抓取。不过,这也催生了 CAPTCHA、IP 封禁、诱捕机制(honeypot)等反机器人措施。
每当您使用数据抓取工具从网站收集数据时,都会用您的原始 IP 地址发送数据请求,网站因此可以记录并封锁该 IP。因此,建议使用支持轮换住宅代理的数据抓取工具。这样一来,您的抓取流程将获得额外的隐私保护,一旦被封锁,也可以随时切换到新的 IP。
2026年用轮换住宅代理避开数据抓取IP封禁
购买住宅代理数据抓取的工具与技术
您不需要会编程也能抓取数据,但掌握一门编程语言能大大拓展您在数据抓取技术上的选择。您可以自行构建抓取工具,或选择所需的数据输出格式。如果您愿意挑战这条更具难度但回报丰厚的路径,建议从数据抓取技术的 Python 应用入门。
Python
Python 是应用最广泛的编程语言之一,同时具有良好的可读性,容易上手。此外,Python 拥有出色的数据抓取库和框架,可针对不同需求进行优化。Python 是开源的,您随时可以加入其在线社区寻求帮助。BeautifulSoup 和 Scrapy 是两款可以将Python 数据抓取能力提升到更高水平的工具。
JavaScript 与 Node.js
与 Python 一样,JavaScript 的普及程度同样很高,甚至有过之而无不及。长期以来,它主要用于构建网站前端,因此自然也非常适合用于数据抓取。不过需要提醒的是,要充分发挥 JavaScript 抓取工具的优势,需要具备较高的技术水平,因为它需要借助 Node.js 运行环境实现后端服务器端脚本功能。Puppeteer 是一个适合抓取动态网站的 Node.js 库,使用时需要一定的技术基础。
想比较 Python 与其他语言?我们的Go 与 Python 对比指南详细分析了哪种语言更适合数据抓取项目。想专门了解用 Go 做抓取?我们的Golang 数据抓取工具指南将带您从零开始构建一个抓取工具。
R
收集在线数据固然重要,但将其可视化同样重要。毕竟,大量抓取到的数据需要进一步分析,并以易于理解的方式呈现结果,而这正是 R 语言的优势所在。R 针对大型数据仓库进行了优化,还内置了可简化数据分析流程的可视化功能。尽管 R 的语法较为复杂,但它也提供了 rvest 等实用工具。
常用数据抓取库与框架
当您熟悉所选编程语言后,建议再学习一种数据抓取工具。以下是四种常用于简化数据提取流程的工具。
BeautifulSoup
BeautifulSoup 是一个 Python 解析库,旨在从 XML 和 HTML 文件中轻松提取信息。它拥有友好的操作界面、内置的错误处理机制、高效的信息查找功能,以及跨平台支持。下面是一段简单的代码示例,演示 BeautifulSoup 如何定位 <h1> HTML 元素。
from bs4 import BeautifulSoup
# Sample HTML content
html_content = """
<h1>This is a heading</h1>
<p>This is a paragraph with some text.</p>
"""
# Parse the HTML
soup = BeautifulSoup(html_content, 'html.parser')
# Find the heading element
heading = soup.find('h1')
# Extract and print the text content of the heading
print(heading.text)
在 Python 中,# 代表注释标记。可以看到,实际代码的写法接近简单的英语语法,这也是它在数据抓取从业者中广受欢迎的原因。
Scrapy
Scrapy Python 框架借助 Spider(网络爬虫)、解析器(按所需格式提取数据的工具)以及内置的 Item Pipeline(用于数据存储和处理)来增强数据抓取能力。Scrapy 速度快、高度可定制,但学习门槛较高,对 JavaScript 网站的处理效果欠佳。同样,这套开源代码在网上也有大量资源可供查阅求助。
Puppeteer
Puppeteer 是一个 Node.js 库,是数据抓取动态网站的理想选择之一。它借助无头浏览器在后台运行、无需界面即可自动完成浏览器操作。Puppeteer 支持跳转网址、填写表单、点击按钮等操作,是用于模拟真实用户行为、适合数据抓取的工具之一。
rvest
使用 R 语言进行数据抓取时,rvest 是一种非常实用的工具。由于 R 语言相对复杂,rvest 简化了网站内容的下载流程,并支持定位特定 HTML 元素或使用 CSS 选择器缩小搜索范围。不足之处在于 rvest 缺少高级自定义选项,但这也是其简洁易用所付出的合理代价。
数据抓取技术
工具都已准备就绪,您已经可以开始从网站抓取数据。不过正如前文所述,不同网站的结构差异很大。请参考下面的建议,选择合适的数据抓取技术和工具。
简单 HTML 解析
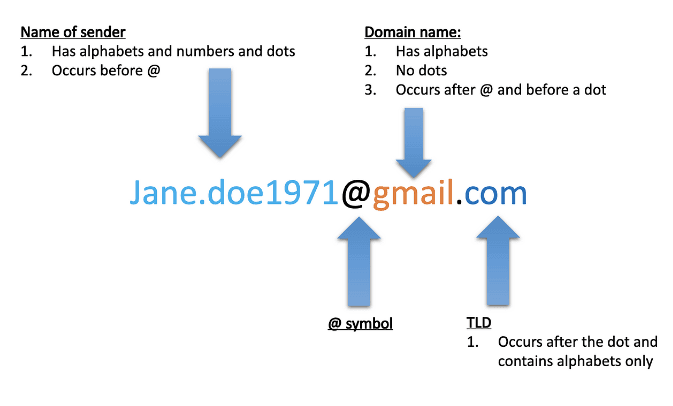
这是较为简单直接的数据抓取方式之一,很快就能上手。您可以使用正则表达式识别静态 HTML 文档中的模式。例如,可以让爬虫定位“xxxx@email.com”这样的元素来抓取邮箱地址,产品价格、描述等信息同理。不过,这种方法并不适合结构更复杂的 HTML 网站。
BeautifulSoup 这个 Python 库非常适合用来优化简单 HTML 解析,它采用树状结构分层展示元素,并提供便捷的查找工具。BeautifulSoup 支持按属性、标签名称和 CSS 选择器进行搜索。
浏览器自动化与无头浏览器
顾名思义,这种数据抓取方法通过浏览器(通常是无头浏览器)来模拟更接近真实用户的行为。例如,如果某些元素需要特定操作才会出现(比如点击按钮),您可以借助这种方法抓取原本仅面向真人访客展示的数据。同样需要提醒的是,请考虑相关法律和道德因素,避免抓取个人身份信息等高风险行为。
无头浏览器是一种没有图形用户界面(GUI)的浏览器,运行原理和标准的 Chrome 或其他浏览器类似。不过,它在后台运行,需要通过代码进行管理。正是这一特性让您可以自动化并复现用户行为,从而抓取那些需要交互操作才能获取数据的网站。
Selenium 是用于浏览器自动化的常用工具之一,支持使用 Python、JavaScript 等多种编程语言来定制无头浏览器。Selenium 可以上传文件、填写表单、操作下拉菜单和点击按钮。总的来说,它是一种强大的工具,可以与 JavaScript 元素交互,抓取功能丰富的动态网站,并降低被检测、触发 CAPTCHA 或遭遇 IP 封禁的概率。
处理 AJAX 请求
AJAX 请求给数据抓取带来了额外的挑战,因为它会限制可获取内容的范围。这项技术允许网站在后台更新信息而无需重新加载页面。因此,只专注于抓取 HTML 的爬虫可能会遗漏已更新的元素,因为它们无法捕获后台事件。
同样,无头浏览器也可以用来发起 AJAX 请求并抓取数据。此外,您也可以在浏览器的开发者工具中查看具体处理所需数据的 AJAX 请求。如果具备足够的编程知识,还可以自定义爬虫来监控这些请求。
使用 RESTful API
API 是数据抓取之外的另一种选择,但有时两者也会配合使用。RESTful API(表述性状态转移应用程序编程接口)是一种用于简化双方数据交换的工具,通过标准的HTTP 协议中的 GET、POST、PUT 和 DELETE 方法,以 JSON 和 XML 格式传输数据。RESTful API 具有很高的可定制性和可扩展性。
您可能会遇到一些企业通过 RESTful API 向客户提供数据抓取所得的数据,这样您就无需操心抓取工具,只需专注于数据分析即可。值得注意的是,数据抓取和 API 本质上是两回事,只是部分企业会将二者结合使用。
代理与 CAPTCHA 处理
IP 封禁和 CAPTCHA 是两种常见的限制数据抓取访问的手段。首先,建议您仔细查看 Robots.txt 文件,了解网站的数据共享规则。如果您同时发送的请求过多,或者在流量高峰时段进行爬取,可能会触发 CAPTCHA 验证或遭遇 IP 封禁。
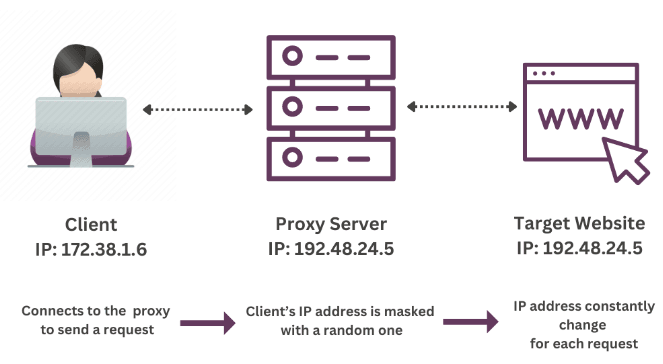
不过,如果您的 IP 被封禁,可以使用代理来解决。代理会隐藏您的真实 IP 并提供一个替代 IP,让您能够继续进行数据抓取。与此同时,市面上也有不少第三方服务可以应对 CAPTCHA,无论是直接破解还是提前规避。
结语:高效数据抓取的实用建议
数据抓取是从网络获取数据的有效方式之一,但也颇具挑战性。选择合适的工具并了解网站结构会带来很大帮助,但同时也需要遵守对方的爬取政策。
为了安全起见,请牢记以下几点
- 查看 Robots.txt 和服务条款文件,了解数据共享规则
- 网站服务器造成过大压力避免过高的爬取频率给
- 确保数据质量与准确性在分享抓取数据的分析结果之前,
另外,别忘了查看我们关于如何抓取 Shopify 店铺数据的指南。