数据正深刻影响着当今市场,能够获取具有竞争优势的信息极具价值。全球营销专家在 Statista 的调查中表示,数据驱动战略在32%的使用场景中取得了显著成效,失败率仅为5%。
在线数据几乎涵盖了一切:商品价格、第一手产品评价、用户情绪、各类新闻和文章,以及您能想到的任何内容。这些数据可以改变产品开发或营销策略的方向,但面对如此庞大的数据量,又该如何高效提取呢?
数据抓取是快速、准确地获取在线信息的一种方式。使用 Python 进行数据抓取往往是更合适的选择,因为这门编程语言语法简单易学,并拥有多种从网站提取数据的工具。
如需了解更多关于如何选择适合数据抓取的工具,请参阅我们的专题文章。本文将为您提供一份 Python 数据抓取入门教程,帮助您快速上手。
什么是数据抓取?
数据抓取是一种自动从网站获取数据的方法。设想您正在寻找心仪乐队的演唱会门票,与其手动搜索附近的演出信息,不如借助一个程序自动完成这项工作。在更大规模上,数据抓取可以同时针对多个网站,以获取商业情报。
这里的关键词是自动化。查看几个演出场馆或许用不了多少时间,但如果要查看数以万计的场馆呢?这正是营销专业人士在收集数据、优化营销活动并超越竞争对手时面临的挑战。
手动检查数以万计的竞争对手网站既耗时又容易出错。相比之下,精通技术的专业人员会借助额外的工具提取数据,例如抓取机器人、数据抓取库,以及轮换住宅代理网络,以规避反抓取检测。
这样一来,他们可以同时针对多个网站发起请求,或向同一网站发送多个请求,从而更快地获取数据。使用 Python 进行数据抓取还可以实现自动登录,以获取需要人工交互才能访问的数据。
不过,遵守GDPR 等数据保护法规是避免法律纠纷的关键。最好避免收集受国内外法律保护的数据,并尊重网站所有者在 robot.txt 文件中列出的相关规则。在深入探讨 Python 数据抓取的具体细节之前,我们先来了解它的主要使用场景。
常见使用场景
许多依赖数据驱动决策的行业都会使用数据抓取来获取信息。本文将介绍4种常见的使用场景,在这些场景中经常会用到这种数据提取方法。
电商价格比较
电商企业借助数据抓取从零售网站获取商品价格。他们利用这些数据进行价格比较并据此调整定价,同时监控商品价格变化、把握限时折扣,并保持数据集的实时更新。如果您正在寻找现成的解决方案,请参阅我们关于适合价格追踪的工具的指南。
在这种场景下,Python 编程语言的优势在于支持精准数据提取所需的高级数据抓取功能。零售网站通常会屏蔽抓取工具,以保持网站运行流畅、速度稳定,并防止用户数据被不当挖掘。Scrapy Python请求可以进行定制,以避免干扰网站正常运行,并只针对 robot.txt 文件所允许的部分进行抓取。
不过,只要遵循透明、合乎道德的Selenium 数据抓取方式并尊重网站规则,就能快速提取数据,同时避免人为错误。借助 Beautiful Soup 等 Python 库,可以对提取的价格数据进行解析,使其更易读、更便于后续分析。
市场调研与竞争对手分析
一次全面的市场调研需要大量数据。如今,这些数据广泛分布在点评网站、零售网站、社交媒体、论坛、竞争对手网站和新闻网站上。企业当然可以不收集这些信息,但这样一来,竞争对手就会借此优化自身的营销策略,吸引更多客户。
使用 Python 进行数据抓取,企业可以抓取 Amazon或竞争对手的网站,并借助代理规避反抓取防护。例如,SEO 专家会抓取竞争对手的新闻网站和博客文章,提取其排名所依赖的关键词。这样,内容运营人员就能发现关键词空白,优化自己的网站,使Google给予更高排名,从而提升自然流量。
社交媒体数据采集与情绪分析
2025年,使用社交媒体的人数已超过50亿,占全球网民的大多数。社交网络是了解公众舆论、洞察消费者趋势和情绪的首选平台。哪怕是点赞和分享这样的小举动,也能揭示消费者的喜好与反感。
抓取公开的社交媒体数据是合法的,但挖掘个人身份信息(PII)通常并不合法。将此类数据用作商业模式的企业必须遵守严格的安全规范,例如将 PII 的收集控制在最低限度、对静态和传输中的数据进行加密,并在数据不再需要时及时删除。
值得一提的是,许多社交媒体平台都提供应用程序编程接口(API),以简化数据交换流程。它规定了双方在知情同意的前提下如何共享特定信息,但相较于数据抓取,限制也更多。
为机器学习构建数据集
数据抓取是用 Python 语言采集、解析数据,并将其用于机器学习(ML)的有效方法。在开始之前,必须明确所需的数据类型,以避免向机器学习算法中填入无关变量。与此同时,机器学习往往需要庞大的数据集,因此最好预估数据量,并选择具备良好扩展性的数据抓取工具。
同样地,确保为机器学习抓取数据的合法性至关重要,以避免潜在麻烦。Meta 这家在数据采集方面经验丰富的公司,近期就因盗用 82 TB 图书资料训练人工智能而陷入法律纠纷。在抓取大量信息之前,最好始终遵守数据隐私和版权相关法律。
不确定 Python 是否适合您的任务?我们的Go 与 Python 对比文章详细分析了两者分别适合哪些数据抓取和机器学习工作流程。
搭建 Python 开发环境
首先,您需要下载 Python,可从官方网站下载。我们建议使用任意 3.x 版本,本教程使用的是适用于 Windows 的 3.13.2 版本。安装前,请务必勾选“Add Python to PATH”选项,这样才能在命令提示符或终端中直接运行 Python。
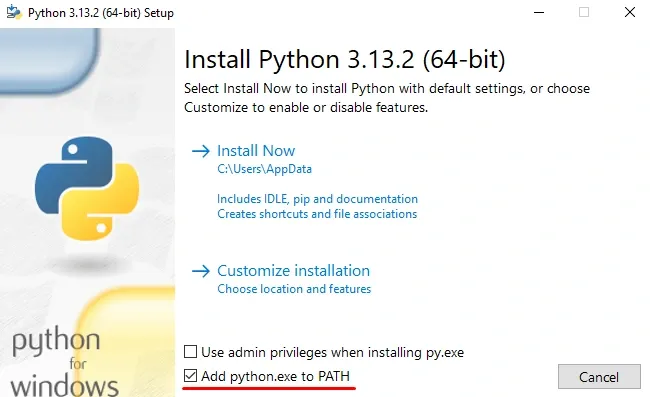
安装成功后,建议您创建一个虚拟环境。即使您是初学者,也很可能会为 Python 扩展不止一个数据抓取库,用于简化 HTTP 请求或模拟真实用户行为。使用独立的虚拟环境可以确保各个抓取项目互不干扰,且 Python 库之间不会产生冲突。请打开命令提示符或终端,执行以下代码:
python -m venv scrapingVE
此操作将创建一个名为 scrapingVE 的虚拟环境。如果命令提示符没有任何反馈,不必惊讶,因为它不会专门确认设置是否成功。如需验证,请查看执行命令时所在的目录。在我的设备上,我能看到新生成的 scrapingVE 文件夹。
最后,安装您偏好的工具,以简化开发流程。可以选择专为 Python 设计的集成开发环境(IDE),例如 Visual Studio Code 或 PyCharm。不过,为避免因 IDE 差异造成困惑,本示例将使用标准 Python 环境。
在本指南中,我们还会用到另外3个库:Requests、BeautifulSoup 和 Selenium。尽管 Python 提供了远不止这些的数据抓取工具,但这3个库应用广泛,能够优化关键开发流程。下面我们来逐一详细介绍这几个 Python 库。
更倾向于使用 Go?我们的Golang 数据抓取指南使用 Go 讲解了同样的基础知识。
数据抓取常用 Python 库
尽管 Python 本身完全能够独立完成数据抓取任务,但大多数情况下,您还是会用到各种数据抓取库。例如,Beautiful Soup 和 Requests 几乎总是被用来简化 HTTP 请求并解析 HTML 内容。我们先从 Requests 开始介绍。
Requests——处理 HTTP 请求
HTTP 请求是客户端与网站通信的基础。简单来说,数据抓取就是向网站发送 HTTP 请求,请求获取某些信息。但如果要同时抓取多个网站、抓取大量使用 JavaScript 的复杂网站,或者模拟真实用户行为,情况就会复杂得多。
Requests 库几乎总是被用来简化这一过程。它处理底层网络通信的复杂细节,从而简化 GET、PUT、POST 等 HTTP 请求。Requests 库能自动完成编码与解码、处理状态码响应、保存 Cookie,甚至还能验证 SSL 证书以确保安全。
安装 Requests 以及其他用于数据抓取的 Python 库都很简单。请打开命令提示符,执行以下代码:
pip install requests
如果安装成功,命令提示符不会返回任何内容(新手可能需要一些时间来适应这一点)。现在,请打开您的 IDE(本示例使用标准 Python 环境),输入以下内容:
import requests
如果您想验证 Requests 库是否已成功导入,可以使用以下代码:
print(requests.__version__)
请注意,"version"前后各有两个下划线(即__,中间没有空格),在部分文档中可能不太容易看清。如果没有问题,您应该会看到类似下面的内容。
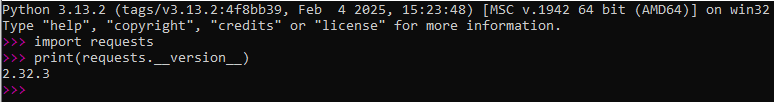
上面的结果显示,我们使用的是 2.32.3 版本的 Requests 库。接下来,让我们实际使用这个库发送一个 GET HTTP 请求——这正是网络爬取的核心操作。下面这六行代码是最基础的 Python 网络爬取示例,可以帮助您快速上手。
url = "https://marsproxies.com/"
response = requests.get(url)
response.raise_for_status()
print(response.status_code)
print(response.text)
第一行指定了要抓取的网站,您可以把 MarsProxies.com 换成自己想要的目标网站。接着发送一个 GET 请求,同时让 Python 验证连接是否成功建立,并打印状态码。最后,我们让 Python 将响应内容(本例中为一个 HTML 文档)以字符串形式返回。结果如下。
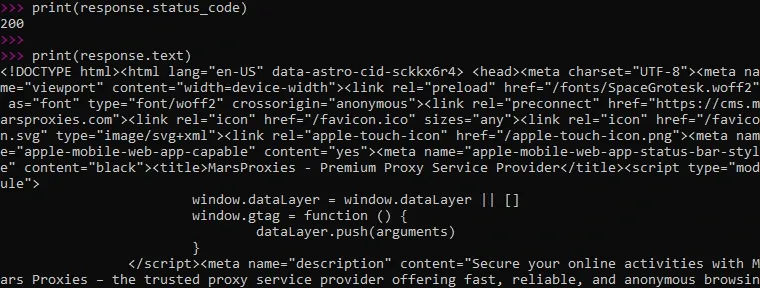
首先,Python 返回状态码 200,表示 HTTP 请求成功。接下来,我们让 Python 获取网站内容,在第 5 行可以看到!DOCTYPE html,说明响应内容是以字符串格式返回的 HTML 文档。
接下来看到的是未经解析的网站源代码。这段代码长达数百行,手动从中提取数据既繁琐又容易出错。正因如此,和 Requests 一样,Beautiful Soup 几乎总是被用来解析数据,让内容变得可读。
Beautiful Soup——HTML 解析
处理未经解析的数据既低效又耗时,与网络爬取的目标背道而驰。Beautiful Soup 是用于解析 HTML 和 XML 文档最常用的 Python 库。
这个工具支持您遍历 HTML 树,并通过属性、标签名和 CSS 选择器来查找数据。它能将原本可能需要数天的工作自动化,缩短到几分钟内完成。接下来,我们来安装 Beautiful Soup 并实际使用一下。
首先,打开终端或命令提示符,使用以下命令安装这个库:
pip install beautifulsoup4
然后,打开您的 Python IDE,使用以下命令导入 Beautiful Soup 库:
From bs4 import BeautifulSoup
为了便于查看,我们将使用一段非常简单的 HTML 代码,并让 BeautifulSoup 查找其中的 h1 元素。首先在 Python 中定义 HTML 内容:
html_content = """
然后,参照下面的示例编写一段简单的网站 HTML 代码:
<!DOCTYPE html>
<html>
<head>
<title>Example page</title>
</head>
<body>
<h1>The first h1 tag</h1>
<h1>A second h1 tag</h1>
<p>Some more content</p>
<ul>
<li>Item example</li>
</ul>
<a href="https://www.example.com">Link to Example</a>
</body>
</html>
"""
我们创建了一段简单的 HTML 代码,其中包含 2 个 h1 标签、一个段落、一个列表项和一个随机外链。现在我们想让 Beautiful Soup 找出所有的 h1 标签,具体方法如下:
soup = BeautifulSoup(html_content, "html.parser")
h1_tags = soup.find_all("h1")
for h1 in h1_tags:
print(f"H1 tag text: {h1.text}")
首先,我们创建一个 Beautiful Soup 对象,并设置一个用于解析 HTML 内容的变量。正如前面示例所展示的,Requests 库能高效提取网站的 HTML 内容,因此这两个工具搭配使用效果很好。结果如下:
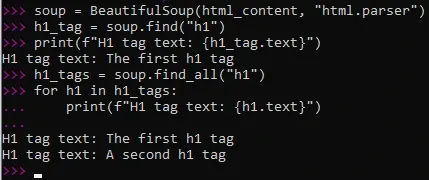
可以看到,我们写了两个函数:soup.find("h1")和soup.find_all("h1"),用来展示 Beautiful Soup 的具体用法。第一个函数会遍历 HTML 代码,只返回它遇到的第一个 h1 标签,所以即使代码中有 2 个 h1 标签,它也只会以文本形式返回第一个。
要找出全部两个标签则稍微复杂一些。这种情况下,我们可以使用 h1_tags 变量,让 Python 把代码中找到的每个 h1 标签文本都打印出来。可以看到,这次返回了两段文本,我们已经成功解析了一个简单的文档。
Selenium——处理 JavaScript 密集型网站
前面的示例使用的是便于抓取和解析的静态 HTML 代码。但在大多数情况下,您面对的网站要复杂得多,其中包含动态的 JavaScript 元素。
Selenium 是一个专为处理 JavaScript 密集型网站而优化的 Python 库,它会等待网站完全加载后再获取所需数据,以确保数据集完整。它还能实现浏览器自动化,可以执行点击、提交表单和模拟滚动等操作,是网络爬取中非常实用的工具。
首先,像之前安装其他库一样,在命令提示符中安装 Selenium,命令如下:
pip install selenium
您还需要为 Python 3.x 版本下载 Selenium 的 web driver manager,使用以下代码:
pip3 install webdriver-manager
然后,在 Python 中导入 Selenium。如果出现 ModuleNotFoundError 提示,请确认您是在之前创建的虚拟环境中安装库。在 Python 中输入以下内容:
import selenium
很简单。将 Selenium 作为无头浏览器使用,能实现很多功能,但一切都要从打开一个网站开始。我们用最简单的方式,通过以下 Selenium 代码行打开 MarsProxies.com:
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from webdriver_manager.chrome import ChromeDriverManager
driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()))
webdriver.get("https://www.marsproxies.com")
如下图所示,Selenium 刚刚在 Chrome 浏览器中打开了 MarsProxies 网站,该浏览器正受到自动化软件的控制。
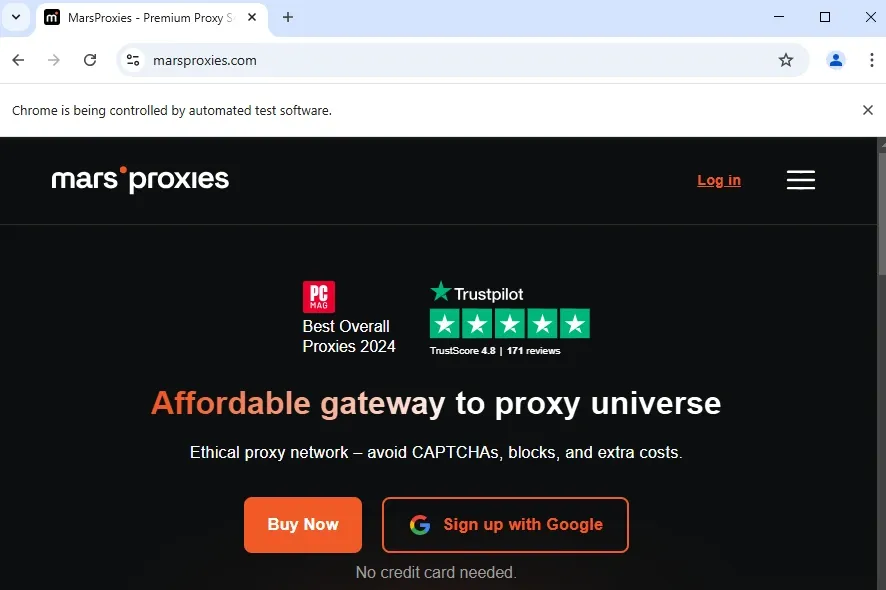
现在,您可以查看网站结构,并使用 Selenium 命令提取数据。例如,driver.find_element(By.CSS_SELECTOR, "css_selector")这样的命令可以让您通过 CSS 选择器查找数据,此外也可以按名称、类名、ID 等目标网站结构中使用的其他条件进行查找。
理解网站结构
我们已经介绍了 Python 的基本安装流程、搭建抓取和开发环境的方法,以及 3 个常用 Python 网络爬取库的配置方式。但是,如果不理解网站结构,您很难走得更远。
毕竟,抓取 HTML 内容和动态网站还需要 Python 之外的更多知识。例如,掌握 JavaScript 能帮助您充分发挥 Selenium 的能力,而了解网站的结构方式,也会让您用各种选择器获取数据变得更加轻松。
HTML 与文档对象模型(DOM)基础
HTML 全称是 HyperText Markup Language(超文本标记语言),是网站的核心构成部分。可以把它想象成人体的骨架,其他一切都是围绕它搭建起来的。前面使用 Beautiful Soup 解析并提取 2 个 h1 标签内容时,您已经见过一段基础的 HTML 代码。
虽然我们的示例非常简单,但总体来说 HTML 代码通俗易懂。网站功能越多,比如用于页面设计的 CSS 元素、用于实现动态交互的 JavaScript 代码,情况就会变得越复杂。
另外需要注意,您还会遇到使用各种 JavaScript 库的网站。例如,由 Facebook(现 Meta)开发的 ReactJS 深受前端开发者青睐,因为它鼓励编写可复用组件,并通过虚拟 DOM 提升性能;但它也带来了额外的复杂度,比如需要适应其特有的 JSX 语法扩展。
因此,从 HTML 开始,您会接触到越来越复杂的元素。HTML 内容是围绕<p>、<h1>、<div>等标签构成的,例如:
<p> this is a paragraph example </p>
请注意,每个标签都有一个以/开头的闭合标签。假设您想从一个零售网站抓取价格信息,这时就需要找出哪些标签存放价格数据,并通过 Python 请求来定位它们。
下面是一段非常简单的 HTML 代码示例:
<!DOCTYPE html>
<html>
<head>
<title>Example HTML</title>
</head>
<body>
<h1>First header</h1>
<p>Paragraph element</p>
<ul>
<li>First item</li>
<li>Second Item</li>
</ul>
<a href="https://www.MarsProxies.com">Link</a>
</body>
</html>
第一行声明了文档类型,本例中是 HTML。接着是<head>标签,其中包含文档的元数据(样式表链接、标题等)。
最关键的部分写在<body>标签与</body>闭合标签之间,这里的代码就是网站的主要内容。我们的示例包含一个标题、一个段落、两个列表项和一个外链。可以想象,价格信息通常会以带有特定 class 或 CSS 选择器的<li>元素形式出现,之后就可以使用前面介绍的工具来抓取这些价格。
DOM 全称是 Document Object Model(文档对象模型),是用于 XML 和 HTML 文档的编程接口。它以树状对象结构来表示这些文档,其中每个对象代表文档的某一部分。网络爬取工具通常通过 DOM 来操作 HTML 和 XML 文档,因为这种方式遍历起来更快、更方便。
在 DOM 的树状结构中,HTML 文档由一系列节点组成。以下是几种常见的节点类型:
- 属性节点(class、ID、href 等)
- 文本节点表示 HTML 元素中的文字内容
- 元素节点,例如段落和区块(<p>、<div>、<a>等)
值得注意的是,DOM 结构具有层级关系:父节点下面有子节点,而拥有相同父节点的子节点彼此之间则是兄弟节点。JavaScript、Selenium 等工具正是借助 DOM 来高效操作页面内容,无论是添加元素还是获取特定信息。
如何使用浏览器开发者工具检查元素
理解网站结构,是用 Python 进行网络爬取的坚实第一步。但是,该去哪里查看 HTML 内容呢?幸运的是,查看网站代码非常简单:打开浏览器开发者工具,屏幕右侧就会出现一个窗口,里面包含大量有价值的信息,包括 HTML 代码。
在 Windows 系统下,按 ctrl + shift + j 即可打开开发者工具;Mac 用户则需要进入 Safari 设置的高级选项,开启“为 Web 开发者显示功能”。接着选择一个作为示例的网站(本文将继续使用MarsProxies.com),打开它并按下这个组合键,就会看到屏幕右侧弹出一个新窗口——这就是开发者工具。
开发者工具会显示很多信息,比如网络活动、性能、状态更新,以及 SSL 证书验证等安全信息。本文中最重要的是 Elements 部分,点击它,就能看到我们示例中的内容:
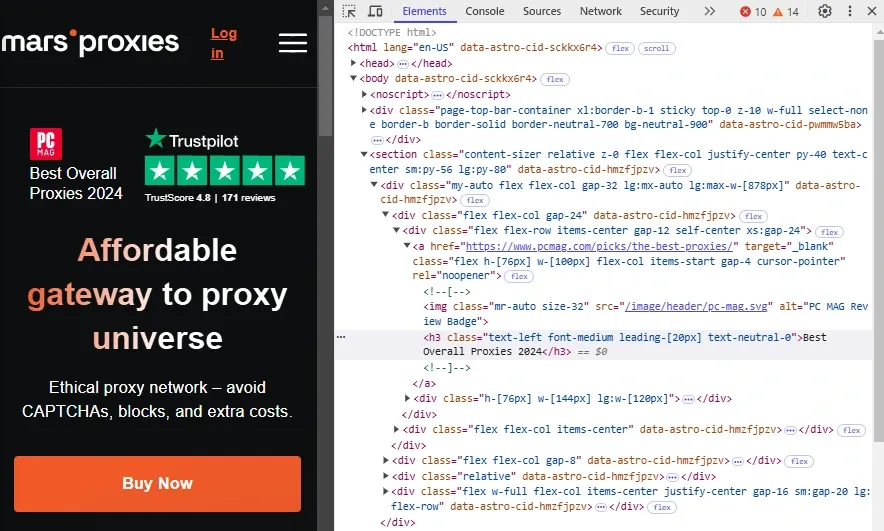
请注意下图中选中的 `h3` 元素。它包含诸如 `font-medium` 和 `text-neutral-0` 之类的类属性,你可以利用这些属性抓取所有具有相同类的元素;或者,根据你的需求和网站布局,也可以直接针对所有的 `h3` 元素进行抓取。
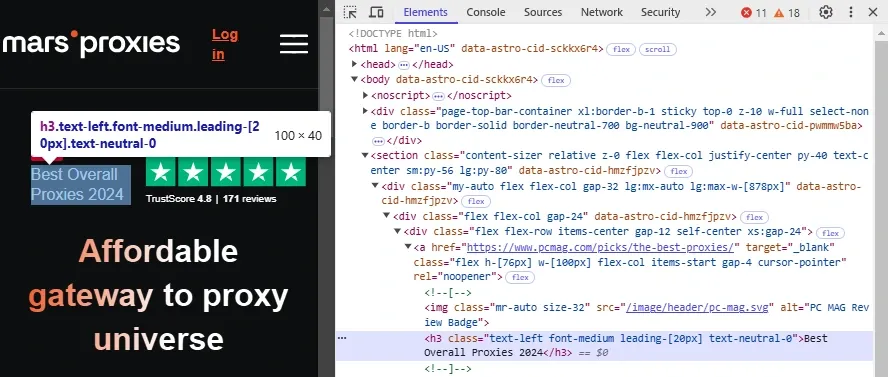
最后,检查特定元素是获取其相关信息的有效方法。你可以右键点击目标元素,然后从下拉菜单中选择“检查”(Inspect)。
例如,当我们点击“Best Overall Proxies 2024”这段文本时,开发者工具随即在相应位置打开。这样一来,你无需手动翻阅冗长的 HTML 代码来查找目标,即可直接选中所需元素。掌握这些信息后,你便可以利用类名(class)、属性(attribute)、CSS 选择器等多种方式来构建爬虫。
Python 网络爬虫基础
现在,你已掌握了进行基础数据抓取所需的足够信息。此外,请记住,尽管目前已有经验丰富的网络抓取专业人士,但这仍是一种相对较新的在线数据收集方法。
许多抓取专家都是从利用开发者工具分析 HTML 内容起步,并在实践中不断积累知识的——这是一种极佳的学习方式!让我们再次回顾 Python 网络抓取的关键要素,以巩固最重要的细节。以下是网络抓取的一般工作流程:
选择数据与网站
首先,明确实现目标所需的数据。接着,找到包含这些信息的网站。在此阶段,请务必确认收集此类信息完全合法,并遵守该网站的抓取规则——关于这一点的更多信息,请参阅“网络抓取中的道德规范”一节。
检查 HTML 代码
首先检查网站的元素。右键点击目标元素,从下拉菜单中选择“检查”(Inspect)。查看元素的标签、类名和属性,以便后续进行抓取时使用。
收集工具
既然已经了解了目标网站的类型,接下来就可以选择相应的工具了。我们建议大家安装 Requests 库,因为它能简化数据抓取过程中的关键环节——即发送 HTTP 请求。
如果需要抓取静态 HTML 内容并进行高效解析,可以使用 Beautiful Soup;但如果面对的是包含大量 JavaScript 的动态网站,则建议使用 Selenium。此外,在此阶段也请准备好 IDE、代理服务器以及其他计划使用的工具。
开发代码
现在,你可以着手编写代码来抓取数据了。本文已提供了入门所需的 Python 基础代码,但你很快就能掌握更多功能。起初,这一切或许让人感到有些吃力,但请坚持下去,寻求突破——这需要时间、耐心与努力。随着你掌握更高级的 Python 网络爬虫代码,你将能够应对更具挑战性的数据源。
存储数据
当您收集了所需的信息后,您必须将其存储在某个地方。大多数抓取工具都有内置工具来以 CSV、JSON 和 XML 格式存储信息。选择您所需的格式并保存抓取的数据。请记住,抓取个人身份信息需要加密以防止数据泄露。
解析 HTML 内容
收集信息固然是关键环节,但成功的网络抓取通常还涉及数据解析。数据解析的作用是将信息从一种格式转换为结构更规范的格式,使其既能被其他计算机程序使用,又能让人类直观阅读。
回想一下本文前面提到的例子:我们向 MarsProxies.com 发送了 HTTP GET 请求,获取了一段长达数百行的 HTML 字符串内容——直接解读这些内容极其困难。因此,在进行网络抓取时,我们建议尽可能明确具体的数据需求,并利用 Beautiful Soup 等库对数据进行解析。
使用 Beautiful Soup 解析 HTML
如果你继续学习 Python 网络爬虫,很可能也需要学习 Beautiful Soup。请参考我们之前提供的简明指南来安装它,并从完整的 HTML 内容中解析出所需的元素。
Beautiful Soup 屏蔽了 HTML 的复杂性,简化了对 HTML 和 XML 文档的处理。同时,它还允许利用 `select()` 和 `find_all()` 等数据查找功能,在这些文档中进行搜索。
遍历 DOM 以查找元素
积累了一定的网页抓取经验后,你经常会面对 DOM “树”结构,而不仅仅是复杂的 HTML 文件。此时,Beautiful Soup 再次展现了其巨大价值,它能将 HTML 代码解析为易于理解的 DOM 树结构。随后,你可以使用诸如 `h1 = soup.h1` 的代码来获取第一个 `<h1>` 标签,或者使用 `paragraph = soup.find("p", class_="example")` 来抓取第一个类名为 "example" 的 `<p>` 元素。
在处理 DOM 时,你还可以利用各种选择器(如 `.parent`、`.children`、`.previous_sibling` 等)。这不仅丰富了数据查找的定制化选项,还能让你更快速、更高效地抓取文档内容。
提取文本、链接和图像
除了文本之外,您还可以利用 Python 提取链接和页面元素。不过,在抓取视觉素材时,务必遵守版权法规。抓取受版权保护的内容属于违法行为,尤其是将其用于商业目的时。在确保符合法律规定的前提下,以下是一个使用 Python 抓取图像的示例。
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.chrome.service import Service
from webdriver_manager.chrome import ChromeDriverManager
from selenium.webdriver.support import expected_conditions as EC
driver = webdriver.Chrome(service=Service(ChromeDriverManager().install())) driver.get("https://www.marsproxies.com")
images = driver.find_elements(By.TAG_NAME, "img")
for image in images:
src = image.get_attribute("src")
alt = image.get_attribute("alt")
if src:
print(f"Image: {src}, Alt: {alt}")
请记住,Python 代码必须符合缩进要求;不过,代码本身会直观地遵循缩进逻辑,或者在报错信息中指出相关问题。在本例中,按下回车键后,我们得到了以下结果:
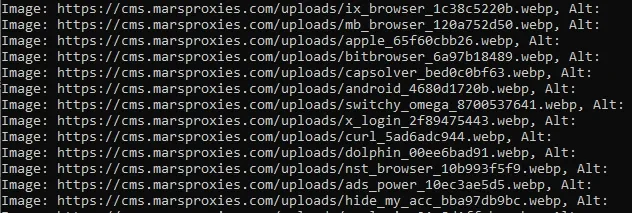
在此,Python 抓取了我们在着陆页上发现的所有图片的 URL(这张图片仅代表整个数据集的一小部分)。既然已经获取了每张图片的地址,我们就可以利用网络爬虫将其下载下来。
再次强调,这仅仅是一个示例;在抓取任何视觉素材之前,请务必确保相关行为合法并遵守版权法规。
用 Python 抓取数据时避免 IP 被封禁
获取住宅代理处理由 JavaScript 渲染的内容
获取准确且完整的数据集是网页抓取中最关键的环节之一。毕竟,如果无法完全信赖所获取的信息,那么抓取这些信息又有何意义呢?正因如此,掌握能够处理 JavaScript 动态加载内容的工具至关重要。
JavaScript 赋予了网站动态交互的特性,因此被广泛应用。如果仅使用 Requests 等基础库来抓取大量依赖 JavaScript 的网站,虽然能获取 HTML 源码,却无法抓取那些由 JavaScript 随后加载的页面元素。
因此,我们再次建议您熟悉 Selenium,以便高效地抓取 JavaScript 驱动的网站。Selenium WebDriver 的 Python 库能够自动控制真实的浏览器,并完整加载页面,从而确保所有 JavaScript 元素都能被正确渲染。
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
from selenium.webdriver.chrome.service import Service
from webdriver_manager.chrome import ChromeDriverManager
driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()))
driver.get("https://www.marsproxies.com")
WebDriverWait(driver, 10).until(
EC.presence_of_element_located((By.TAG_NAME, "img"))
)
images = driver.find_elements(By.TAG_NAME, "img")
for image in images:
src = image.get_attribute("src")
alt = image.get_attribute("alt")
if src:
alt_text = alt if alt else "No alt text provided"
print(f"Image: {src}, Alt: {alt_text}")
本示例同样旨在从网站提取图像,所使用的 Selenium 代码与上一个示例类似。不过,我们增加了一个 `WebDriverWait(driver, 10)` 函数。对于那些严重依赖 JavaScript 的网站,这一微小的改动至关重要,因为它指示 Selenium 最多等待 10 秒,直到至少有一张图像完全加载。
这样一来,该库就能确保 JavaScript 有足够的时间渲染所有页面元素,从而在获取数据时保证收集结果的完整性与准确性。
配置 Selenium 以进行高级网页抓取
你准备好更进一步,尝试一些进阶技巧了吗?我们在下文简要概述了 Selenium 的几项高级功能,但要全面深入探讨这一主题,则需要另写一篇文章。
设置等待时限
我们之前已经介绍过 `WebDriverDict(driver, x)` 函数,但务必记住要设置等待时限。获取由 JavaScript 渲染的元素是 Selenium 的关键特性之一,而等待函数能确保你不会遗漏任何重要内容。
自定义用户代理
User Agent(用户代理)是包含有关用户及其网络浏览器信息的文本字符串。网络爬虫通常需要在多个 User Agent 之间切换,因为如果始终使用同一个 User Agent 进行数据采集,即便使用了网络代理来保持匿名,也可能会导致访问受限。
Selenium 提供了更改 User Agent 的工具。请使用以下代码:
options = webdriver.ChromeOptions() options.add_argument("user-agent=Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/114.0.0.0 Safari/537.36")
driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()), options=options)
在本例中,我们使用了 Chrome 114 版本的 User-Agent;您只需在 Google 上快速搜索,即可找到适用于其他浏览器的更多 User-Agent 字符串。
添加代理
对于高级网络爬取任务而言,代理服务器极具价值,因为它们允许在不被检测到的风险下针对多个网站进行抓取。以下是如何使用 Selenium 命令配置代理的方法:
options = webdriver.ChromeOptions()
options.add_argument("--proxy-server=http://your_proxy_address:port")
driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()), options=options)
如果您希望在不暴露原始 IP 地址的情况下进行数据抓取,我们也建议您尝试轮换式住宅代理。
运行无头浏览器以提高效率
掌握了网页抓取的基础知识后,您可以尝试将 Selenium 用作无头浏览器(headless browser)。这种浏览器与普通浏览器无异,只是没有图形用户界面(GUI),因此您需要通过 Selenium 命令来控制它。以下是具体的设置方法:
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from webdriver_manager.chrome import ChromeDriverManager
from selenium.webdriver.chrome.options import Options
options = Options()
options.add_argument("--headless=new")
driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()), options=options)
driver.get("https://www.marsproxies.com")
print(driver.title)
driver.quit()
这种用于网页抓取的浏览器类型有几个优点。首先,它更加资源友好,并且不会消耗太多的内存和 CPU 功率。由于它不使用 GUI,因此它的运行速度也比传统浏览器更快。最后,一旦您掌握了高级 Selenium 功能,您就可以自动化无头浏览器来抓取大量数据并扩展您的操作。
网页抓取中的伦理规范
由于少数滥用网页抓取技术的负面案例,这一做法在某些圈子里名声不佳。但必须明确的是,网页抓取仅仅是一种自动获取数据的手段。
正如所有工具一样,它既可用于正当用途,也可能被用于非法活动;因此,在从网站收集信息时,请务必遵循合乎道德的网页抓取规范。
理解并尊重 robots.txt
大多数网站都使用 robots.txt 文件来告知网络爬虫(及数据抓取机器人)哪些部分是可以访问的。在允许的范围内,您可以自由收集信息;但在受限区域进行数据抓取可能会引起关注,有时甚至会导致严重的法律问题。
robots.txt 文件通常位于网站根目录下,例如 https://www.MarsProxies.com/robots.txt。此外,Python 提供了专门的函数来获取并解析 robots.txt 文件,让您清楚地看到哪些内容允许抓取。
在请求之间设置延迟和随机间隔
如果发送网络爬取请求的速度过快、数量过多,可能会拖慢网站速度,甚至造成服务器过载。首先,这会影响网站性能,网站所有者可能因此采取措施屏蔽您。即便没有拖慢网站速度,反爬虫算法依然可能将您封禁。
因此,建议为爬虫配置请求延迟和随机的网络爬取间隔,使其行为更接近真实用户,避免引起注意。
如何在 Python 网络爬取中规避检测
许多企业和网站所有者一方面限制爬虫抓取,另一方面自己却在抓取竞争对手的数据。例如,Amazon 拥有成熟的反爬虫防护系统,但自身也会大规模抓取网络数据以保持竞争优势。
以下是几种在 Python 网络爬取中规避检测的技巧。
防止 IP 被封禁的策略
以下方法可以帮助您在抓取过程中避免 IP 被封禁。首先,可以考虑使用代理服务器。代理服务器会隐藏原始用户 IP 地址,并以其他 IP 代替,使网站无法识别出不同 IP 背后其实是同一个发起抓取请求的用户。
即使某个代理 IP 因故被封禁,您也可以直接切换到另一个 IP 继续任务。对于网络爬取,建议使用住宅轮换代理,因为它们具备可靠的隐私保护能力,并会定期更换 IP 地址以规避检测。
此外,建议轮换 User-Agent,让数据采集请求看起来像是来自不同的真实浏览器。同时设置请求延迟和速率限制,避免爬虫引起注意,使其行为更接近真实用户。
最后提醒您,务必遵守所在国家的数据安全法律以及 GDPR、CCPA、HIPAA 等国际法规,切勿利用网络爬取或代理从事任何违法活动。执法机构拥有充分的手段追踪网络用户。网络爬取本质上是一种广泛应用于数据科学领域的数据采集与分析工具,使用时应始终遵守法律边界。
结语
如果您已经读到这里,说明您已成功搭建好 Python 环境,可以开始网络爬取了。无论您已有一定经验、想要进一步深入,还是刚刚入门,都建议从 Requests 和 Beautiful Soup 这两个库学起。
此外,建议为不同的 Python 抓取项目分别创建虚拟环境。这样一来,各项目所使用的库就不会因版本差异而相互冲突,便于您更高效地管理每个项目。
接下来,最好的办法就是动手做一个真实项目。可以从一个简单的想法入手,比如抓取电商网站上的游戏折扣信息,或使用 Selenium 自动化登录流程。虽然本文已经介绍了基础的 Python 代码供您入门,但实际代码几乎总会因具体场景而有所不同。
最后提醒您,务必格外注意数据安全相关法律:尽量避免采集可识别个人身份的数据,也不要抓取受版权保护的内容,否则可能面临法律风险。除此之外,网络爬取相关人才需求旺盛,这项技能也可能为您带来不错的职业发展机会。
您还可以阅读我们关于HTTPX vs Requests vs AIOHTTP的文章。