人们每天产生的数据量约为 3.2877 亿 TB,而全球 90% 的数据都是在过去两年内生成的,这一趋势让网络数据抓取迅速成为强大的数据采集与分析工具。但网络数据抓取究竟是什么?又该如何从中获利?我们一起来看看。
网络数据抓取是通过自动化或手动方式采集在线数据,以发现更优价格、分析竞争对手或监控品牌声誉的过程。最终,这一过程能帮您获得可用于个人项目或出售给第三方的数据集。
关于网络数据抓取,您需要了解什么?
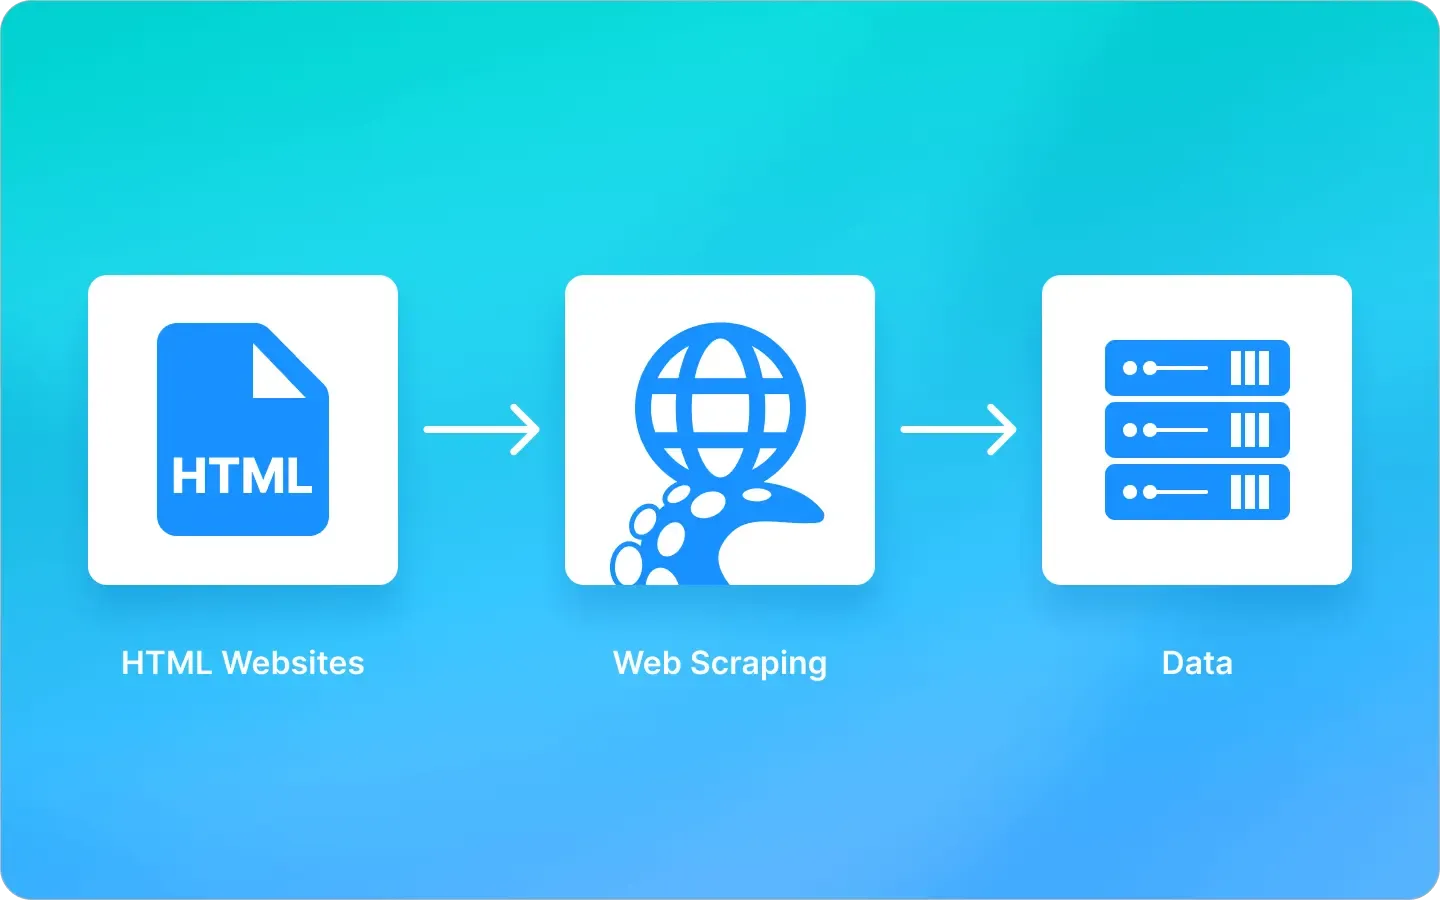
“数据抓取”常与“数据解析”一同使用,但网络数据抓取特指提取在线信息的过程。相比之下,解析纯粹是对数据的分析,并不涉及在线服务的扫描。数据抓取还与网络爬取密切配合,后者负责在提取数据之前发现并遍历网页。
网络数据抓取的流程通常包括以下步骤:
1. 确定目标数据来源
2. 开发或购买抓取机器人
3. 从该来源提取数据
4. 整理数据
5. 将信息整理成清晰、可用的表格
值得注意的是,许多网站会设置防护措施以防止未经授权的数据采集,例如隐藏电子邮箱地址、限制对敏感数据的访问,从而保护用户隐私、商业机密和知识产权。
为避免违反网站政策,应重点采集公开可访问的通用信息,避免采集个人信息或受密码保护的数据。合乎道德的数据抓取还包括尊重数据所有权,不将采集到的数据冒充为原创内容。
此外,还需考虑请求的数量和时机。规模较小的网站可能因流量过大而不堪重负,甚至导致网站崩溃。为将影响降到最低,应限制请求频率,并在非高峰时段运行脚本,例如深夜时段,以减轻服务器负担。另外,请务必使用信誉良好的住宅代理,以避免被检测、IP 被封或遇到地理限制。
如何通过网络数据抓取赚钱?
网络数据抓取在不同行业中有多种可实现盈利的应用方式。以下是几种通过网络数据抓取赚钱的常见方法:
- 竞争情报分析
企业通过网络数据抓取监控竞争对手的价格和服务,从而调整自身定价以保持竞争力。这种 基于数据驱动的方式能帮助企业提升利润,具体做法是依据实时数据将产品定价控制在具有竞争力的区间。
- 开发并出售抓取机器人
开发能简化信息采集流程的机器人可以带来可观收益。这类机器人能够扫描网页寻找优惠信息、按设定条件整理数据,并筛选出最优方案——非常适合用于查找旅行住宿、承包商或销售机会。能够聚合内容或追踪全网品牌提及情况的机器人同样需求旺盛,出售这类脚本或软件也能带来利润。
- 转售折扣商品
通过抓取网店中的折扣商品信息,您可以买入降价商品并转售获利。脚本可以追踪降价情况、计算折扣比例并找出最优惠的商品。购入折扣商品后,您可以按介于原价与折扣价之间的价格转售以获取利润。
- 销售数据
数据对机器学习、分析及各类预测应用都至关重要。能够采集并以可用格式整理数据的抓取工具,可以将这些信息出售给需要结构化数据集的企业,例如需要分析球员和球队数据来计算赔率的 AI 开发者或博彩公司。
- 销售广告
这种方法可以运用在内容丰富的网站和项目上,比如 Lisbdnet.com。该网站收集了大量热门Google搜索查询,并结合相关的 YouTube 视频生成内容,从而在搜索结果中获得较高排名,吸引了数百万次访问。该网站在被下线前,一直通过广告投放获利。您也可以打造一个类似的、以 AI 生成内容为主的内容型网站,在不冒封禁风险的情况下吸引访客并通过广告赚钱。
每一种方法都体现了网络数据抓取多样化的变现潜力,在当今的数字经济中,数据正逐渐成为一种可交易的商品。
2025年用网络数据抓取赚钱,避开IP封锁
购买住宅代理网络数据抓取需要哪些工具?
抓取工具每天能够高效扫描数百乃至数千个网页,而各种工具都可以帮助实现这一流程的自动化。下面介绍几种常见的热门选择:
- Octoparse、DataOx、ScrapingBot
这些工具操作简单,开箱即用,非常适合编程经验较少的用户。虽然配置过程简单,但主要缺点是它们都是付费方案,且试用版功能通常有限。
- Beautiful Soup、Requests、lxml、Cheerio、Puppeteer
此类自动化库可以将抓取流程中的特定步骤自动化。不过,它们并非完整抓取方案的独立解决方案,通常还需要一定的编程知识。
- Scrapy、Selenium、Apify SDK
这些框架包含多种工具,可用于以多种格式提取、分析和存储数据,能为较为复杂的网络数据抓取项目提供更稳健的解决方案。
- JavaScript、Python、Go、PHP
您可以自行编写脚本,也可以使用现成的机器人来扫描网页、提取内容并整理数据。这种方式需要一定的编程知识,但能提供更高的灵活性。
使用代理对于高效开展网络爬取与网络数据抓取都至关重要,原因主要有以下几点:
- 防止被封锁
抓取服务通常会向网站发送大量请求,这可能触发反欺诈系统,导致您的 IP 地址被封锁。为避免这种情况,应使用轮换代理,并合理设置请求频率,降低被识别为可疑行为的概率。
- 绕过地理位置限制
部分网站会根据用户的地理位置提供不同内容,您可以使用具备所需地理位置的代理来访问目标内容。
部分网站还会追踪数字指纹,也就是用于识别用户身份的设备数据。像Octo这样的多账号反检测浏览器能够有效绕过这种防护手段。Octo Browser提供以下功能:
- 数字指纹
您可以使用真实设备的真实指纹,从而降低 Octo Browser 的操作行为引起安全系统怀疑的可能性。
- API 支持
进阶用户可以借助 Octo 功能丰富的 API 实现网络数据抓取任务的自动化,从而提升效率。
- 代理管理
该浏览器提供简洁的代理服务器管理功能,让您能够轻松添加并保存各类代理。
- 虚拟配置文件
用户可以直接使用虚拟配置文件进行操作,无需启动浏览器客户端应用。
我们还为读者准备了专属优惠——即日起使用Octo Browser,即可享受7 天免费 Base 订阅,只需输入优惠码MARSPROXIES30,首次购买还可享受 30% 折扣!快来体验强大功能,提升您的网络数据抓取项目吧。
比起 Python 更喜欢用 Go?我们的Golang 网络数据抓取指南将带您从零开始构建一个抓取工具。
总结
无论是手动浏览网页还是使用自动化机器人,网络数据抓取都是一种合法的在线数据采集方式。这一过程还包括对采集到的数据进行清洗和整理,以便将其用于各类商业用途或对外出售。
使用 Octo Browser 这类多账号浏览器,能够通过保障匿名性、降低物理服务器相关运营成本,并简化身份验证、验证码处理等人工操作,提升网络数据抓取的使用体验。对于希望借助网络数据抓取来采集数据的用户而言,理解并善用这些工具至关重要。