在用 Python 解析 HTML 和 XML 内容时,lxml 库是一款功能强大的工具。本 Python lxml 教程将介绍如何用 lxml 完成网络爬取任务和 XML 处理,内容涵盖从安装、基础解析到 XPath、CSS 选择器等进阶用法的全部要点。
别担心,本文会逐步拆解每个概念。无论您是要从网页的 HTML 文档中提取信息,还是在后台处理 XML 文档,这篇指南都能帮您充分用好 Python lxml 库。
什么是 lxml,为什么要用它?
lxml是一个用于处理 HTML 和 XML 数据的 Python 库。它将 Python 内置 ElementTree 易用的 API 与 C 语言库的速度结合在一起(底层基于成熟的 libxml2 和 libxslt 构建),兼具简单易用与高性能。实际使用中,lxml 可以非常高效地解析和创建 HTML 或 XML 文档。
相比其他库,lxml 的优势包括:
- 高性能
由于 lxml 底层使用经过优化的 C 代码(libxml2 负责解析,libxslt 负责 XSLT 支持),即便面对大型或复杂文档,也能保持速度快、内存占用低的特点。当您需要从多个页面或大型 XML 文件中快速提取数据时,这一点尤为重要。
- 功能丰富
lxml 库支持完整的 XPath 1.0、XSLT 转换以及 XML Schema 校验等高级功能。相比之下,Python 内置的 xml.etree 只提供基础解析能力,XPath 支持也十分有限。
- 兼顾 HTML 与 XML
lxml 既能处理格式规范的 XML 文档,也能应对现实中结构混乱的 HTML 文档。它提供了用于 XML 的 etree 模块和用于 HTML 的 html 模块,为两种格式分别配备了合适的工具。例如,严格的 XML 解析可以用 lxml import etree,而宽松的 HTML 解析则可以用 lxml import HTML。
- 何时该用 lxml
当项目需要从网页解析 HTML(也就是网络爬取!)、处理 XML 文件数据,或者对性能有较高要求时,都适合选择 lxml。如果您需要通过复杂查询从大量页面中提取数据,lxml 是不错的选择。由于速度快、稳定可靠,它在生产环境的数据抓取场景中被广泛使用。
和其他方案相比,lxml 往往能在易用性与性能之间找到较好的平衡。像 BeautifulSoup 这类纯 Python 解析器非常易用,对格式不规范的 HTML 也很宽容,但速度较慢。内置的 xml.etree 适合处理基础任务(且无需额外安装),但在处理大文件时可能受限、速度也较慢。
lxml 兼具二者的优势:友好的 API 与 C 语言级别的性能。因此,其他工具(比如 Scrapy 的 Parsel,甚至 BeautifulSoup 本身)常常在底层调用 lxml,也就不奇怪了。
安装 lxml 并完成首次解析
在深入代码之前,先安装 lxml 并运行一次简单的解析,确保一切正常。
如何安装 lxml
安装 lxml 非常简单,最简便的方法是在命令行中使用 pip:
pip install lxml
该命令会从 PyPI 下载并安装 Python lxml 库。在大多数系统上,直接运行即可。如果您同时安装了 Python 2 和 3,可以用 pip3 install lxml 来指定安装到 Python 3。
平台注意事项
- Windows
pip 通常会为您的 Python 版本获取预编译好的 lxml wheel 包,因此不需要编译器或其他额外工具。只需确保 pip 是最新版本。如果遇到问题,可以安装最新的 Microsoft Visual C++ Build Tools(针对较旧版本),并尝试执行 pip install --only-binary=lxml lxml 以强制使用二进制 wheel 包。
- Linux
如果 pip 需要自行编译 lxml,您可能需要先安装开发头文件。例如在 Debian/Ubuntu 上,运行 pip 之前先安装 libxml2-dev 和 libxslt-dev(以及 python3-dev)。不过多数情况下,pip 会直接找到适配您平台的预编译 wheel 包。
- macOS
通过 pip 安装通常很顺畅。如果在 Mac 上(尤其是较新的 M1/M2 芯片)遇到编译错误,请确认已安装 Xcode Command Line Tools(执行 xcode-select --install)。如有需要,也可以用 Homebrew 执行 brew install libxml2 libxslt,但大多数情况下 pip install lxml 已经足够。
另一个选择是使用 Conda(执行 conda install lxml),如果您在用 Anaconda/Miniconda,这种方式会很方便,Conda 会自动处理底层 C 语言库的依赖关系。
安装完成后,您可以打开 Python REPL 并导入 lxml 来验证:
>>> import lxml
>>> from lxml import etree
>>> print(lxml.__version__)
4.9.3  # (Your version may differ)
如果没有报错并打印出版本号,就说明一切就绪!
首次解析示例
让我们通过一个简单示例来看看 lxml 的实际效果。我们将解析一段小型 XML 字符串并查看其内容,由此了解 lxml 的核心解析接口:etree 模块(ElementTree API)。
from lxml import etree  # import the etree submodule
# Define a simple XML string
xml_data = "<root><child>Hello</child></root>"
# Parse the XML string into an Element
root_element = etree.fromstring(xml_data
# Access data from the parsed XML
print(root_element.tag)        # prints "root"
print(root_element[0].tag)     # prints "child"
print(root_element[0].text)    # prints "Hello"
来拆解一下这里发生了什么:
- 我们通过 lxml import etree 引入了 etree 模块,它提供了 XML 解析能力。
- etree.fromstring(xml_data) 会解析这段 XML 字符串,并返回 XML 树的根元素(一个 <Element> 对象)。这是在内存中快速解析一段 XML 片段的方式。此时变量 root_element 代表的就是 <root> 元素。
- 我们可以把 root_element 当作子元素的容器来处理。root_element[0] 会返回第一个子元素(即 <child> 元素),接着我们打印出了它的标签名和文本内容。
- 输出结果显示根标签为 "root"、子标签为 "child",以及位于子元素内部的文本 "Hello"。
在底层,lxml 根据这段 XML 字符串构建出了一个树结构。fromstring 函数适合处理字符串,而对于文件或更大的文档,我们通常会使用 etree.parse(),稍后就会看到。目前为止,我们已经成功让 lxml 读取了 XML
用 lxml 创建与解析 XML/HTML
现在我们已经安装好 lxml,也看过了基础解析示例,接下来看看如何从零创建 XML 结构,以及如何从字符串或文件中解析 XML 和 HTML 内容。lxml 库在构建 XML 树和解析现有数据这两方面都表现出色。
创建 XML 树
lxml 的一项强大功能,是能够直观地创建或修改 XML/HTML 树。您可以借助 Element 类以编程方式构建 XML 文档,这对于生成 XML 配置文件或以编程方式准备 HTML 等任务非常实用。
构建 XML 时,通常使用 etree.Element 创建节点,用 etree.SubElement 添加子节点,也可以为元素设置文本和属性。来创建一个简单的 XML 树:
from lxml import etree
# Create a root element
root = etree.Element("books")

# Create a child element with a tag and add text to it
book1 = etree.SubElement(root, "book")
book1.text = "Clean Code"

# You can add attributes to elements (e.g., an id)
book1.set("id", "101")

# Add another book entry
book2 = etree.SubElement(root, "book")
book2.text = "Introduction to Algorithms"
book2.set("id", "102")

# Convert the XML tree to a string and print
xml_str = etree.tostring(root, pretty_print=True, encoding='unicode')
print(xml_str)
这段代码会生成如下结构的 XML:
<books>
  <book id="101">Clean Code</book>
  <book id="102">Introduction to Algorithms</book>
</books>
我们做了以下操作:
- 创建了一个根元素 <books>(可以把它理解成 XML 中的 <books></books>)。
- 通过 etree.SubElement 在根元素内添加了两个 <book> 子元素,并将每个 book 元素的文本设置为对应的书名。
- 我们还通过 .set(name, value) 方法为每个 <book> 添加了 id 属性,该方法会为元素添加一个属性键值对。
- 最后,我们使用 etree.tostring 将 XML 树序列化回字符串(设置 pretty_print=True 以美化格式),这在查看输出结果或保存为 XML 文件时很有用。
关于元素属性的简要说明:每个元素都有一个 .text 属性,用于存放元素内部的文本,以及一个 .tail 属性,用于存放元素之后的文本(适用于兄弟标签之间存在文本的情况)。在示例中,我们只用到了 .text。此外,元素的属性可以通过类似字典的 .attrib 属性,或 .set 和 .get 方法来访问。
例如,在我们的代码中,book1.attrib 会是 {'id': '101'}。.text、.tail 和 .attrib 这三个属性,涵盖了一个元素的全部文本和属性内容。
从字符串和文件解析
lxml 可以解析多种来源的内容,包括内存中的字符串、本地文件,甚至网页内容。前面我们已经用 etree.fromstring 解析了内存中的字符串;对于磁盘上的 XML 文件,则可以使用 etree.parse;对于 HTML 内容,lxml 同样提供了几种方式。
从文件解析 XML
假设您有一个 example.xml 文件,可以这样解析:
tree = etree.parse("example.xml")
root = tree.getroot()
parse 函数会读取该文件并返回一个 ElementTree 对象,接着我们通过 getroot() 获取根 <Element>。需要注意的是,etree.parse 返回的是一个树对象(可以理解为整份文档),而 etree.fromstring 返回的则是单个根元素。
实际使用中,您通常不会太在意其中的差异,但这也解释了为什么需要用 parse(...).getroot() 来获取元素。
解析 HTML 内容
HTML 并不总是符合规范的 XML,标签可能没有正确闭合等问题时常出现。lxml 提供了 lxml.html 模块(可通过 lxml import HTML 访问)来处理 HTML,常见的用法有两种:
- 使用 lxml.html:
from lxml import html
doc = html.fromstring(html_string_or_bytes)
这会解析一段 HTML 字符串(或来自网页的字节数据),并返回代表 HTML 文档根节点的 Element(通常是 <html> 元素)。它的设计目标就是应对常见的 HTML 格式问题。
- 使用 etree.HTML:lxml 的 etree 提供了一个便捷的 HTML 处理函数:
doc = etree.HTML("<p>Hello</p>")
这会创建一个 HTML 树。例如,etree.HTML("<p>Hello</p>")实际会生成一个完整结构:<html><body><p>Hello</p></body></html>。由于我们传入的只是一个片段,lxml 会自动为其补上必要的 <html><body> 标签。
上述两种方法效果相近,底层都使用了针对 HTML 调优的同一套解析器。关键在于,lxml 的 HTML 解析器十分宽容——即使面对 HTML 和 XML 混合的内容,或是格式错乱的 HTML,依然能够构建出树结构。事实上,lxml 对 HTML 的支持足够稳健,在许多情况下都能妥善处理现实中格式不佳的 HTML。
选择 XML 解析还是 HTML 解析
如果您确定自己处理的是格式良好的 XML(例如 RSS 订阅源或 XML 配置文件),可以使用etree.fromstring或etree.parse配合 XML 解析器来处理;如果处理的是网页或 HTML 片段(可能不是完全规范的格式),则使用lxml.html.fromstring或etree.HTML。lxml 库会针对不同情况自动采用合适的解析规则。
此外,lxml 还支持自定义解析器选项,例如可以创建 etree.XMLParser 或etree.HTMLParser,并设置诸如从错误中恢复、去除空白文本等选项;不过在大多数情况下,使用默认设置即可。
在 lxml 中使用 XPath 和 CSS 选择器
将 HTML 或 XML 文档解析为 lxml 树之后,下一步通常是从中提取数据,lxml 提供两种强大的元素查找与筛选方式:XPath和 CSS 选择器。许多开发者认为 XPath 非常强大,也有人更习惯使用熟悉的 CSS 选择器语法,下面我们来分别介绍这两种方式。
XPath 查询
XPath 是一种专门用于遍历 XML/HTML 树结构的查询语言,lxml 对 XPath 的支持非常完善:您可以在任意元素(通常是根元素)上调用 .xpath() 方法并传入 XPath 字符串,返回结果是匹配到的元素或值组成的列表。
XPath 基础
- / 表示从根节点开始选择,而 // 表示从当前节点开始在任意深度(所有后代节点)中查找。
- 使用标签名来选取元素(例如 //div 可以查找所有 <div> 标签)
- 可以使用 [@attr="value"] 按属性筛选元素,例如 //a[@href="home.html"] 可以查找具有特定 href 的 <a> 标签
- 使用text()获取文本节点,使用@attr获取属性值
- 可以使用索引选取特定位置的元素(例如(//p)[1] 表示第一个 <p>)
- 此外还可以使用条件表达式,例如//span[contains(@class, "price")],用于匹配部分 class 名称等情况
XPath 使用示例
假设我们已经用 lxml 解析好一个 HTML 文档(例如通过 lxml import HTML as doc 得到 doc),现在想获取<nav>区域中所有链接的 URL 及其文本,可以这样写:
# Get all link URLs in the nav
links = doc.xpath('//nav//a/@href')
# Get all link texts in the nav
link_texts = doc.xpath('//nav//a/text()')
我们的做法如下:
- //nav//a/@href 表示:查找任意 <nav> 下(任意深度)的所有 <a> 标签,并返回它们的href属性,lxml 会返回由 href 字符串组成的列表
- //nav//a/text() 表示:返回 <nav> 中每个 <a> 标签的文本内容
XPath 可以写得非常复杂(涉及函数、轴等概念),不过上面展示的已是常见用法。由于 lxml 底层基于 libxml2,它完整支持 XPath 表达式(XPath 1.0 标准),这是Python内置库所做不到的
选取节点与选取值
注意,当我们使用@href或text()时,得到的是字符串;如果省略这些,直接执行doc.xpath('//nav//a'),得到的则是一个由 Element 对象组成的列表(每个都是 <a> 元素),之后可以继续对每个元素进行查询,或通过.text 或 .get('href') 获取其文本和属性。
示例:条件 XPath 与层级结构
假设我们有一份图书 XML 数据,想获取价格低于 20 的图书标题,可以使用 XPath://book[price<20]/title/text();如果价格是一个属性,则写作://book[@price<20]/title/text()。这说明我们可以在方括号中添加条件来筛选节点
XPath 在解析 HTML 和 XML 时功能十分强大,因为它不仅可以按标签名查找,还能根据结构和条件进行导航。虽然需要一定的学习成本,但它可以用一条表达式精确获取所需内容。
用 lxml 抓取多个网页时避免被封禁
开始抓取lxml 数据抓取教程
接下来是有趣的部分:一个使用 lxml 进行数据抓取的简短教程。我们将逐步演示如何获取网页并从中提取数据,本示例使用 requests 库获取页面内容,再用 lxml 进行解析和提取。
请务必在遵守相关法律法规及服务条款的前提下进行数据抓取;如果需要抓取多个页面,使用稳定可靠的真实住宅代理有助于降低被网站封禁的概率
假设我们想从某个示例网站抓取图书标题和价格列表(本例使用公开的 Books to Scrape 网站进行演示)。
第一步:获取网页 HTML
使用requests库(或任意 HTTP 客户端)下载页面内容
import requests
url = "http://books.toscrape.com/"
response = requests.get(url)
html_content = response.content  # raw HTML bytes
现在页面的 HTML 已保存在html_content中。使用 .content 得到的是字节数据,也可以用 response.text 得到 Unicode 字符串,不过对 lxml 来说字节数据同样适用
第二步:使用 lxml 解析 HTML
接下来,我们将这段 HTML 内容解析为一棵 lxml 树。
from lxml import html
doc = html.fromstring(html_content)
这里我们通过 from lxml import html 并调用 html.fromstring(...) 获取解析后的文档,此时变量 doc 即为 HTML DOM 的根节点(通常是一个 <html> 元素)
第三步:使用 XPath 或 CSS 选择器提取数据
现在我们的目标是获取页面中所有图书的标题和价格。如果查看 Books to Scrape 页面的 HTML(可以通过浏览器开发者工具查看),会发现每本书都位于一个<article class="product_pod">元素中:标题位于<h3>标签内(嵌套在一个链接标签中),价格则位于<p class="price_color">标签中
让我们使用 XPath 进行提取:
# Extract all book articles
book_elements = doc.xpath('//article[@class="product_pod"]')
books = []
for book in book_elements:
    title = book.xpath('.//h3/a/text()')[0]   # text of the <a> inside <h3>
    price = book.xpath('.//p[@class="price_color"]/text()')[0]  # price text
    books.append({"title": title, "price": price})
下面我们来逐行解析这段代码:
- doc.xpath('//article[@class="product_pod"]')用于查找所有 class 为“article”的 <product_pod> 元素,并将其存储在book_elements中。这里使用 // 搜索整个文档,而[@class="product_pod"]则是一个属性过滤条件。
- 接下来我们遍历每个图书元素,对每一个元素执行以下操作:
- 我们使用相对 XPath(注意字符串开头的 .)查找标题文本:.//h3/a/text() 表示“在该图书元素下的 <a> 标签内查找 <h3> 标签,并获取其文本”,由于预期只有一个标题,这里取第一个结果 [0]。
- 类似地,.//p[@class="price_color"]/text()可以获取价格字符串
- 我们将包含标题和价格的字典添加到 books 列表中。
循环结束后,books 列表的内容可能如下所示:
[
  {"title": "A Light in the Attic", "price": "£51.77"},
  {"title": "Tipping the Velvet", "price": "£53.74"},
  ...
]
这就是我们提取到的数据!我们已成功使用 lxml 从页面中抓取到图书标题和价格。
与其他库的对比
Python 拥有多种用于 HTML/XML 解析和数据抓取的库,lxml 与 BeautifulSoup、内置的 xml.etree(ElementTree)以及 Scrapy 的 Parsel 相比表现如何?下面简要对比它们各自的优势、局限性以及适用的使用场景:
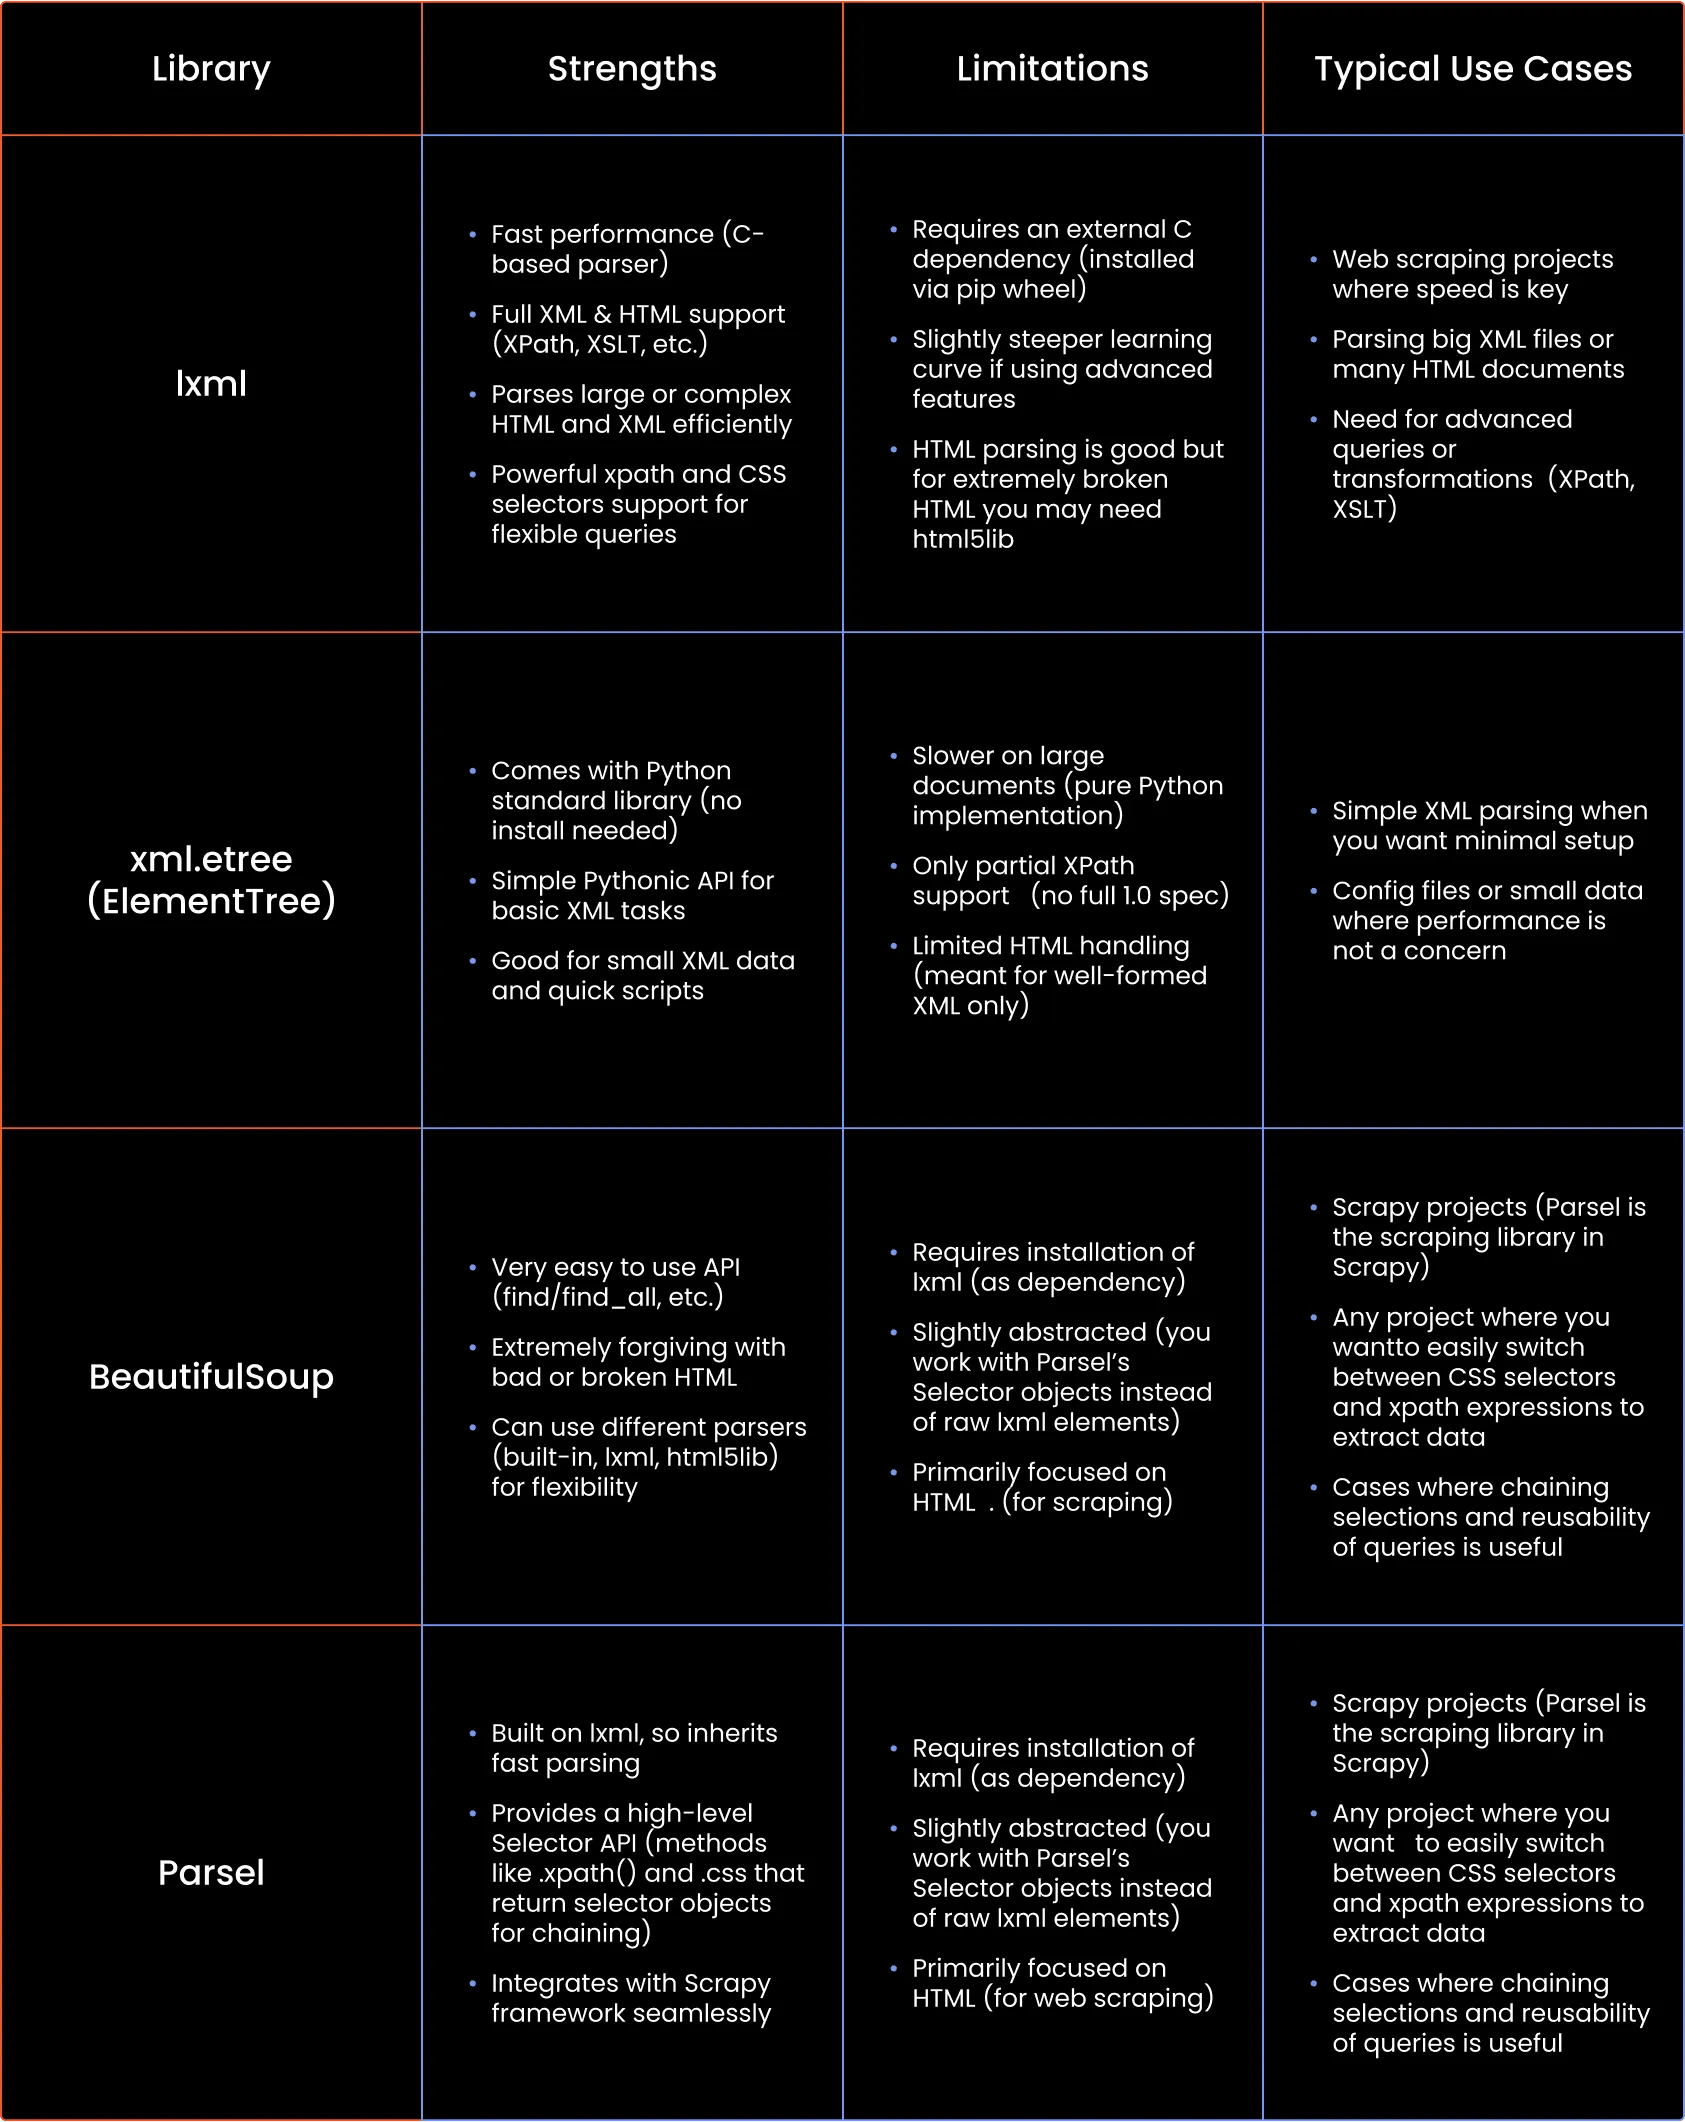
简单来说:在性能和功能方面,lxml 是更合适的选择;在处理复杂混乱的 HTML 以及追求易用性方面,BeautifulSoup 更有优势;对于简单的内置需求,ElementTree 已经够用;而 Parsel(尤其配合 Scrapy 使用)则提供了便捷的数据抓取接口。实际上,这些库背后往往都离不开 lxml:BS4 可以将 lxml 作为解析器使用,Parsel 本质上也是对 lxml 的封装。
好消息是,您不必“从一而终”,这些工具完全可以混合使用。例如可以先用 lxml 解析,再用 BeautifulSoup 做一些清理工作,或者根据项目需求在不同项目中分别选用 lxml 和 BS4。
如果您在考虑使用其他编程语言,可以参考我们的Golang 与 Python 对比文章,了解二者在处理数据抓取和解析任务时各自的表现
总结与延伸阅读
本篇 lxml 教程介绍了如何使用 Python 的 lxml 库进行数据抓取、解析 HTML 以及处理 XML 文档,内容涵盖了 lxml 的安装、构建树结构,以及使用 XPath 和 CSS 选择器提取数据的方法。
如需更多帮助,请访问lxml 官方文档,并尝试使用 XPath 速查表或 Parsel、Scrapy 等工具;也别忘了加入我们的Discord 社区,与其他从事数据抓取的开发者交流经验和技巧
lxml 能解析不规范的 HTML 吗?
可以,通过 lxml import HTML 或 etree.HTML(),lxml 能够处理不规范的 HTML。
.text、.tail 和 .attrib 之间有什么区别?
.text 是元素内部的文本,.tail 是元素之后的文本,.attrib 则以字典形式保存元素的属性。
lxml 支持 XML 命名空间吗?
支持,可以在 XPath 中使用命名空间,并通过 {namespace} 标签的方式访问对应元素。
lxml 兼容 Python 3.x 吗?
当然,lxml 兼容所有主流的 Python 3 版本。
lxml 与 xml.etree 或 BeautifulSoup 相比有什么不同?
lxml 速度更快,并完整支持 XPath;ElementTree 功能较为基础;BeautifulSoup 使用更简单,但速度较慢。