核心要点:
- 建议从分类页面入手,因为相比搜索结果页,分类页面通常更易于抓取
- 同时轮换代理、请求头和 User-Agent,可减少被封锁和请求失败的情况
- 提取数据前务必先验证页面内容,因为 200 响应码也可能具有误导性。
Amazon 蕴藏着海量数据:价格、评论、排名、规格,甚至产品描述,这些信息都公开可见,等待被收集。但一旦真正动手抓取,您很快就会碰壁。
为什么?
因为 Amazon 不仅关注您请求了什么,还关注您是如何请求的。这个网站部署着业内较为先进的反爬虫机制:检测您的 IP 地址、识别您的 User-Agent、持续追踪您的行为模式,并根据地区对动态内容进行个性化处理。如果没有周密的方案和正确的环境配置,您的网络爬取尝试在开始之前就会失败。
本指南将介绍如何使用 Python 抓取 Amazon 产品数据,同时避免被标记或封锁。我们的代码示例将基于 requests 库,配合智能请求头与 IP 轮换,逐步将提取到的产品数据保存为规整的 CSV 文件。
Amazon 数据抓取分步指南
让我们一起搭建一个简单的 Amazon 网络爬取工具,用于抓取产品标题、链接、价格、评分、评论数量和图片,数据来源为Amazon 的 Best Sellers 页面,而非单个产品页面。
我们选择这个细分场景,是因为它既足够具体,能让流程保持清晰,又足够常见,能展示小型抓取方案的实际效果。此外,相比 Amazon 搜索结果页,分类页面通常更易于抓取。
具体做法是:从该 Best Sellers 页面的前 60 个商品中采集数据,这个数量足以触发分页,也能让我们观察 Amazon 网站如何处理重复请求。这是一个贴近真实场景的测试案例,既能获取有意义的结构化数据,也能检验哪些方法在压力下依然有效。
以下是我们将为每款产品提取的数据:
- 标题
- 链接
- 价格
- 星级评分
- 评论数量
- 图片链接
这只是其中一个示例,同样的逻辑也适用于采集厨房用品的产品标题、为耳机搭建 Amazon 价格抓取工具,或收集游戏外设的产品链接。跟着本指南操作,到最后您将得到一个可运行的 Python 网络爬取文件,并可根据自己的数据采集需求进行调整。
准备好了吗?开始写代码吧。
第一步:配置环境
在开始发送请求或解析产品详情之前,先花点时间完成环境检查:需要在系统中安装 Python、准备好几个核心库,并新建一个用于存放脚本的文件夹。
这一步很快,却能帮您避免在抓取过程中出现莫名其妙的错误。
- 确认已安装 Python
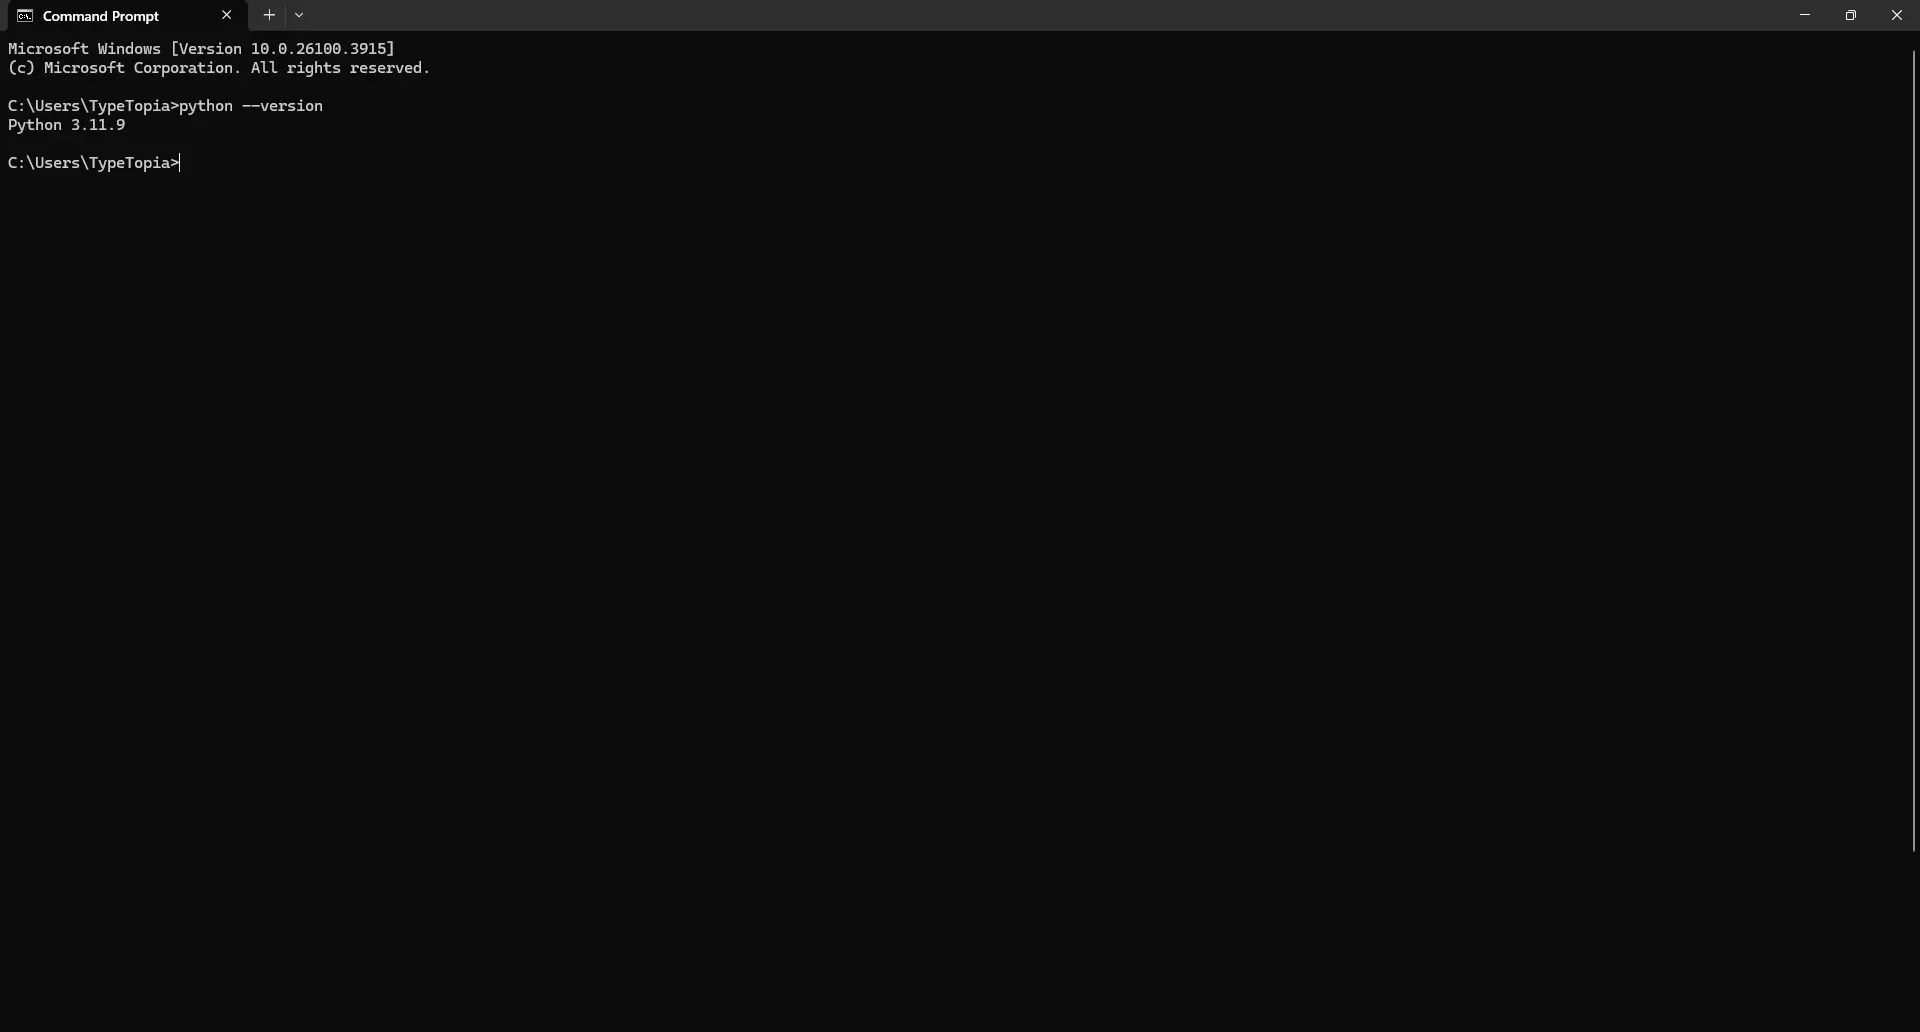
设备上需要安装 Python。如果不确定是否已安装,可打开终端输入以下命令;如果提示出错,请访问python.org下载适用于您操作系统的最新版本,然后重新尝试。
python --version
如果已安装成功,您会看到设备当前运行的 Python 版本号,下面是我们的示例:
- 选择文件夹存放位置
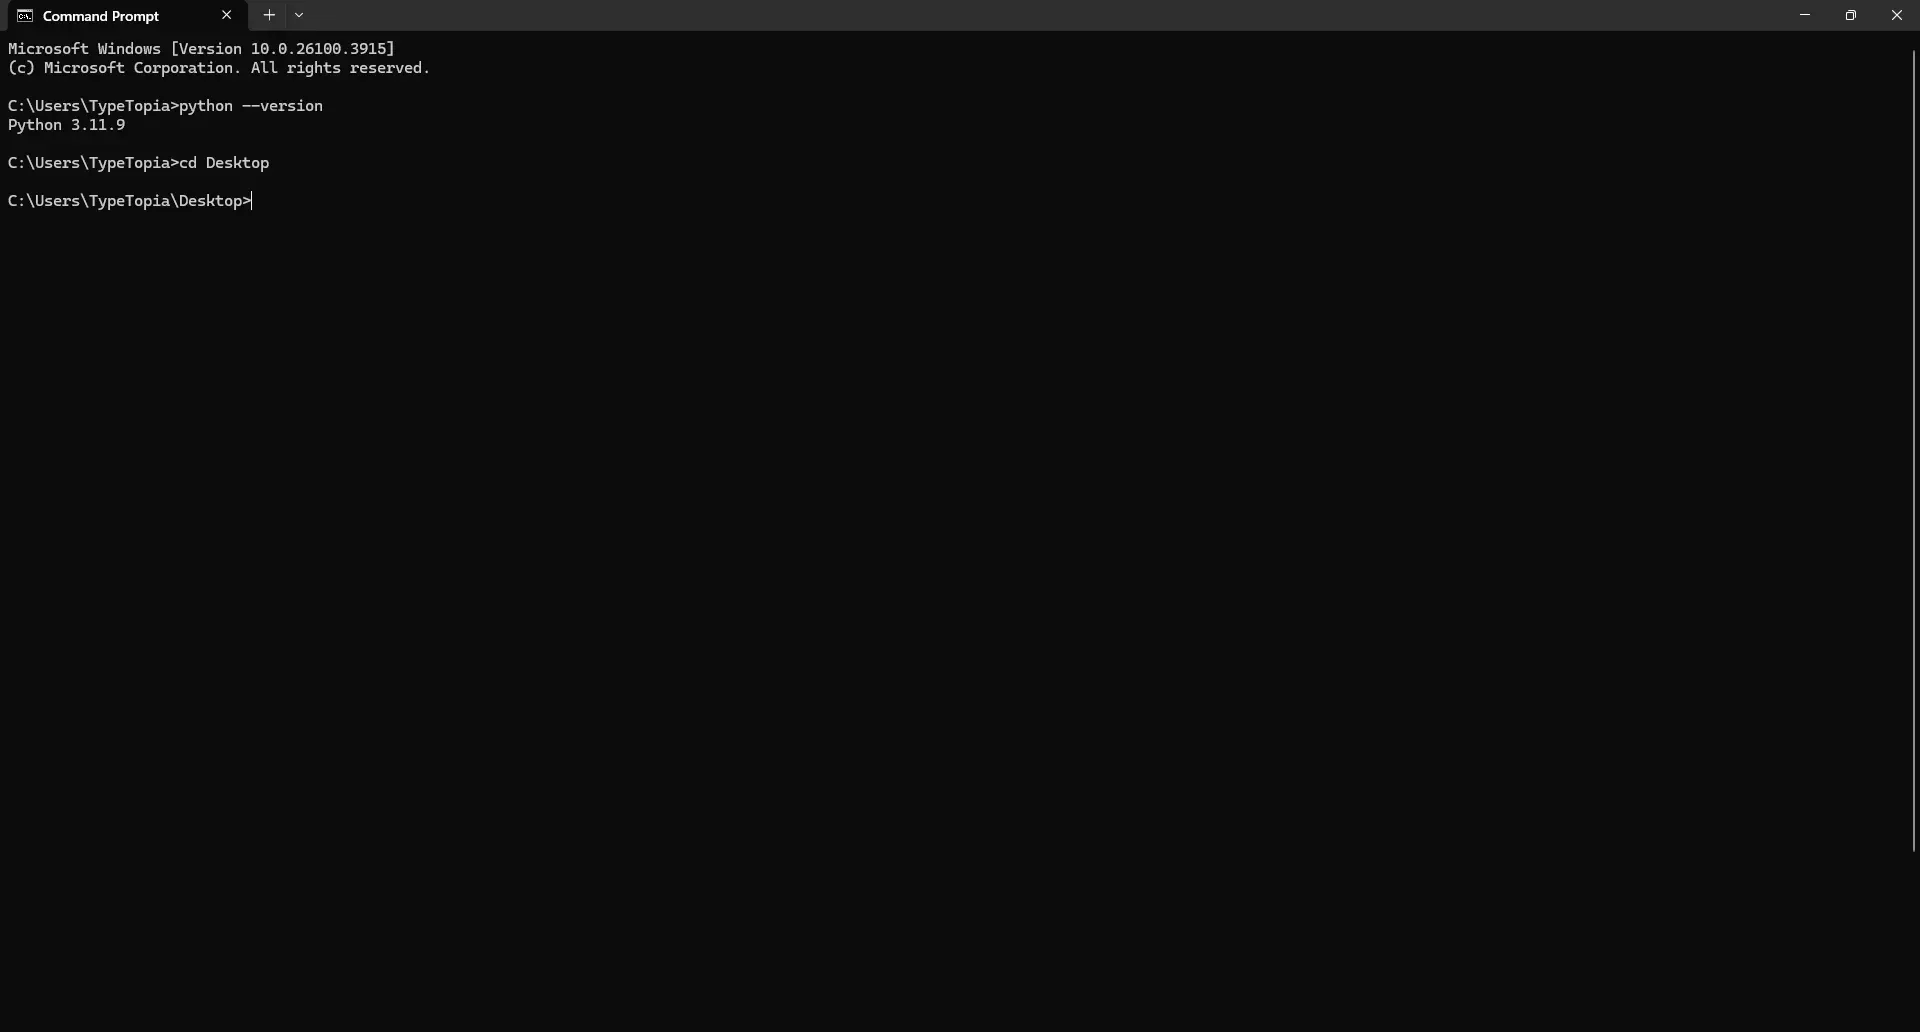
为了便于管理,先为本项目的文件夹选定一个存放位置,放在哪里都可以,本例中我们使用桌面。在命令行中输入:
cd Desktop
这条命令的作用是告诉系统新文件夹应放在哪里,以下是我们的输出结果:
- 新建文件夹
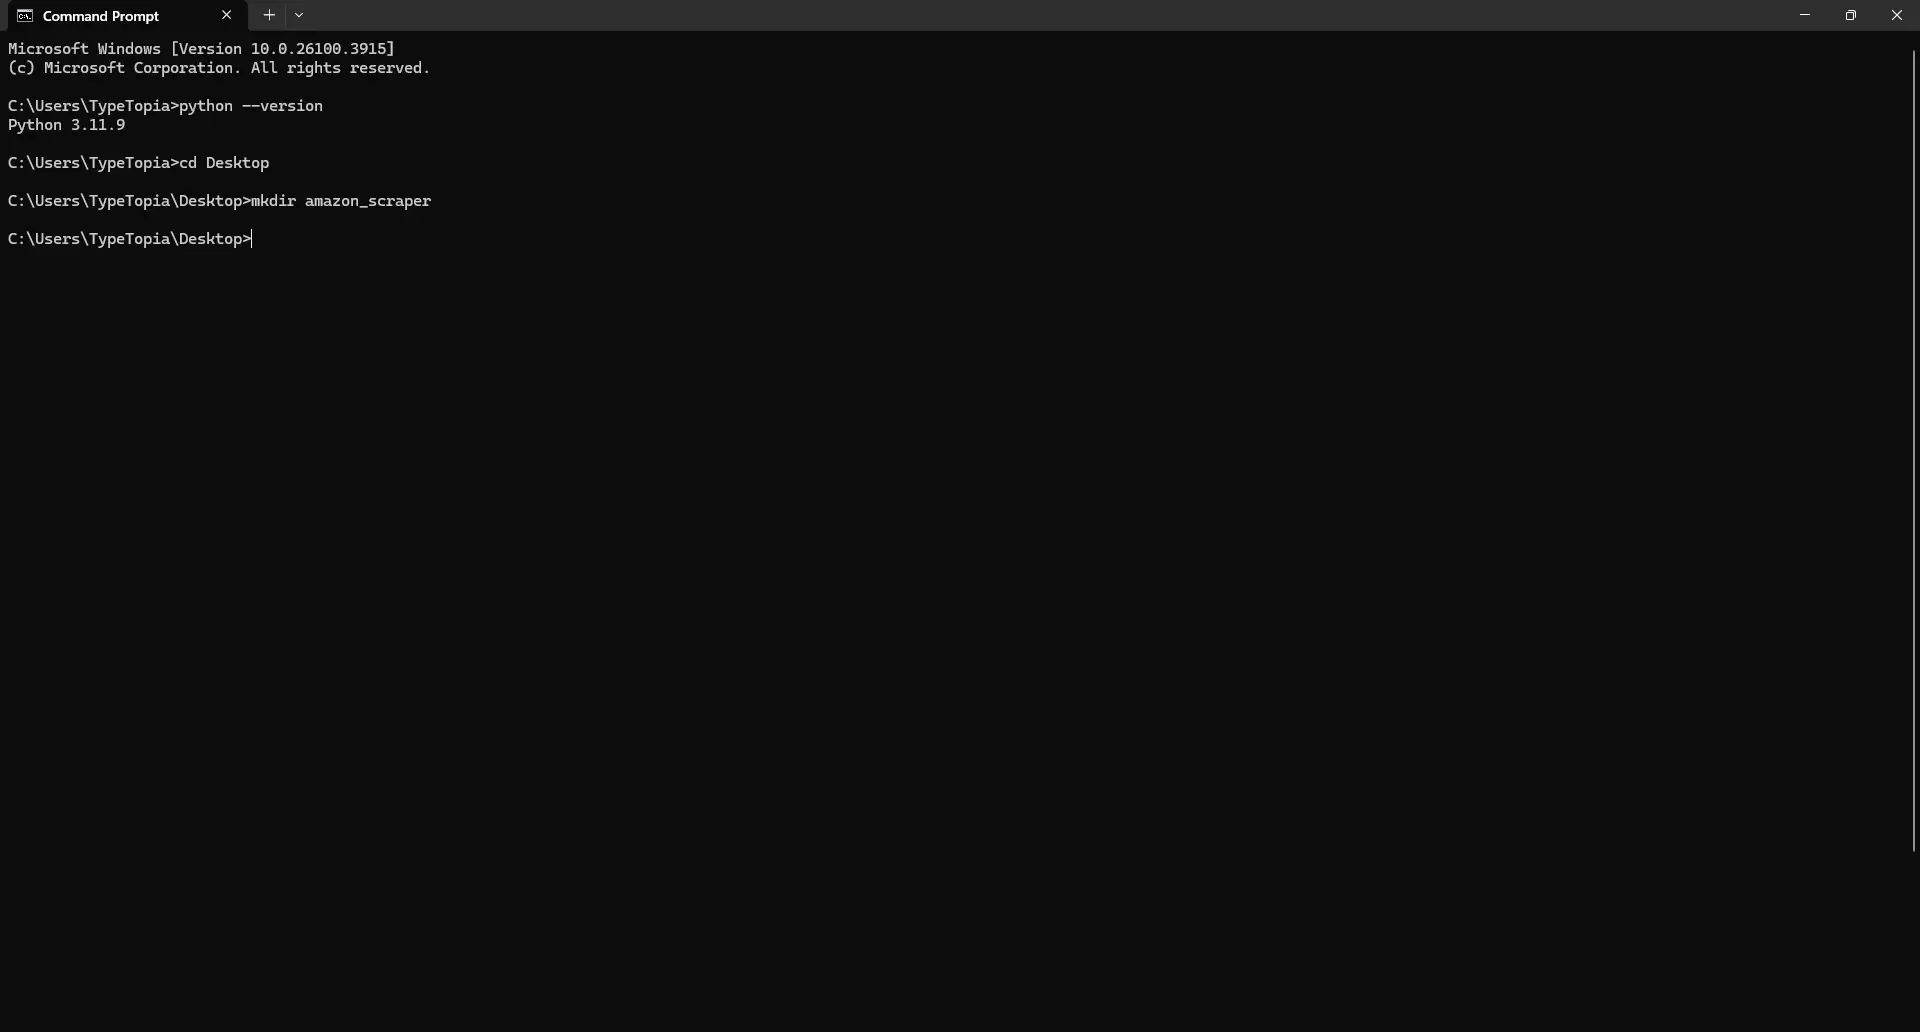
接下来创建文件夹,用于存放 Python 脚本、抓取到的数据以及其他工作文件。在命令行中输入:
mkdir amazon_scraper
您将看到以下内容:
- 进入新文件夹
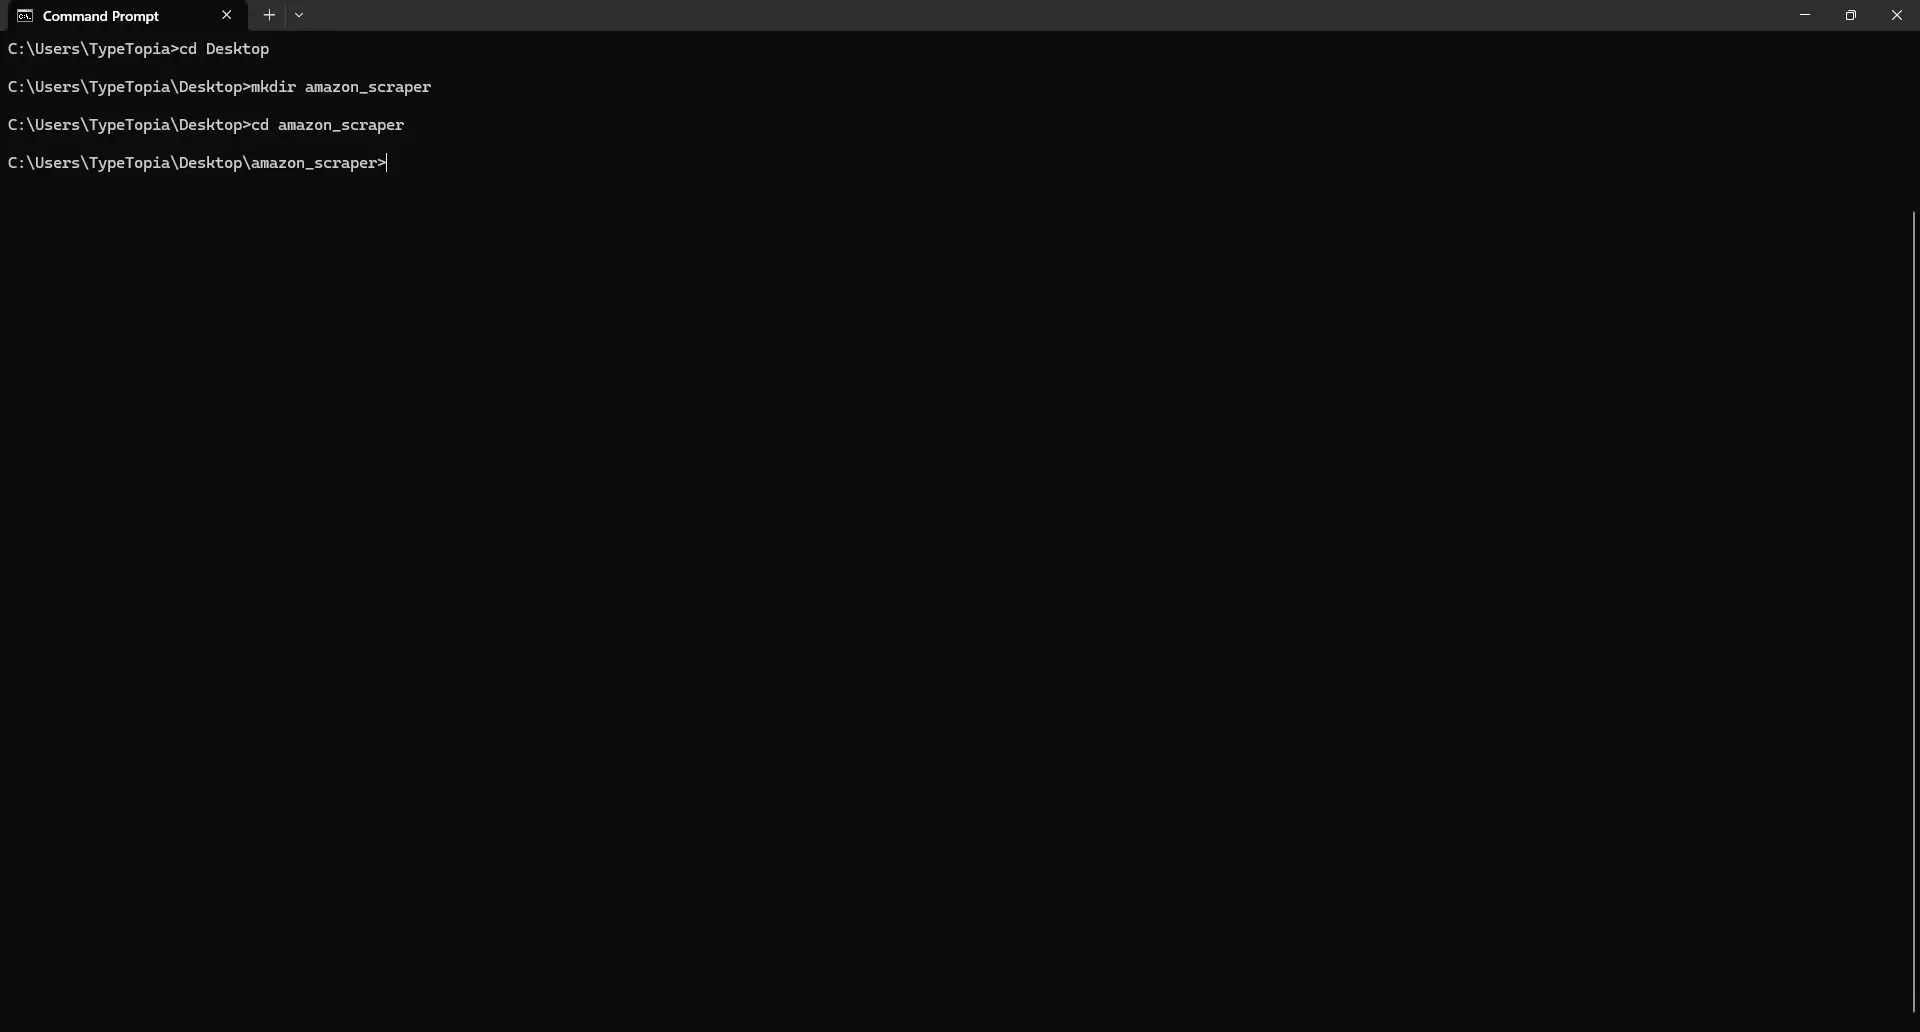
进入刚创建的文件夹,这样一来,您编写的每个脚本、提取到的每个产品标题都会统一保存在同一个位置。在下一行输入以下命令:
cd amazon_scraper
您将看到以下内容:
- 安装所需的库
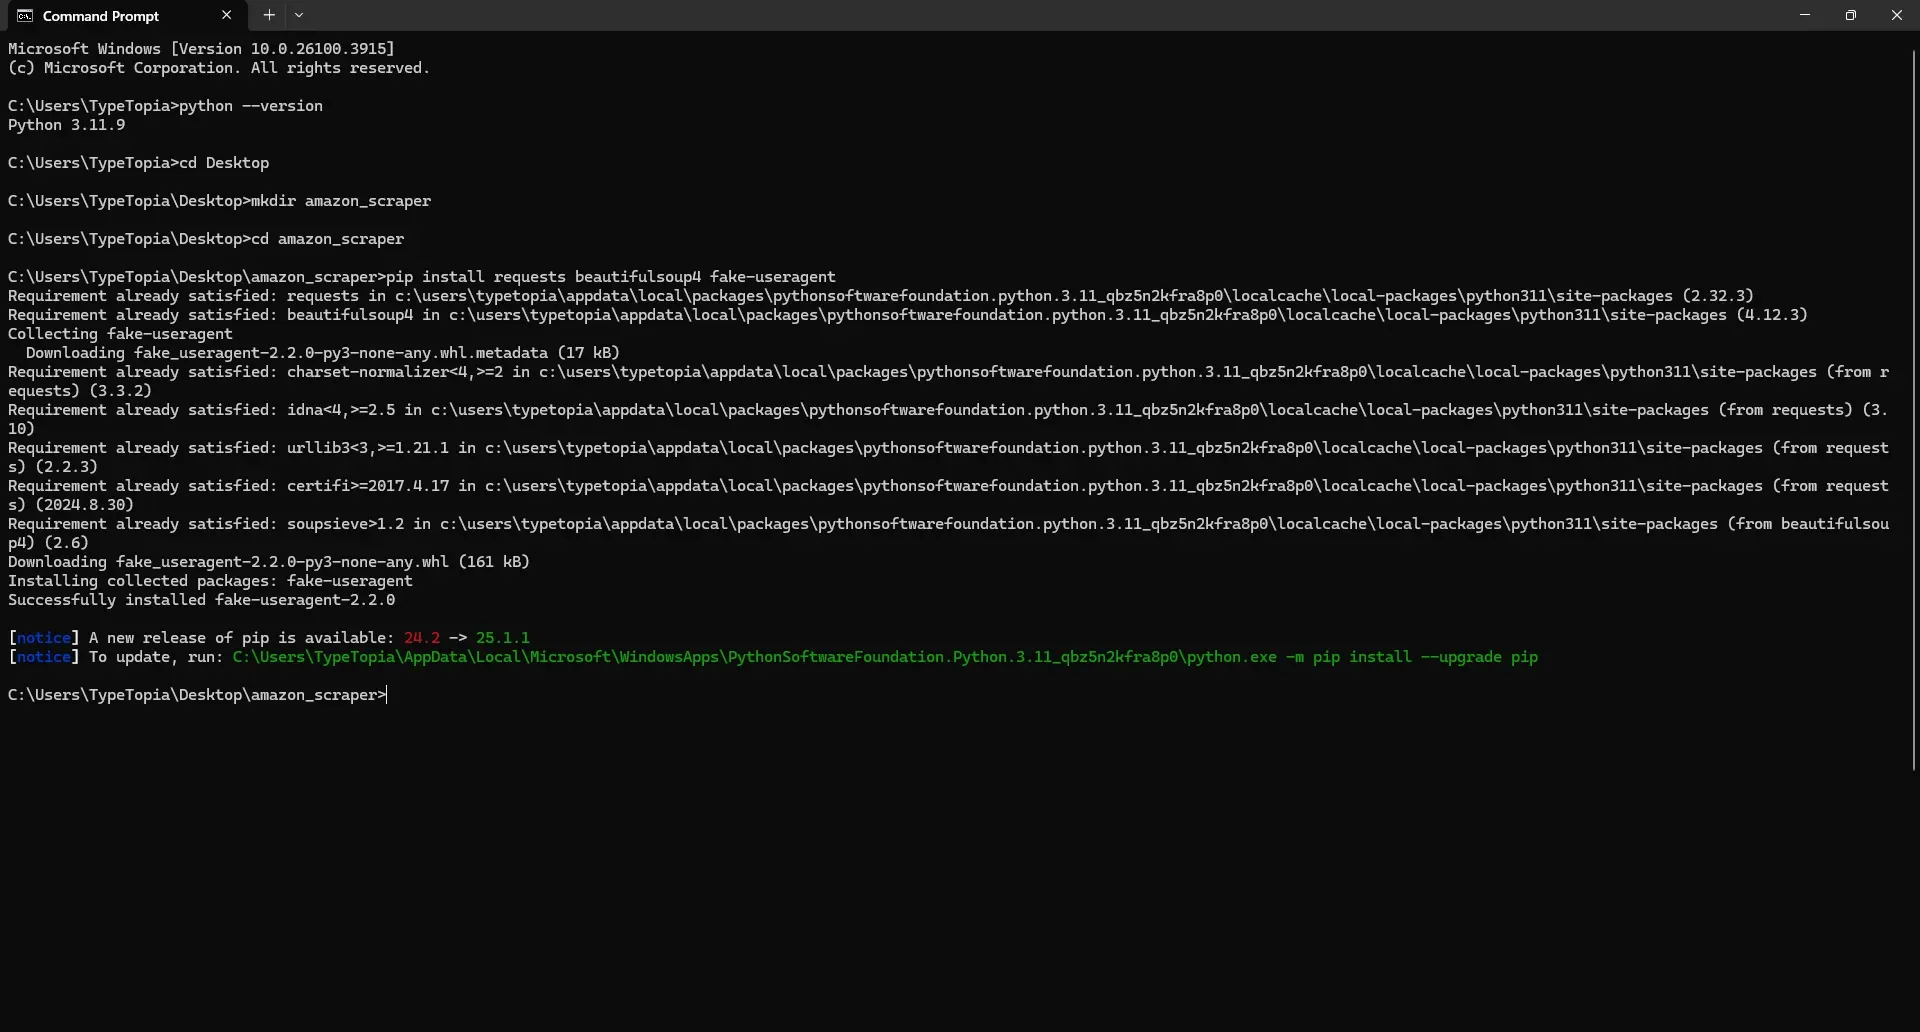
本次网络爬取需要三个库:requests 用于处理 HTTP 调用,beautifulsoup4 用于从 HTML 中提取产品详情,fake-useragent 用于伪装浏览器请求头、降低被封锁的风险。可以通过以下命令一次性安装:
pip install requests beautifulsoup4 fake-useragent
这可能需要一两分钟才能完成:
- 编写初始 Python 脚本
先不要关闭终端,稍后还会用到。现在切换到您常用的代码编辑器,进入刚创建的文件夹,新建一个 Python 文件,命名为 final_amazon_scraper.py,然后粘贴以下代码:
import requests
from bs4 import BeautifulSoup
from fake_useragent import UserAgent
import csv
import random
import time

print("Environment is ready. Let's scrape something.")
现在可以保存文件了,确保它位于之前创建的文件夹中。保存后切换回终端,运行脚本以确认一切配置正确。接着之前的位置粘贴以下命令:
python final_amazon scraper.py
如果一切顺利,脚本将输出“Environment is ready.”
如果看到这条消息,说明一切都已正确配置:Python 正常运行,所需的库也已加载完毕,各项检查全部通过。保持这个节奏,接下来进入第二步。
第二步:创建可复用的 User-Agent 生成器
这个伪造 User-Agent 的生成器只需要创建一次,因此我们将其放在代码开头、紧跟在导入语句之后。UserAgent() 实例可以通过 .random 按需提供随机的浏览器请求头。如果每次请求都新建一个生成器,既浪费资源又会拖慢速度,因此我们只创建一次,并在需要时反复复用。
只需在导入语句之后添加这一行代码:
import requests
from bs4 import BeautifulSoup
from fake_useragent import UserAgent
import csv
import random
import time
print("Environment is ready. Let's scrape something.")
ua = UserAgent()
第三步:实现代理服务器轮换
Amazon 网络爬取脚本已经能正常运行,接下来讨论代理服务器轮换。情况是这样的:我们即将向 Amazon 的 Best Sellers 页面发送 100 次独立请求,也就是在同一时间段内对同一分类发出 100 次请求。
唯一要避免的做法,就是全部用自己的 IP 地址发送请求,这无异于站在 Amazon 门口大喊“我在抓取你们的网站,而且一直都是我!”。我们希望把这些请求分散到不同的 IP 上,让它看起来像是来自不同地点、不同用户的正常流量。
我们将使用五个来自 MarsProxies 的住宅代理,每个代理拥有不同的地理位置和会话字符串。为什么是五个?因为我们的脚本在每个 Amazon Best Sellers 页面只需要发送两到三次请求。由于最多抓取到第二页,总请求数最多为六次,大致相当于每个 IP 一次。五个代理,就相当于五个人在随意浏览手机壳——这正是我们想要营造的效果。
接下来需要完成以下操作:
- 配置轮换住宅代理
如果尚未配置,请登录 MarsProxies 控制台,选择“Residential”,然后选定第一个地理位置。我们选择了挪威,并将城市设为奥斯陆;连接类型保持 HTTP,会话时长设为 20 分钟。随后会得到如下所示的一组凭据:
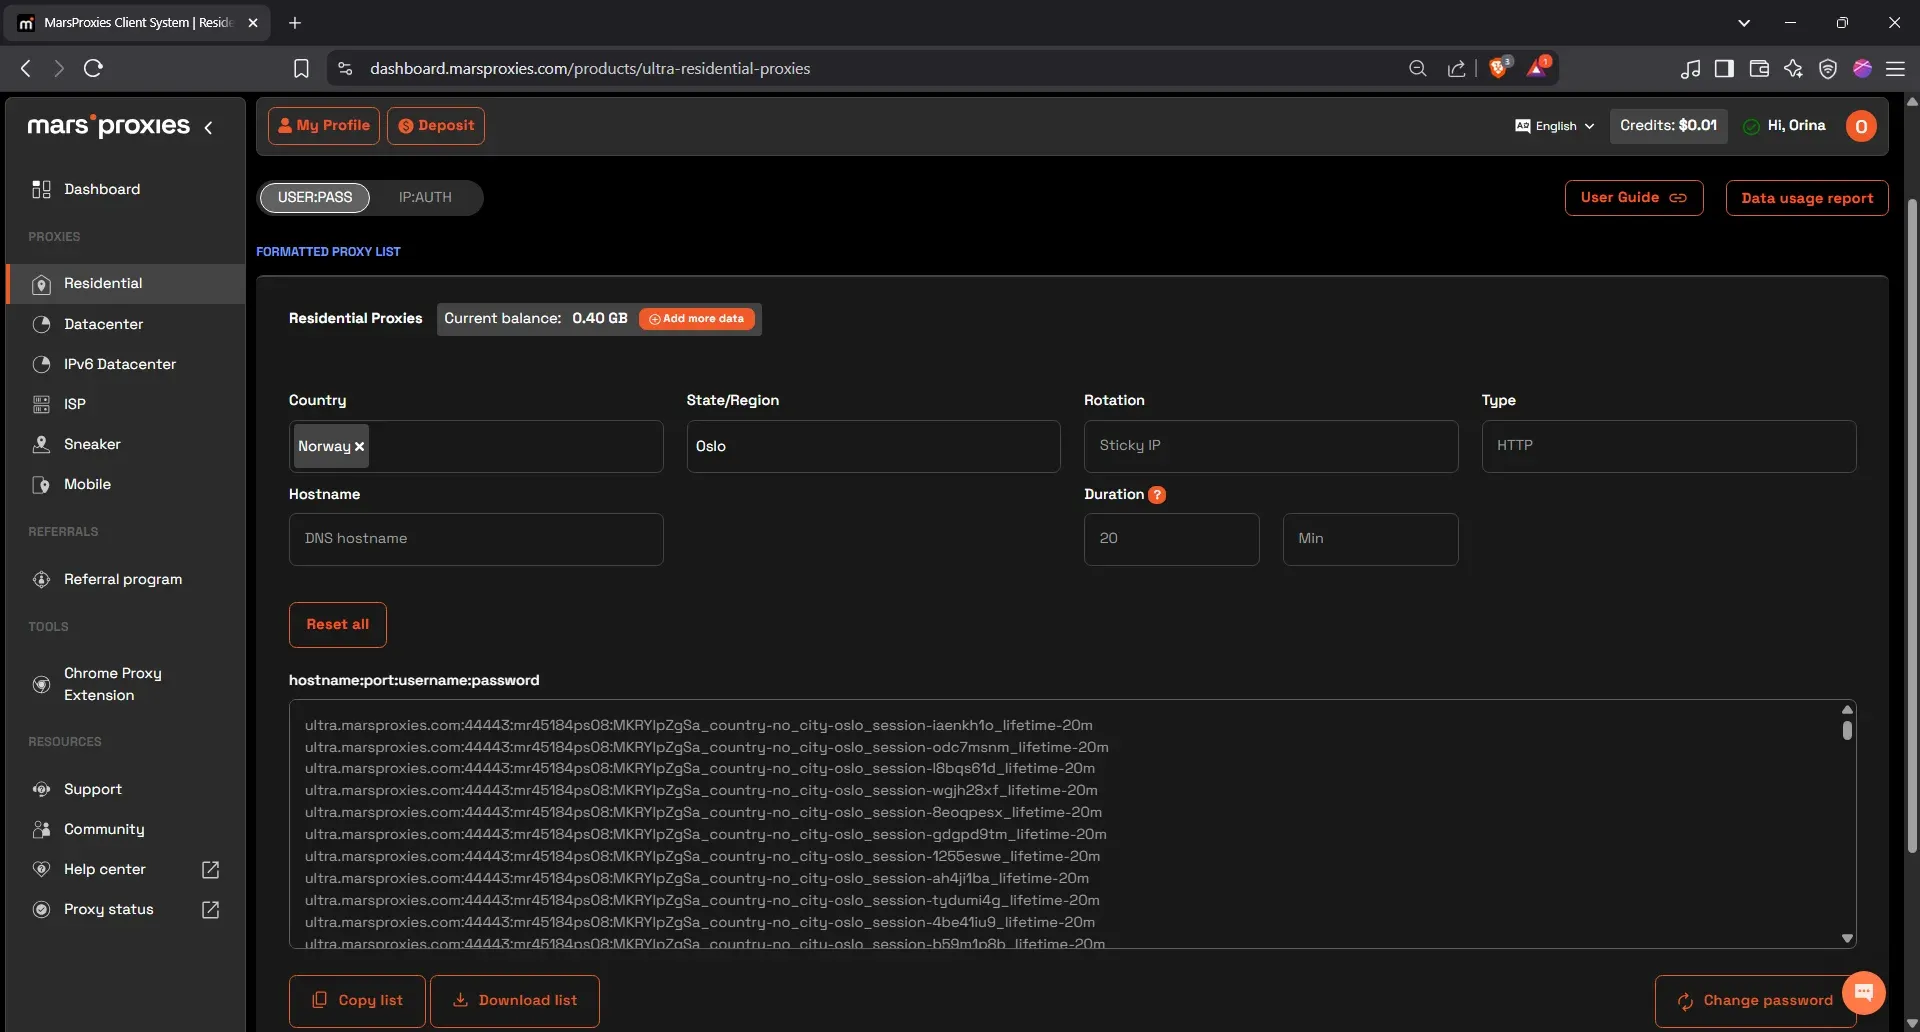
登录凭据格式如下:
ultra.marsproxies.com:44443:USERNAME:PASSWORD
该字符串中的每个部分都代表特定含义:
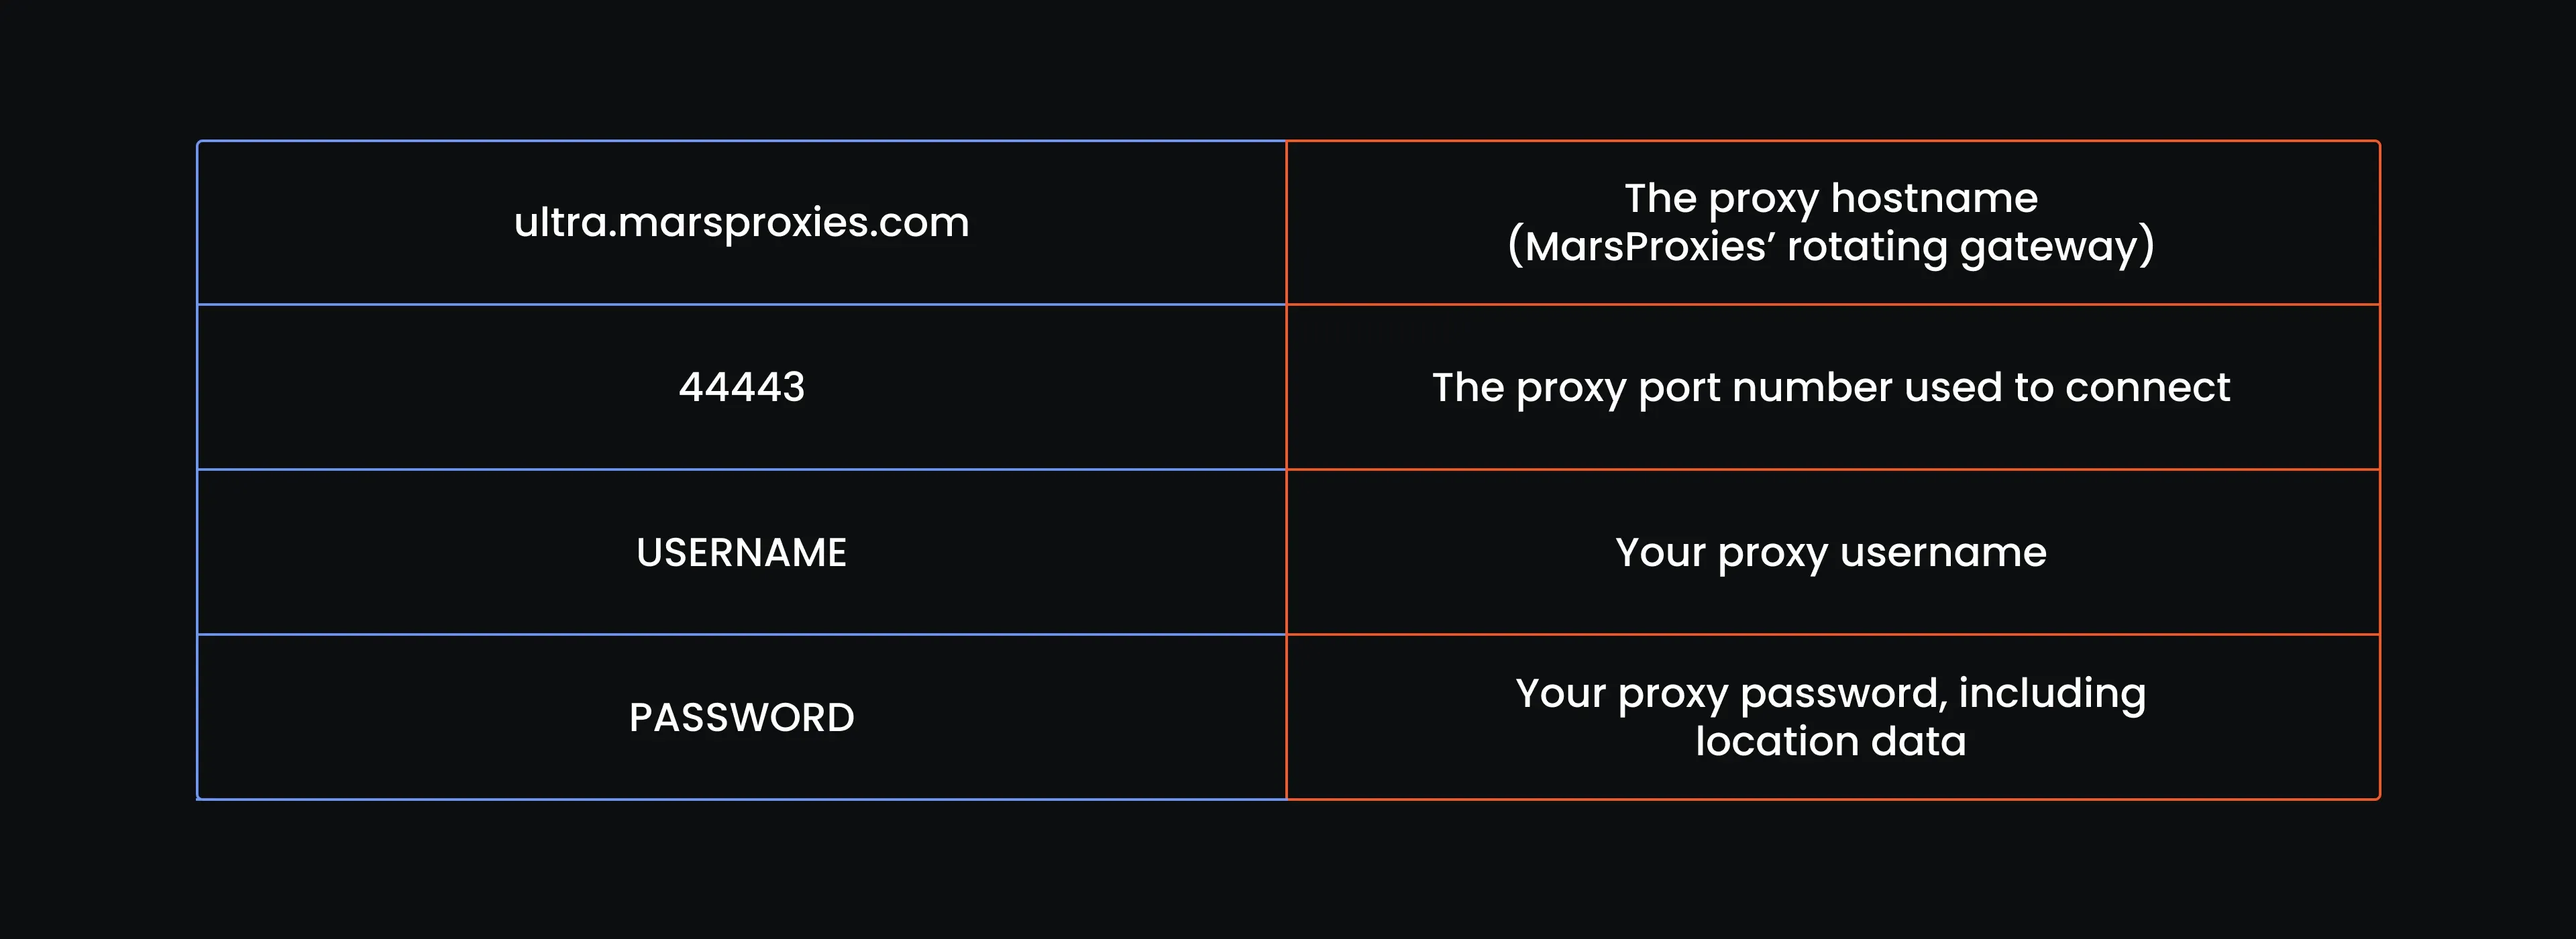
- 将代理字符串转换为可用格式
只需取列表中的一行,将其转换为包含 HTTP 和 HTTPS 代理字符串的字典,如下所示:
# Proxy pool with the first entry (each includes http and https)
proxy_pool = [
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443"
    }
]
该字符串的构成方式如下:
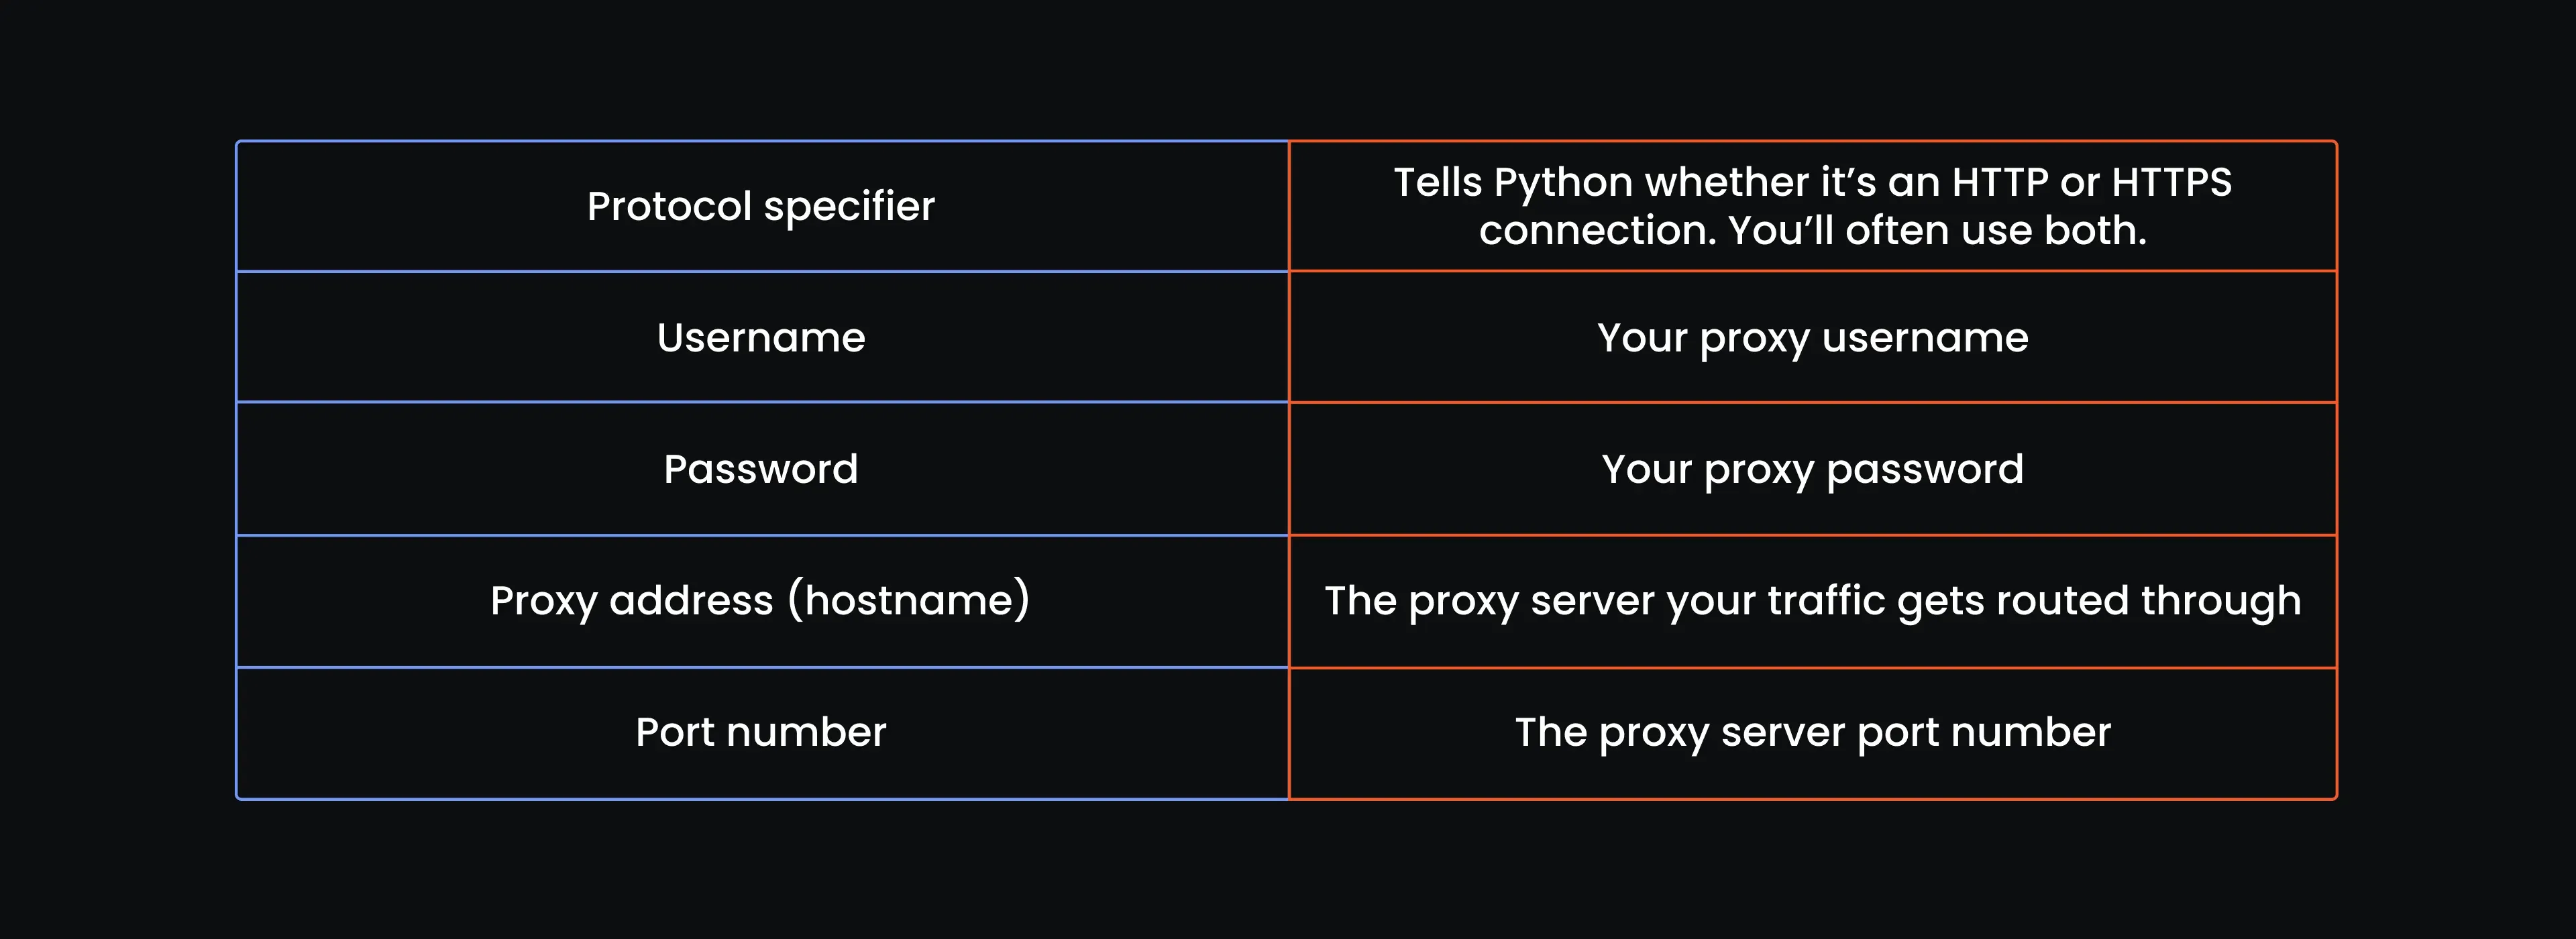
在字典中将这一结构重复两次,分别对应“http”和“https”,这样无论请求访问哪种 Amazon URL 都能覆盖到。
- 再选择四个代理地理位置
再构建四次代理字符串,每行对应一个代理。每次在 MarsProxies 控制台中选择不同的国家和城市组合,获取代理字符串,将其整理成包含 HTTP 和 HTTPS 的字典,并添加到 proxy_pool 列表中。最终您会得到五个这样的字典,这就是完整的轮换配置。
以下是我们的配置结果:
# Replace YOUR_USERNAME and YOUR_PASSWORD with your actual MarsProxies credentials.
# Keep the country, state/city, session, and lifetime values in the same format shown below.

# Proxy pool with 5 full proxy entries (each includes http and https)
proxy_pool = [
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443"
    }
]
- 更新脚本
到目前为止的完整脚本如下:
import requests
from bs4 import BeautifulSoup
from fake_useragent import UserAgent
import csv
import random
import time
print("Environment is ready. Scraping started.")
ua = UserAgent()
# Setup user agent generator
ua = UserAgent()
# Replace YOUR_USERNAME and YOUR_PASSWORD with your actual MarsProxies credentials.
# Keep the country, state/city, session, and lifetime values in the same format shown below.

# Proxy pool with 5 full proxy entries (each includes http and https)
proxy_pool = [
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443"
    }
]
代理轮换已配置完成,库已加载,环境也已准备就绪,接下来进入第四步。
第四步:搭建抓取基础——请求逻辑
在网络爬取这件事上,Amazon 从不手下留情:它不是普通网站,而是全球知名的大型电商平台,深知自身数据的价值,绝不会让任何人像拿免费糖果一样随意提取这些数据。
事实上,Amazon 很清楚会有人觊觎这些数据,它知道第三方会出于市场调研、比价等多种目的,尝试抓取产品标题、星级评分和价格信息。
因此,Amazon 不仅会保护数据,还会主动对抗抓取行为:动态 CAPTCHA、严格的 IP 封禁、请求头指纹识别、TLS 校验,以及有时看似无规律的行为触发机制。只要脚本流露出一丝机械感,请求就会被拒绝。
这就是为什么不能只发送一个基础 HTTP 请求、指望侥幸成功。轮换 IP 或许能帮您通过第一道关卡,但要想真正不触发警报、顺利抵达目标页面,还需要更多手段。
随机化的请求头能帮助我们更好地融入正常流量,而重试机制则让代码在遭到 Amazon 拒绝时具备重新尝试的能力。一次被拒绝并不意味着结束,只是意味着换一套“行头”再试一次。
# Session setup
session = requests.Session()

# Rules for retrying
retries = 3
delay = 10
success = False

# Main retry logic
while retries > 0 and not success:
    user_agent = ua.random
    proxies = random.choice(proxy_pool)

    print(f"Trying with User-Agent: {user_agent}")
    print(f"Using Proxy: {proxies['http']}")

    # Natural pause
    time.sleep(random.uniform(3, 8))

    # Our GET request
    try:
        response = session.get(
            "https://www.amazon.com/Best-Sellers-Cell-Phones-Accessories/zgbs/wireless/2407760011",
            proxies=proxies,
            timeout=20
        )

        print(f"Status Code: {response.status_code}")

        # Parse the HTML response
        soup = BeautifulSoup(response.content, "html.parser")
        product_cards = soup.find_all("div", attrs={"data-asin": True})

        # Block detection logic
        if (
            "captcha" in response.url or
            "api-services-support@amazon.com" in response.text or
            soup.find("form", action="/errors/validateCaptcha") or
            response.status_code != 200 or
            len(product_cards) == 0
        ):
            print("Blocked or failed. Retrying...")
            retries -= 1
            time.sleep(delay)
            delay *= 2
            continue

        # Success condition: If we got here, we passed Amazon's outer wall
        print("Success! Got a response that wasn't blocked.")
        success = True

    # Catching request errors and retrying with exponential backoff
    except Exception as e:
        print(f"Request failed: {e}. Retrying after {delay} seconds...")
        time.sleep(delay)
        retries -= 1
        delay *= 2
我们的请求逻辑篇幅稍长,但这是必要的:它在背后做了大量工作,确保第一次尝试就不会被直接拒之门外。下面逐一拆解其中的关键部分。
- 会话设置
第一步是建立网络爬取会话,这就像在浏览多个页面时始终保持同一个浏览器标签页处于打开状态。
- 重试规则
亚马逊不会第一次就乖乖把数据交给我们,所以我们要提前做好应对拒绝的准备。脚本会给亚马逊三次合作的机会:如果被拦截,就等待 10 秒后重试;如果仍然失败,就延长等待时间。
- 主重试循环
如果亚马逊第一次没有给出我们想要的结果,也没关系。重试循环会在每次尝试时更换新的 User-Agent 和代理,并记录下来,让您清楚知道每个请求是如何被伪装的。
- 自然停顿
3 到 8 秒的短暂停顿,能让我们的数据抓取脚本看起来像是有人正在思考或浏览网页。
- GET 请求
我们将请求包裹在 try 代码块中,以防出现问题——毕竟这种情况确实可能发生。我们使用之前建立的持久会话(也就是那个模拟浏览器标签页的会话)发送 HTTP GET 请求,带上目标 URL 和选定的代理,并设置超时时间为 20 秒,一旦超时就放弃等待。如果亚马逊成功响应,那很好;如果没有,重试机制就会启动并再次尝试。
- 解析响应
在开始抓取手机壳畅销榜页面之前,我们需要确认自己看到的不是一个伪造页面。亚马逊返回了响应,并不代表它给了我们真实的数据。
有时您会收到 CAPTCHA 验证,或者看似正常的 200 OK 响应,实际上只是一堆占位 HTML。因此,在用 BeautifulSoup 解析页面之后,我们做的第一件事,就是对包含 data-asin 属性的特定 <div> 元素调用 find_all()。
为什么要这样做?因为这正是亚马逊组织商品列表的方式:页面上的每一张商品卡片都被包裹在这样一个容器里。如果这个调用没有返回任何结果,就是一个早期预警信号——要么我们被拦截了,要么页面是空的,要么亚马逊更改了页面结构。这项检查能帮助我们在浪费时间抓取空气之前,及时发现问题响应。
- 拦截检测
首先,我们要判断:亚马逊是否悄悄把我们重定向到了一个 CAPTCHA 页面?这正是检查 response.url 中是否包含 "captcha" 的目的。接着,我们会查找 CAPTCHA 验证表单的痕迹,在响应内容中搜索亚马逊的备用支持邮箱地址,并检查页面是否返回了真实的商品卡片供我们解析。
只要上述任意一项检查未通过,或者状态码不是干净的 200,我们就将其判定为拦截。此时重试机制会启动:先等待 10 秒,再等待 20 秒,再等待 40 秒,每次都换上新的 IP 和新的身份字符串重新尝试。
想要彻底了解亚马逊 CAPTCHA 系统的工作原理以及如何绕过它?我们的Amazon CAPTCHA 绕过指南对此有详尽介绍。另外,如果您只需要抓取 Amazon ASIN值,也可以查看我们专门的指南。
- 成功条件
如果没有触发任何拦截信号,我们就将该请求标记为成功,并退出重试循环。
- 捕获请求错误
出错在所难免,这一部分正是让我们在出错后依然能够继续运行的关键。如果请求因为其他原因(例如超时或网络问题)而彻底失败,我们不会让程序因此崩溃。我们会捕获这个错误,打印出详细信息,让您清楚发生了什么,然后稍作等待,再用新的方案重新尝试。
将初始设置代码保留在文件顶部,然后在 proxy_pool 下方添加请求代码块。这是抓取循环的第一版草稿,后续步骤中我们会不断完善这同一个代码块,而不是重新创建新的循环。
第五步:确定需要抓取的元素
让我们暂时离开代码,先搭建参考表格。如果您曾经查看过网页的底层结构,就会知道那里充满了各种 <div>、<span> 和嵌套标签。这张表格能帮我们理清思路——它准确标明每条商品信息分别对应哪一个标签,这样开始抓取时,我们就不用再去猜测了。
- 创建参考表格
接下来这一步可能会显得有点老派,但请相信我们,这样做能让您后续少走很多弯路。我们将手动浏览亚马逊网站,查看 HTML 结构,并建立一张参考表格。
您只需要为每条商品信息建一个表格,列出标签类型、类名、属性和示例值。这就像给您的网络爬虫一个手电筒和一张平面图,让它清楚该往哪里走,而不是盲目乱找。因此,请创建一张包含以下属性的表格:
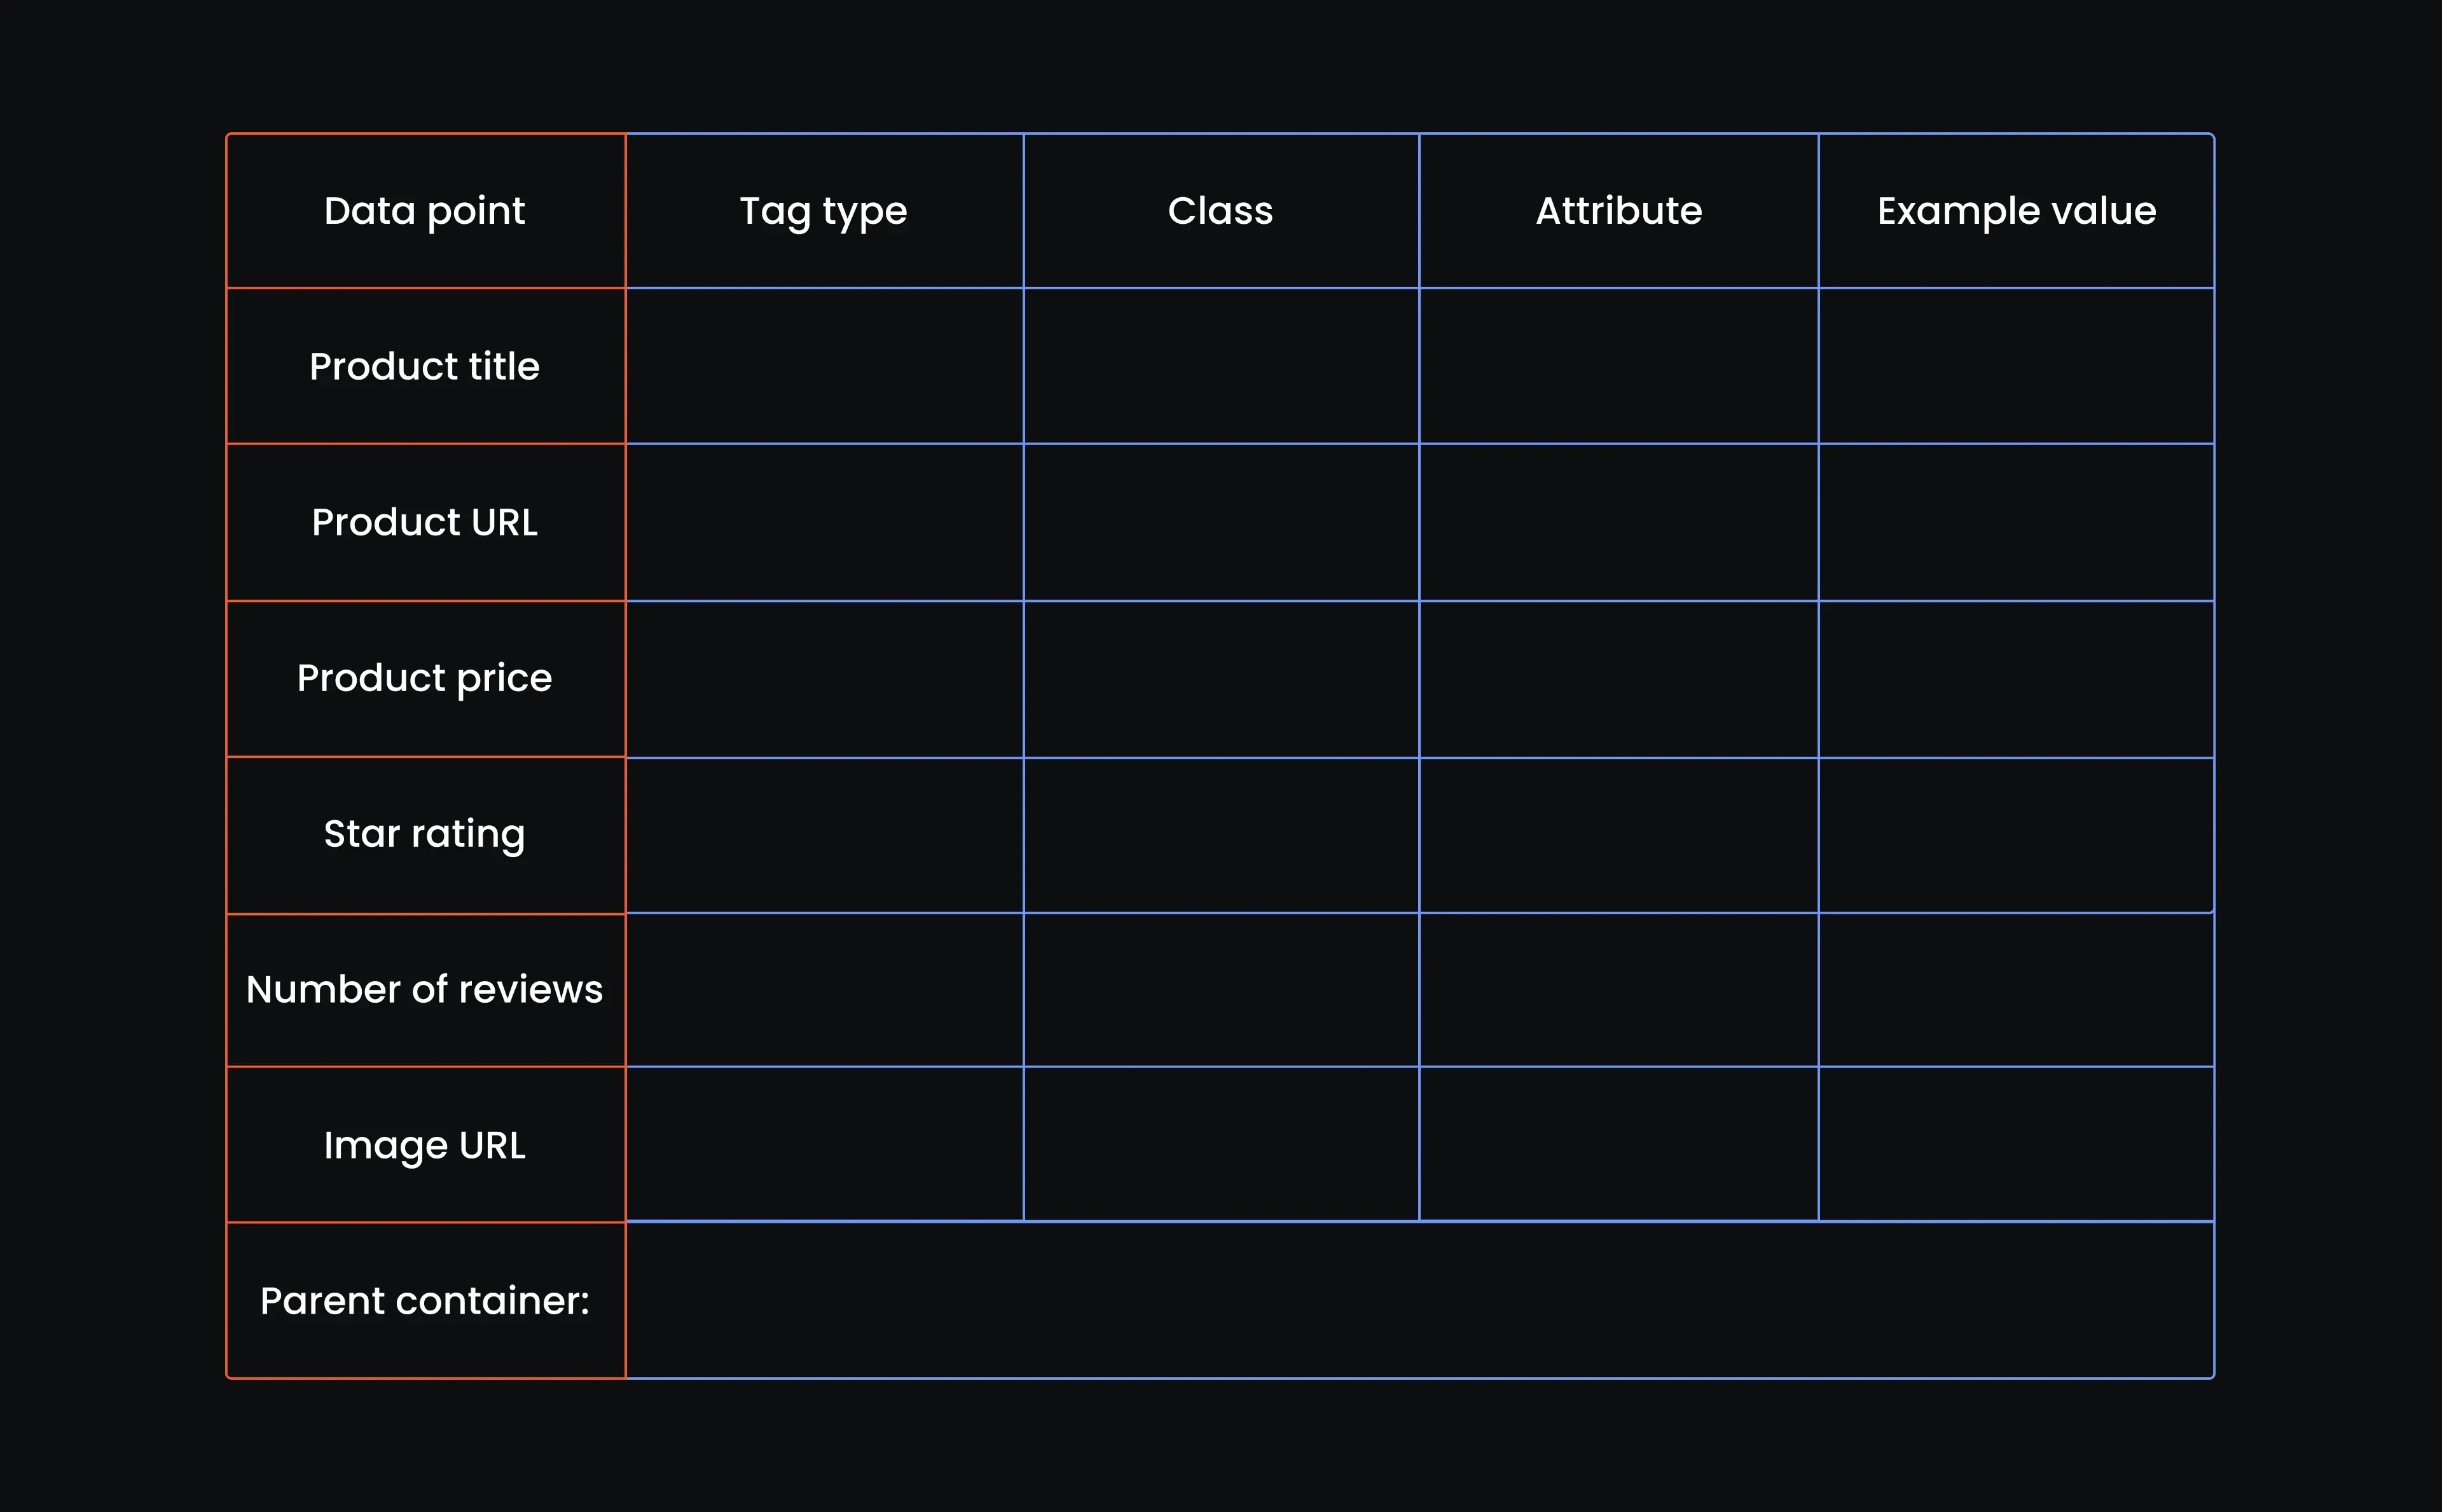
- 打开 Amazon US 手机壳畅销榜页面
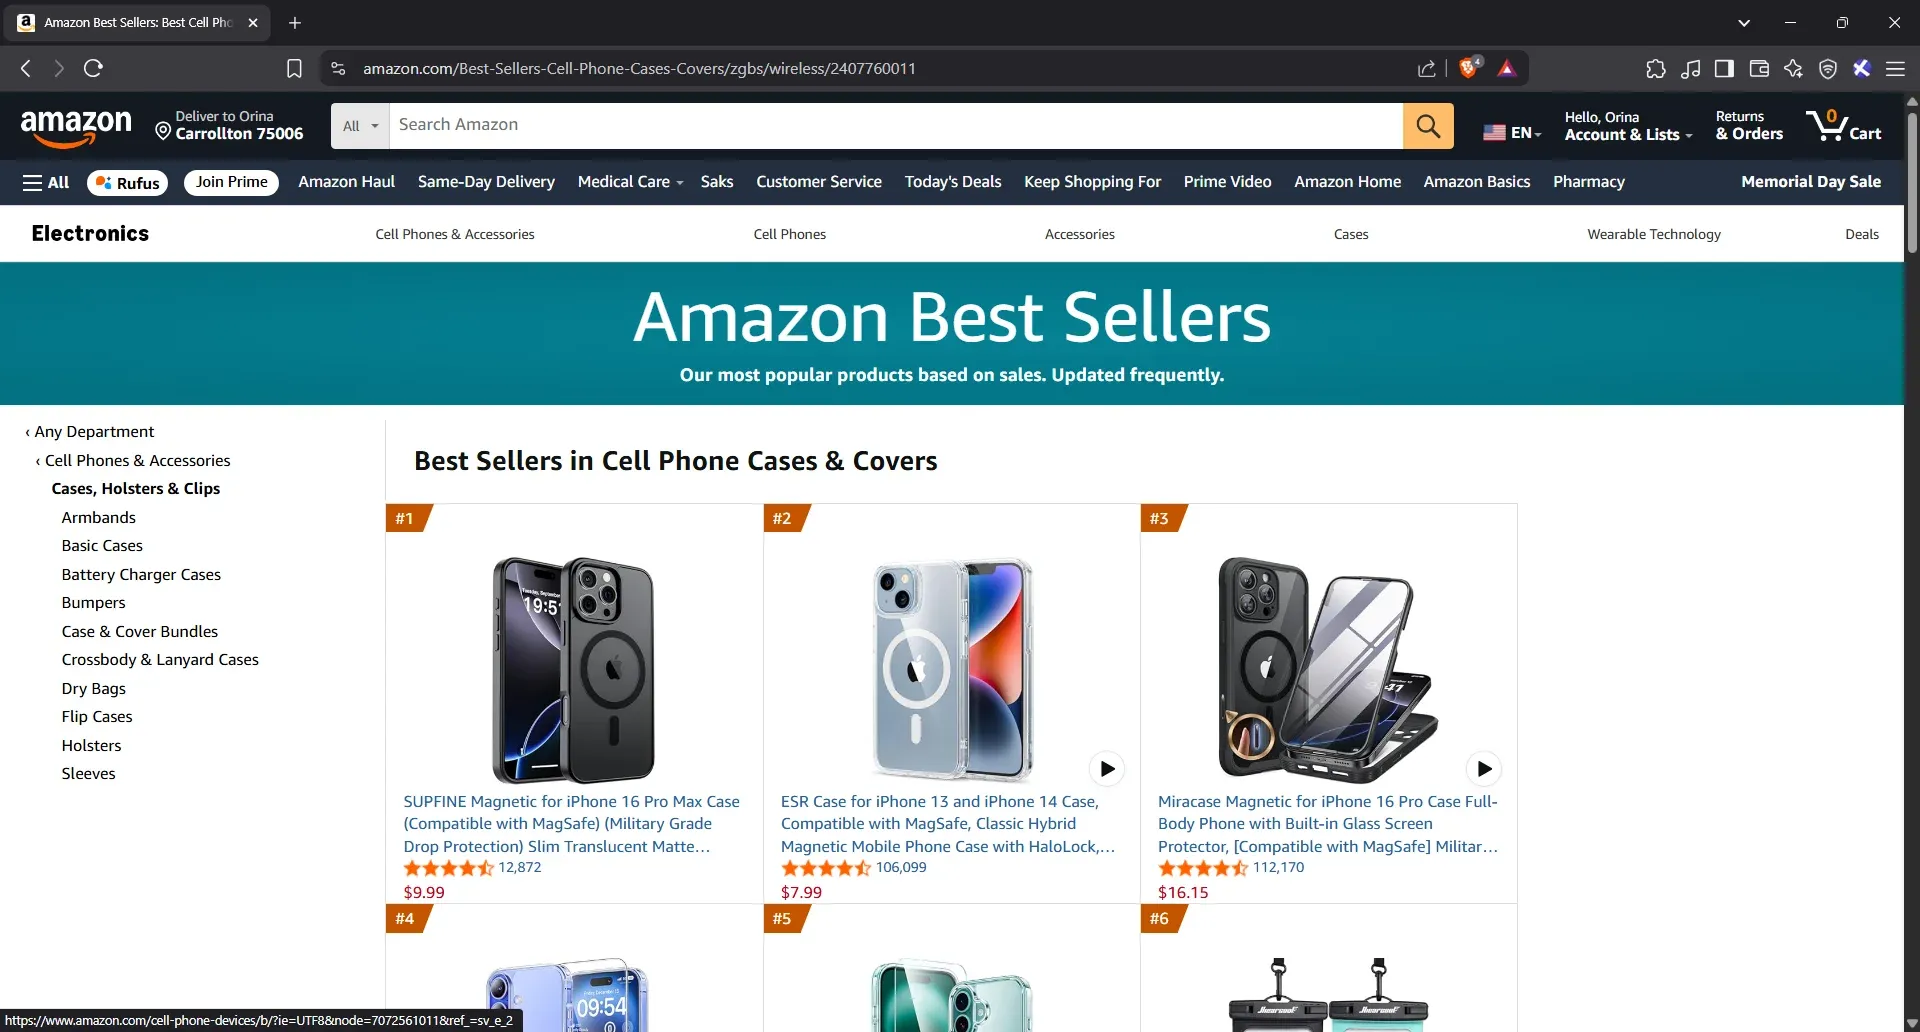
打开浏览器,访问美国亚马逊手机壳类目的畅销榜页面,然后让我们逐个元素来填写这张表格,以下是我们整理的内容:
- 查看手机壳标题
您不需要对每个商品列表都这样做,我们只是要确定一次页面结构。随便选一个手机壳商品,右键点击商品标题,然后在菜单中选择“检查”。这将打开浏览器的开发者工具,并高亮显示标题对应的 HTML 元素。
- 找到商品标题对应的 HTML 行
右侧会弹出 HTML 代码,并高亮显示某一行。将鼠标悬停在该行上,如果页面上的商品标题随之高亮,就说明您找对了位置。
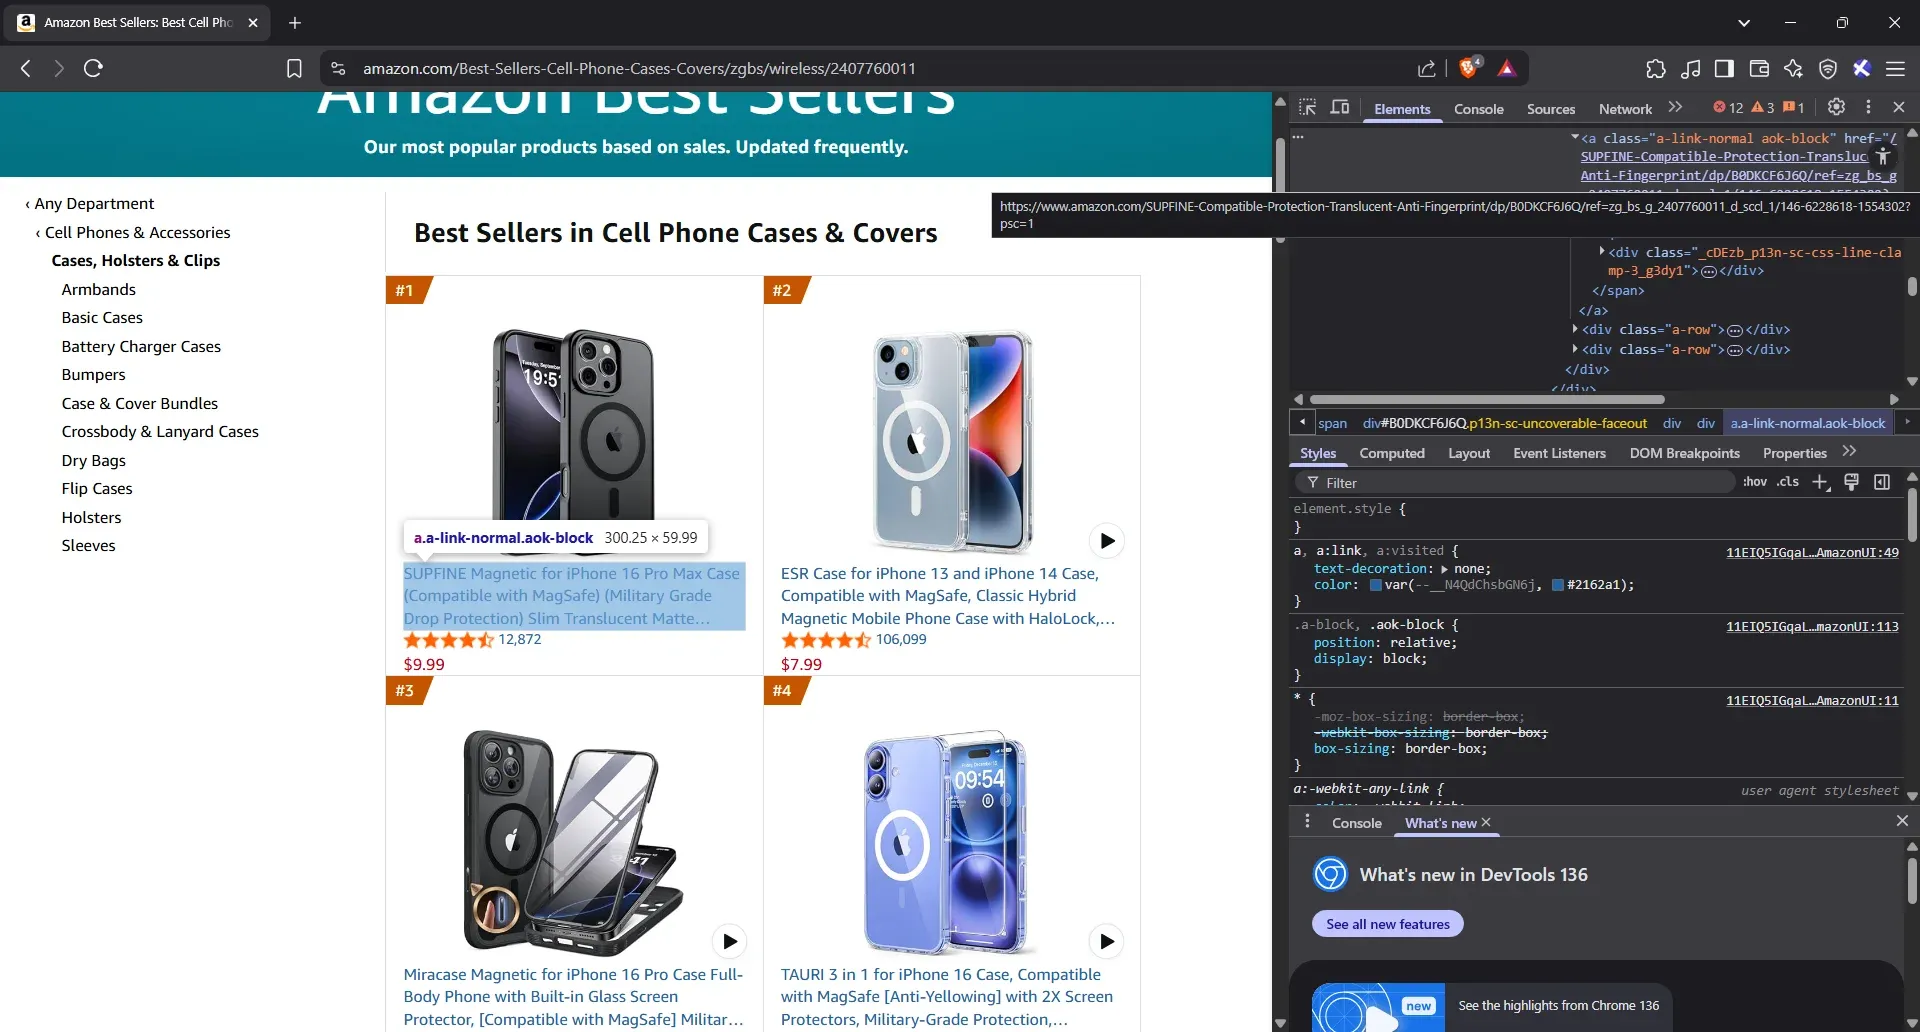
- 提取商品标题的标签类型、类名和属性
现在,我们可以开始填写参考表格的第一行了。看看您刚才悬停的那一行——它是嵌套在 <span> 内部的一个 <div>,这正是我们需要关注的标签。
请完整复制该类名字符串,即使看起来很杂乱也没关系。属性列暂时留空,示例值可以从商品名称中挑一两个词,方便您后续测试时识别。以下是填完第一行的表格:
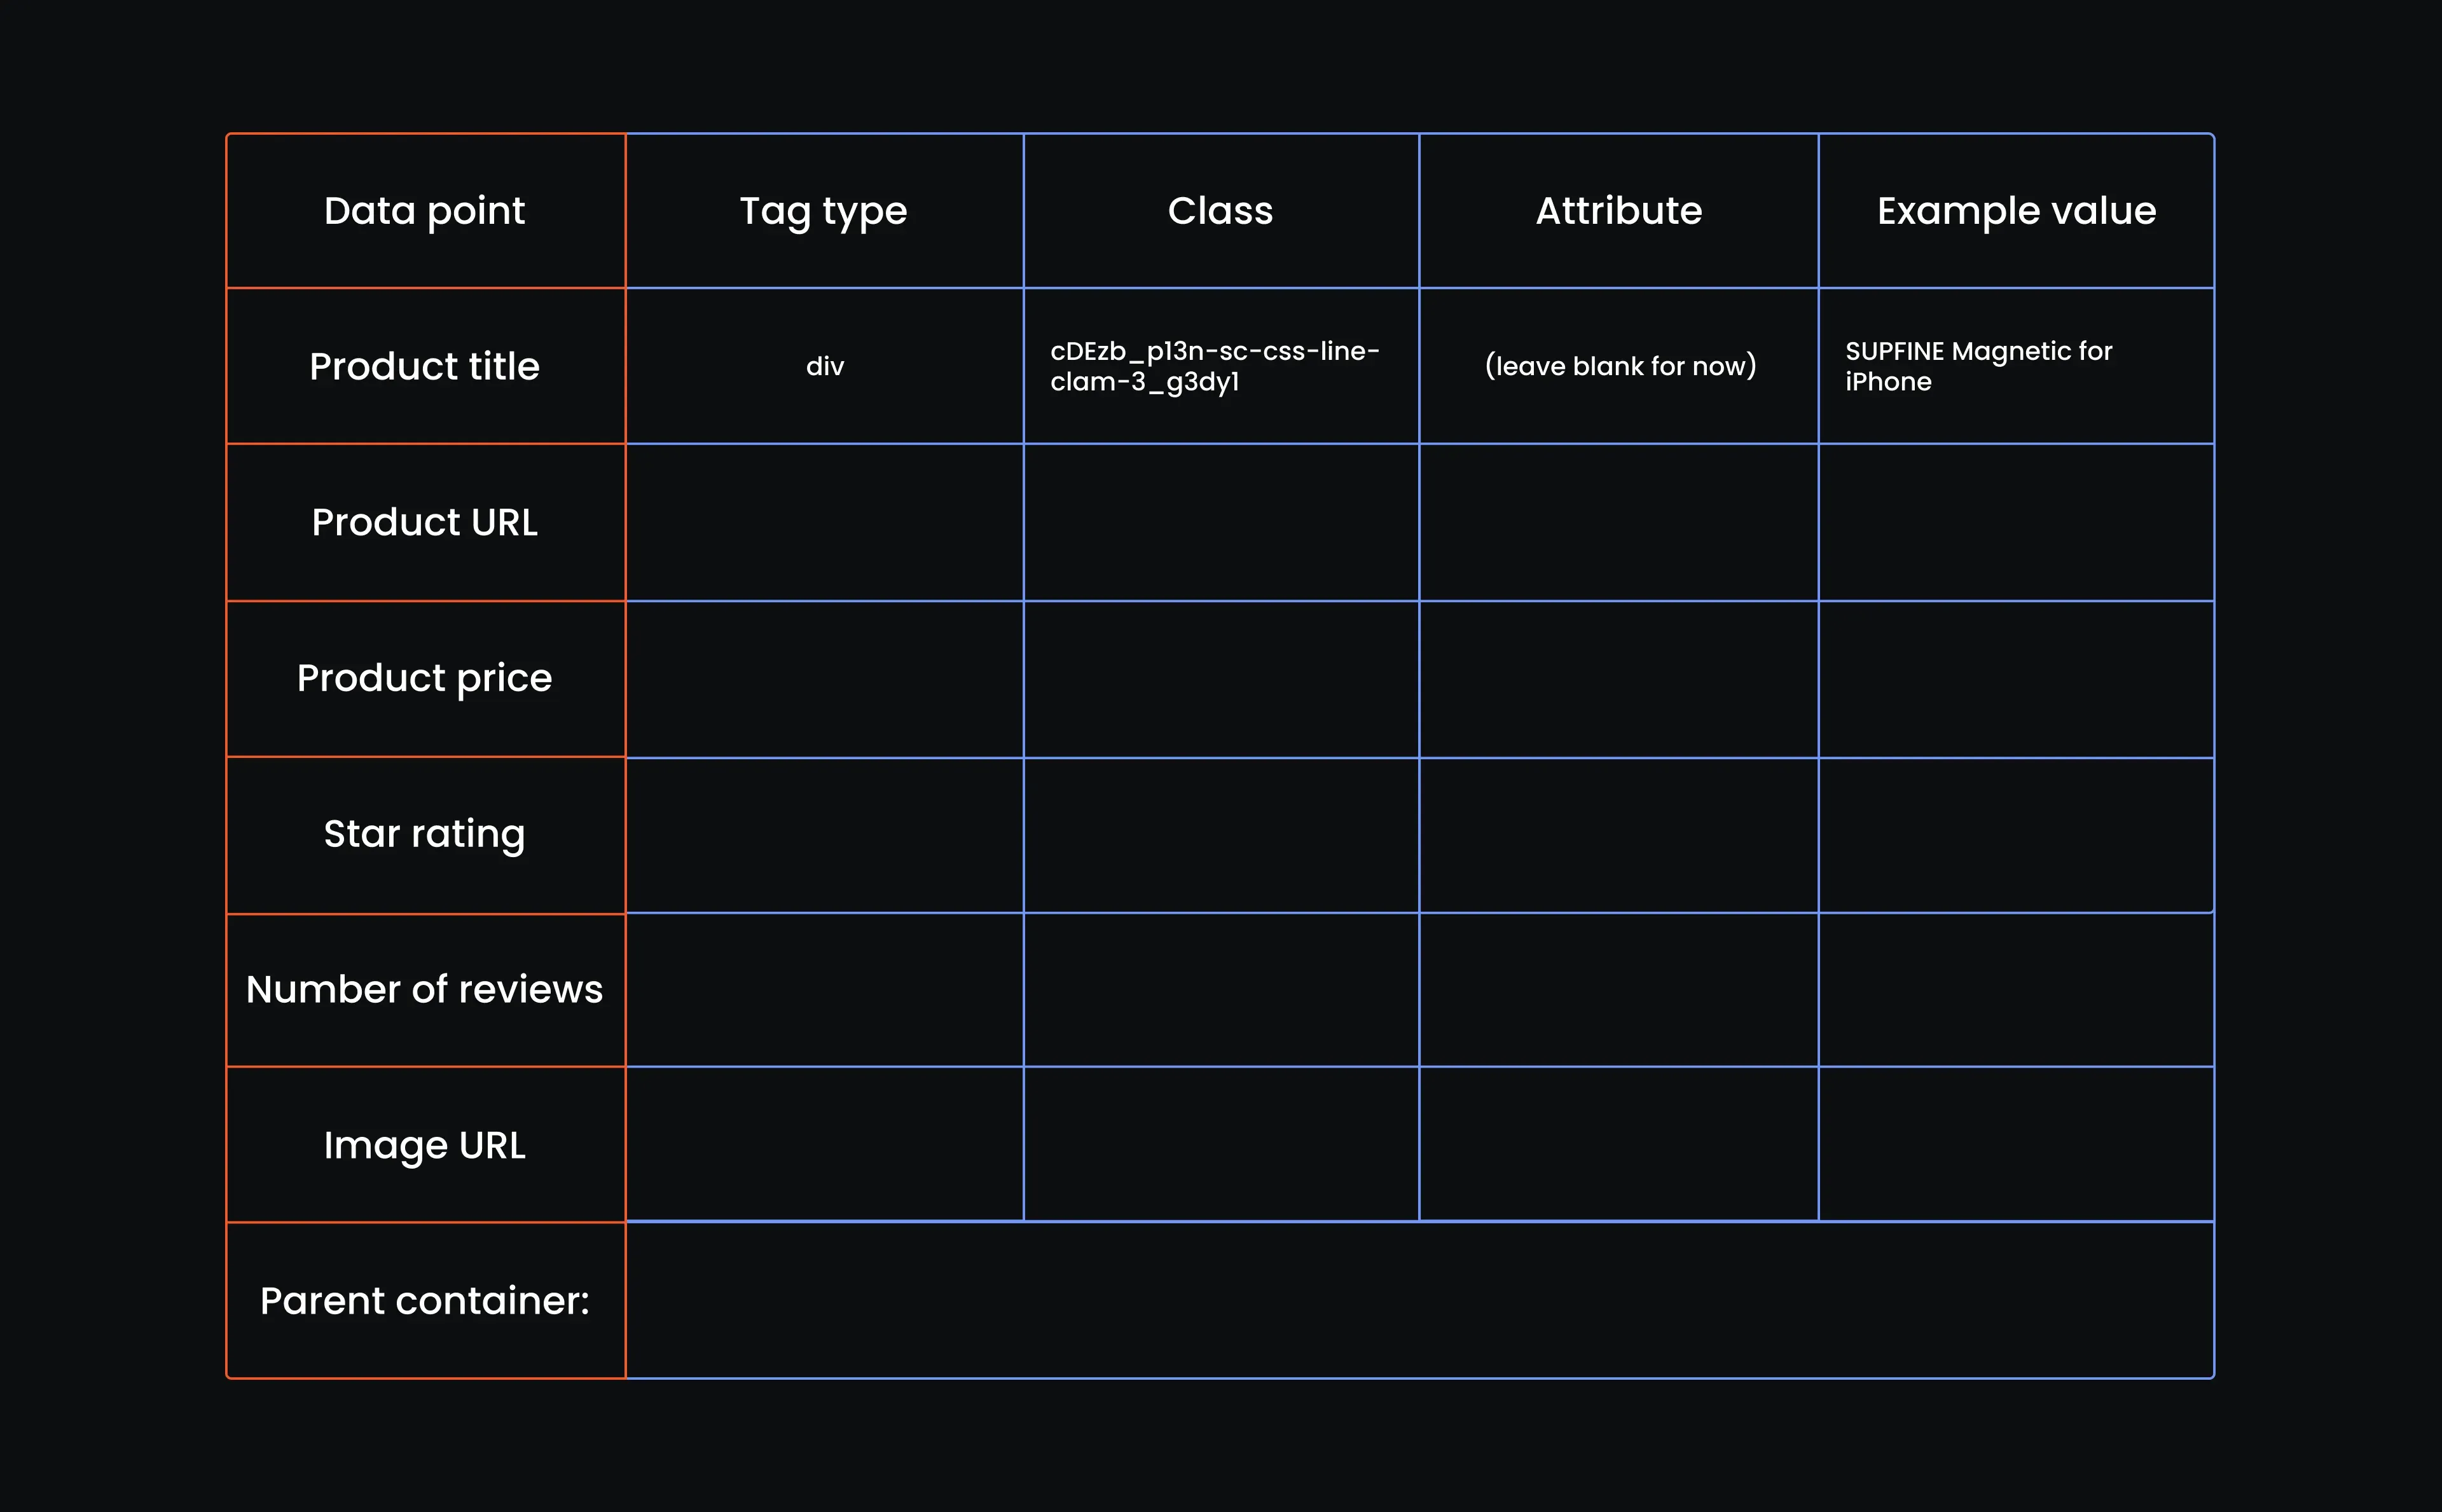
- 查看商品 URL
从商品标题的 HTML 位置往上移动一行,您会看到一个以 <a 开头的标签。这就是锚标签,它承载着商品的 URL。如果页面上的商品标题依然保持高亮,就说明您找对了。
- 提取商品 URL 的标签、类名和属性
您看到包裹着标题 <div> 的那个锚标签了吗?那就是我们要找的目标,它链接到商品详情页。那么现在就填写第二行:标签填 a,类名按原样复制,属性列填 href。
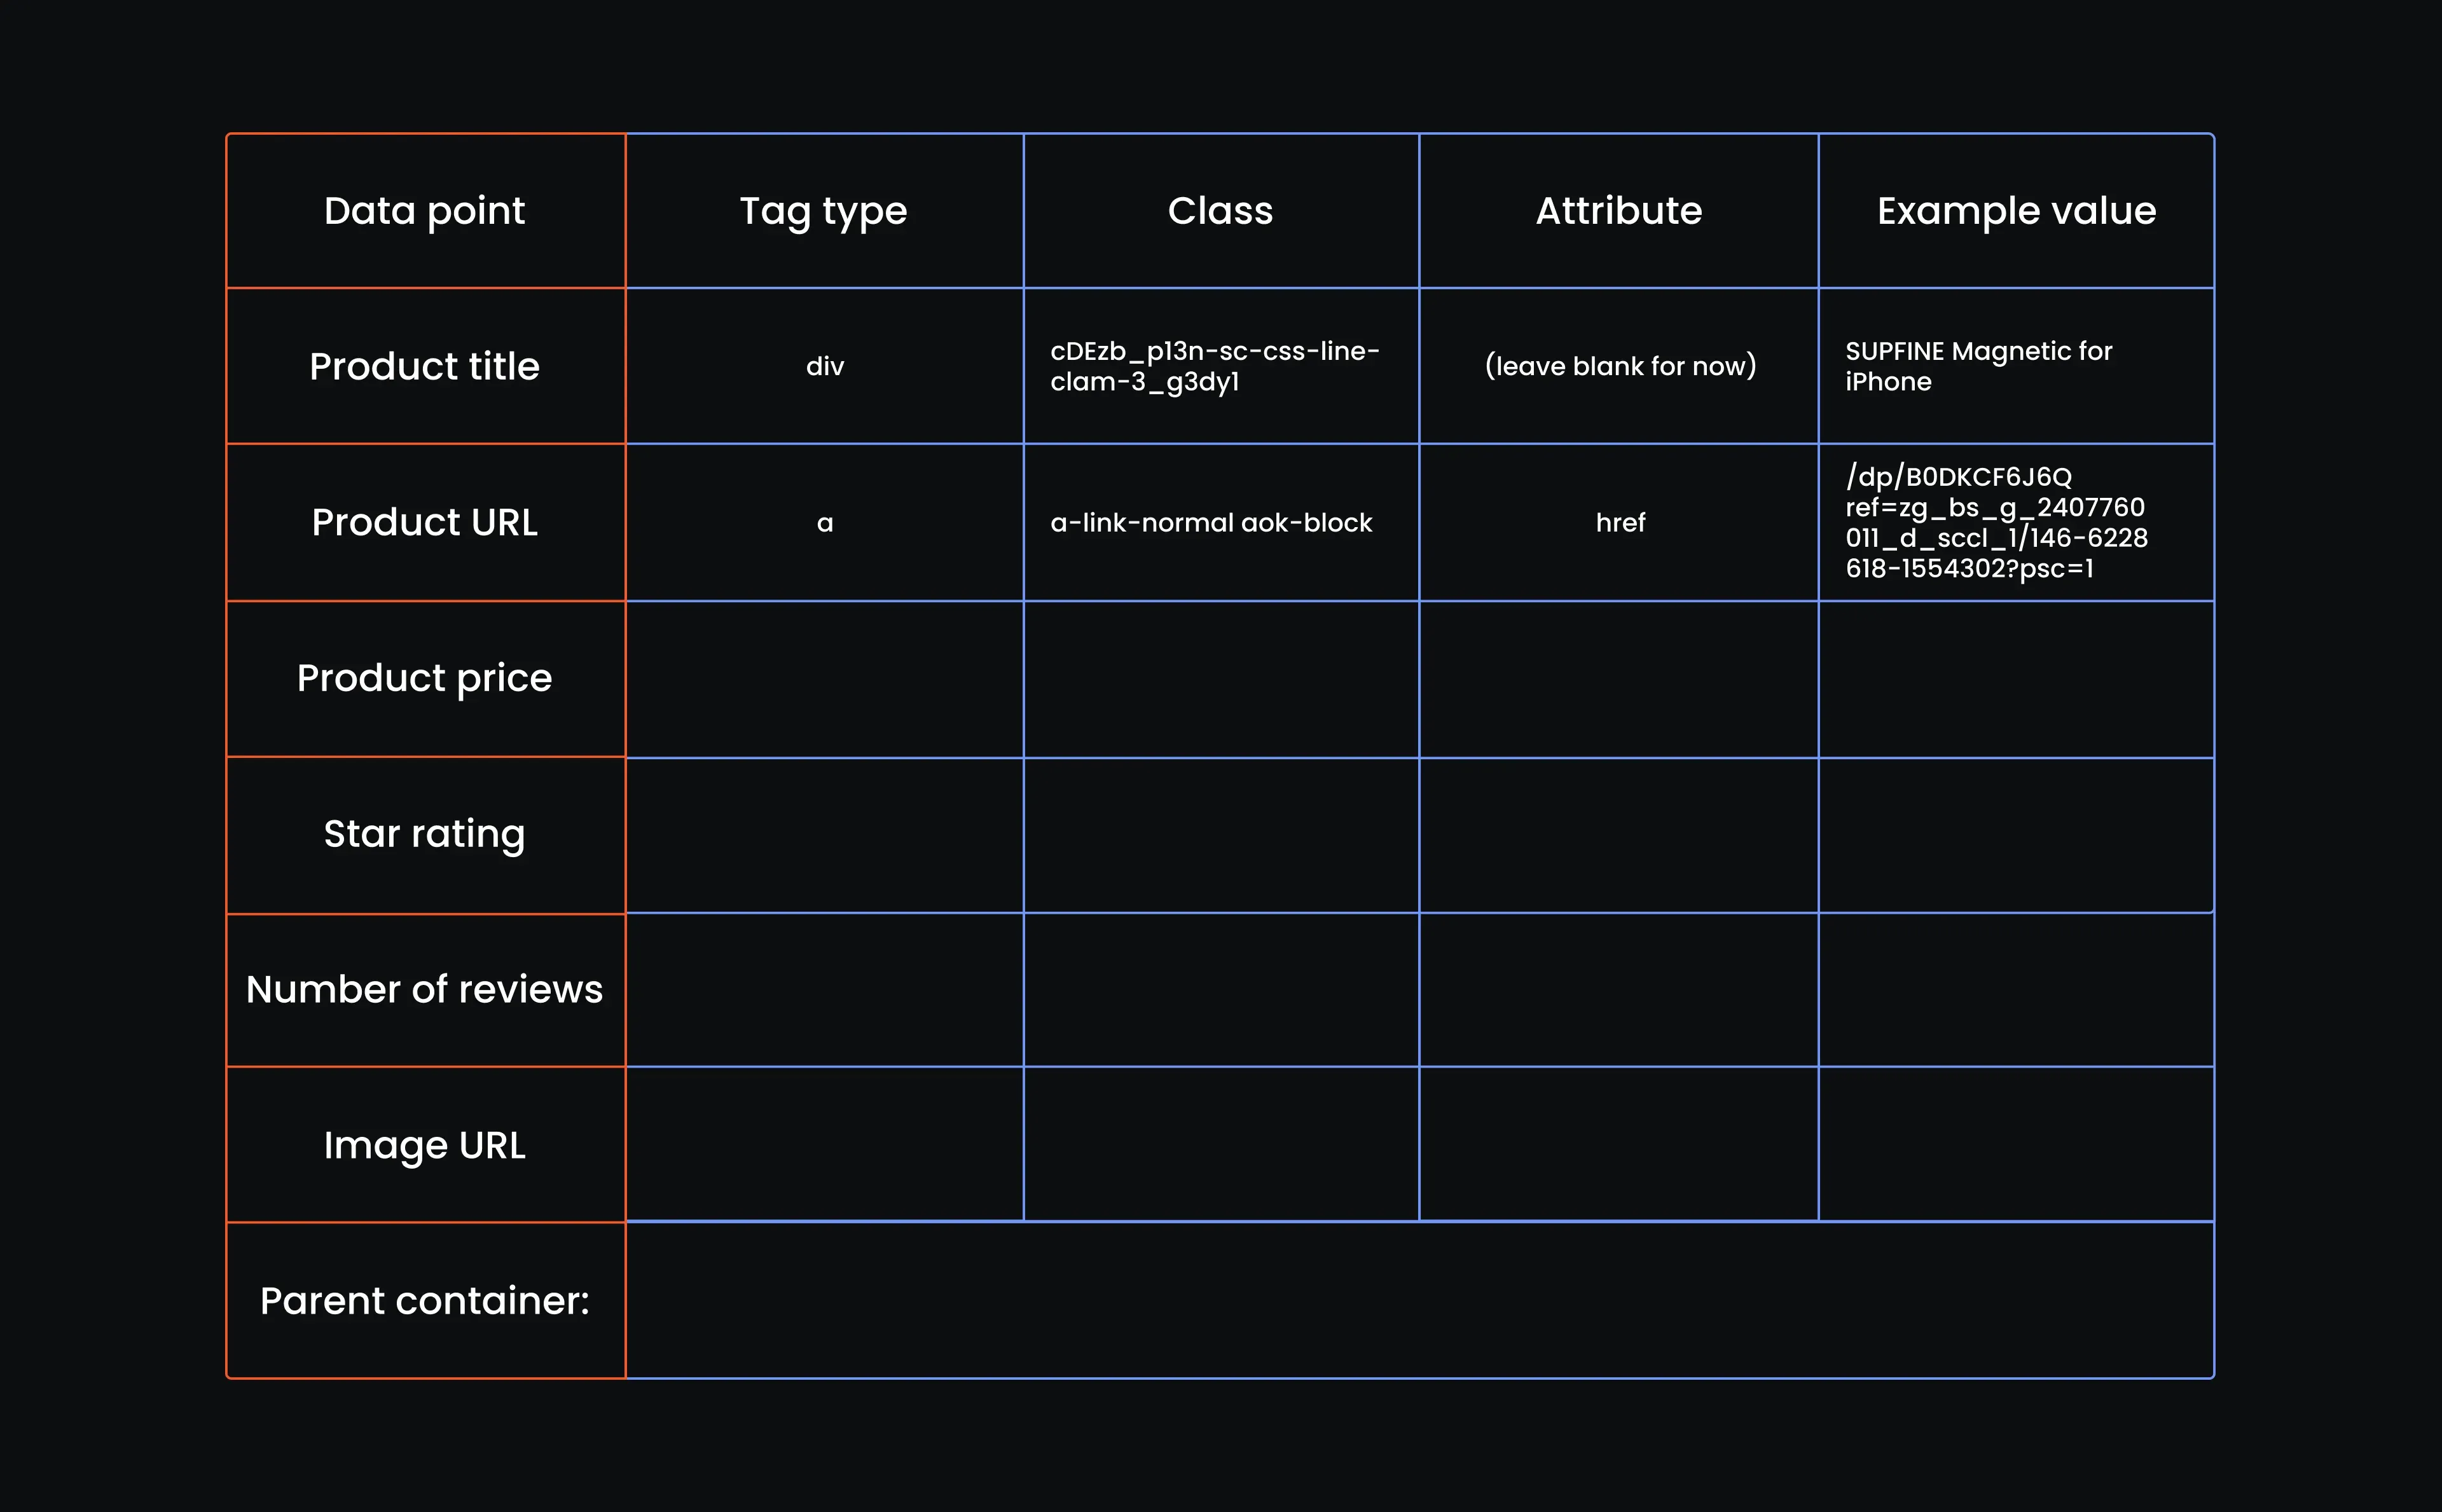
- 查看商品价格
接下来看价格。直接右键点击标题下方显示的数字,然后点击“检查”。您会看到一行新的 HTML 代码,将鼠标悬停在上面,如果页面上的价格变蓝或被高亮,就说明找对了。
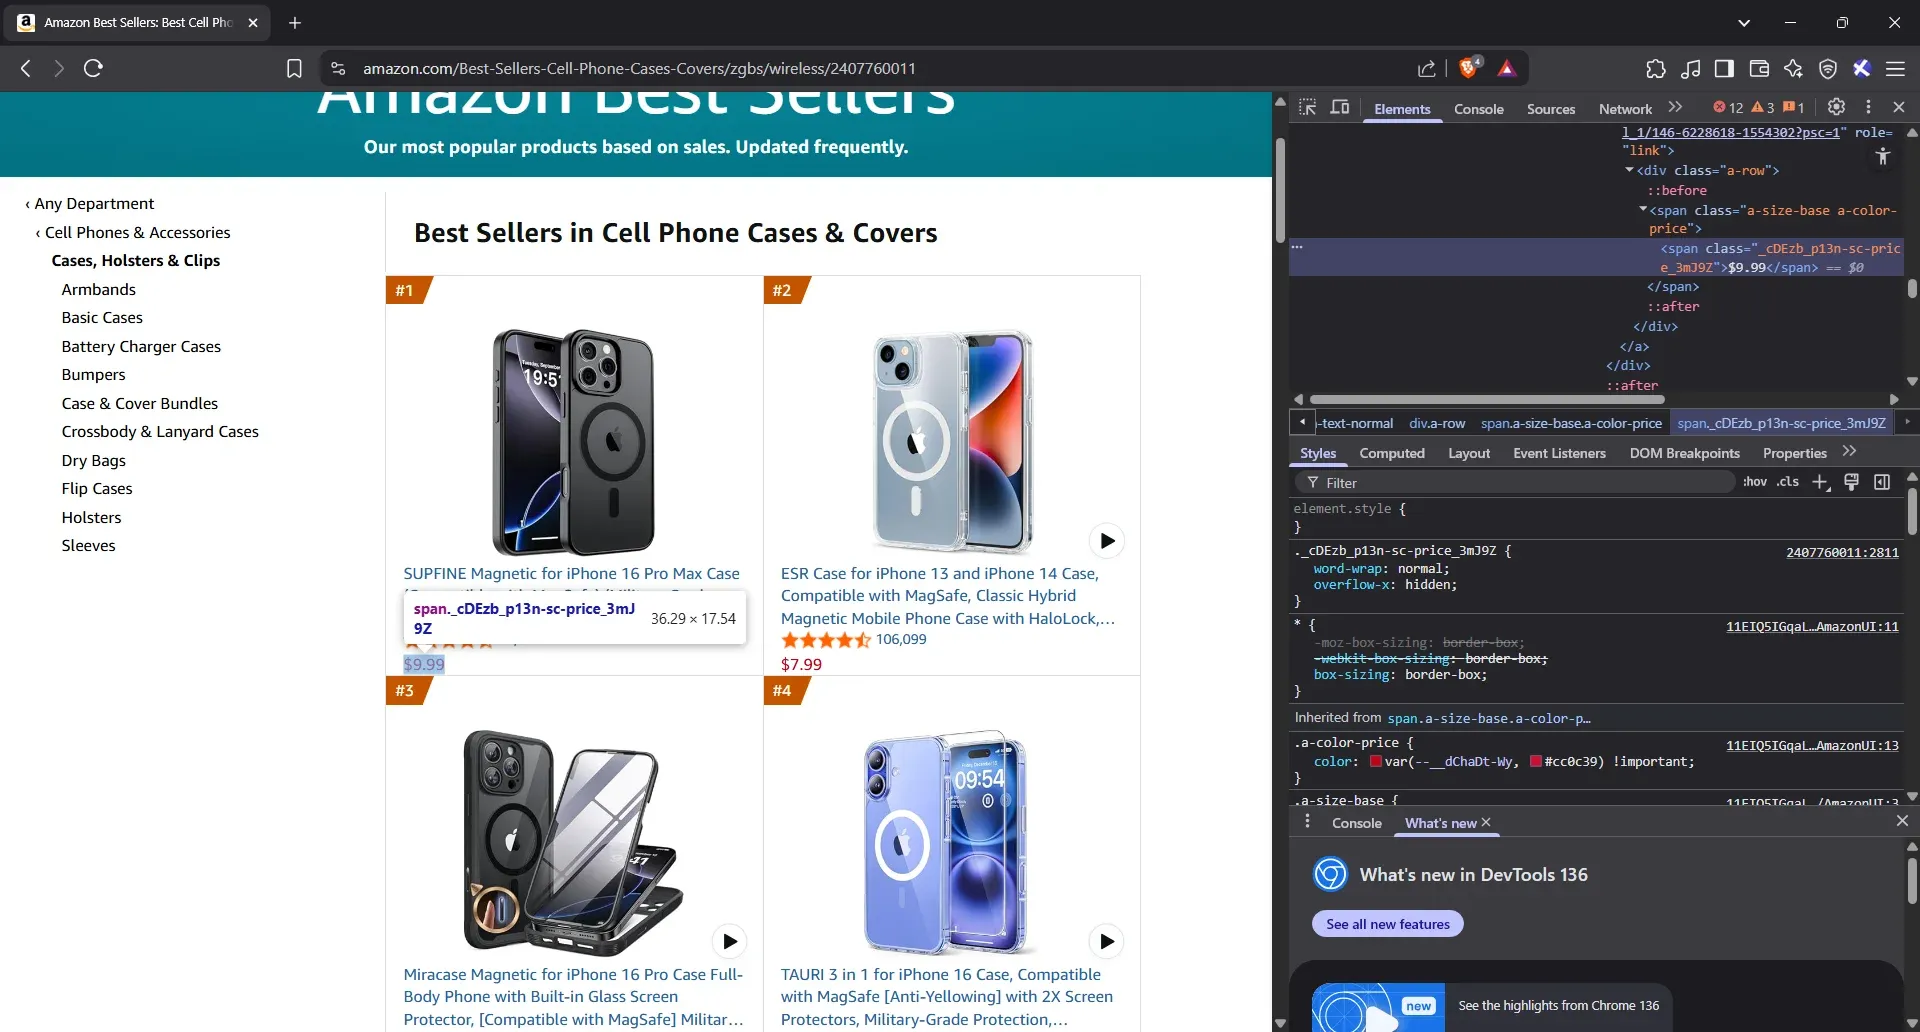
- 提取商品价格相关元素
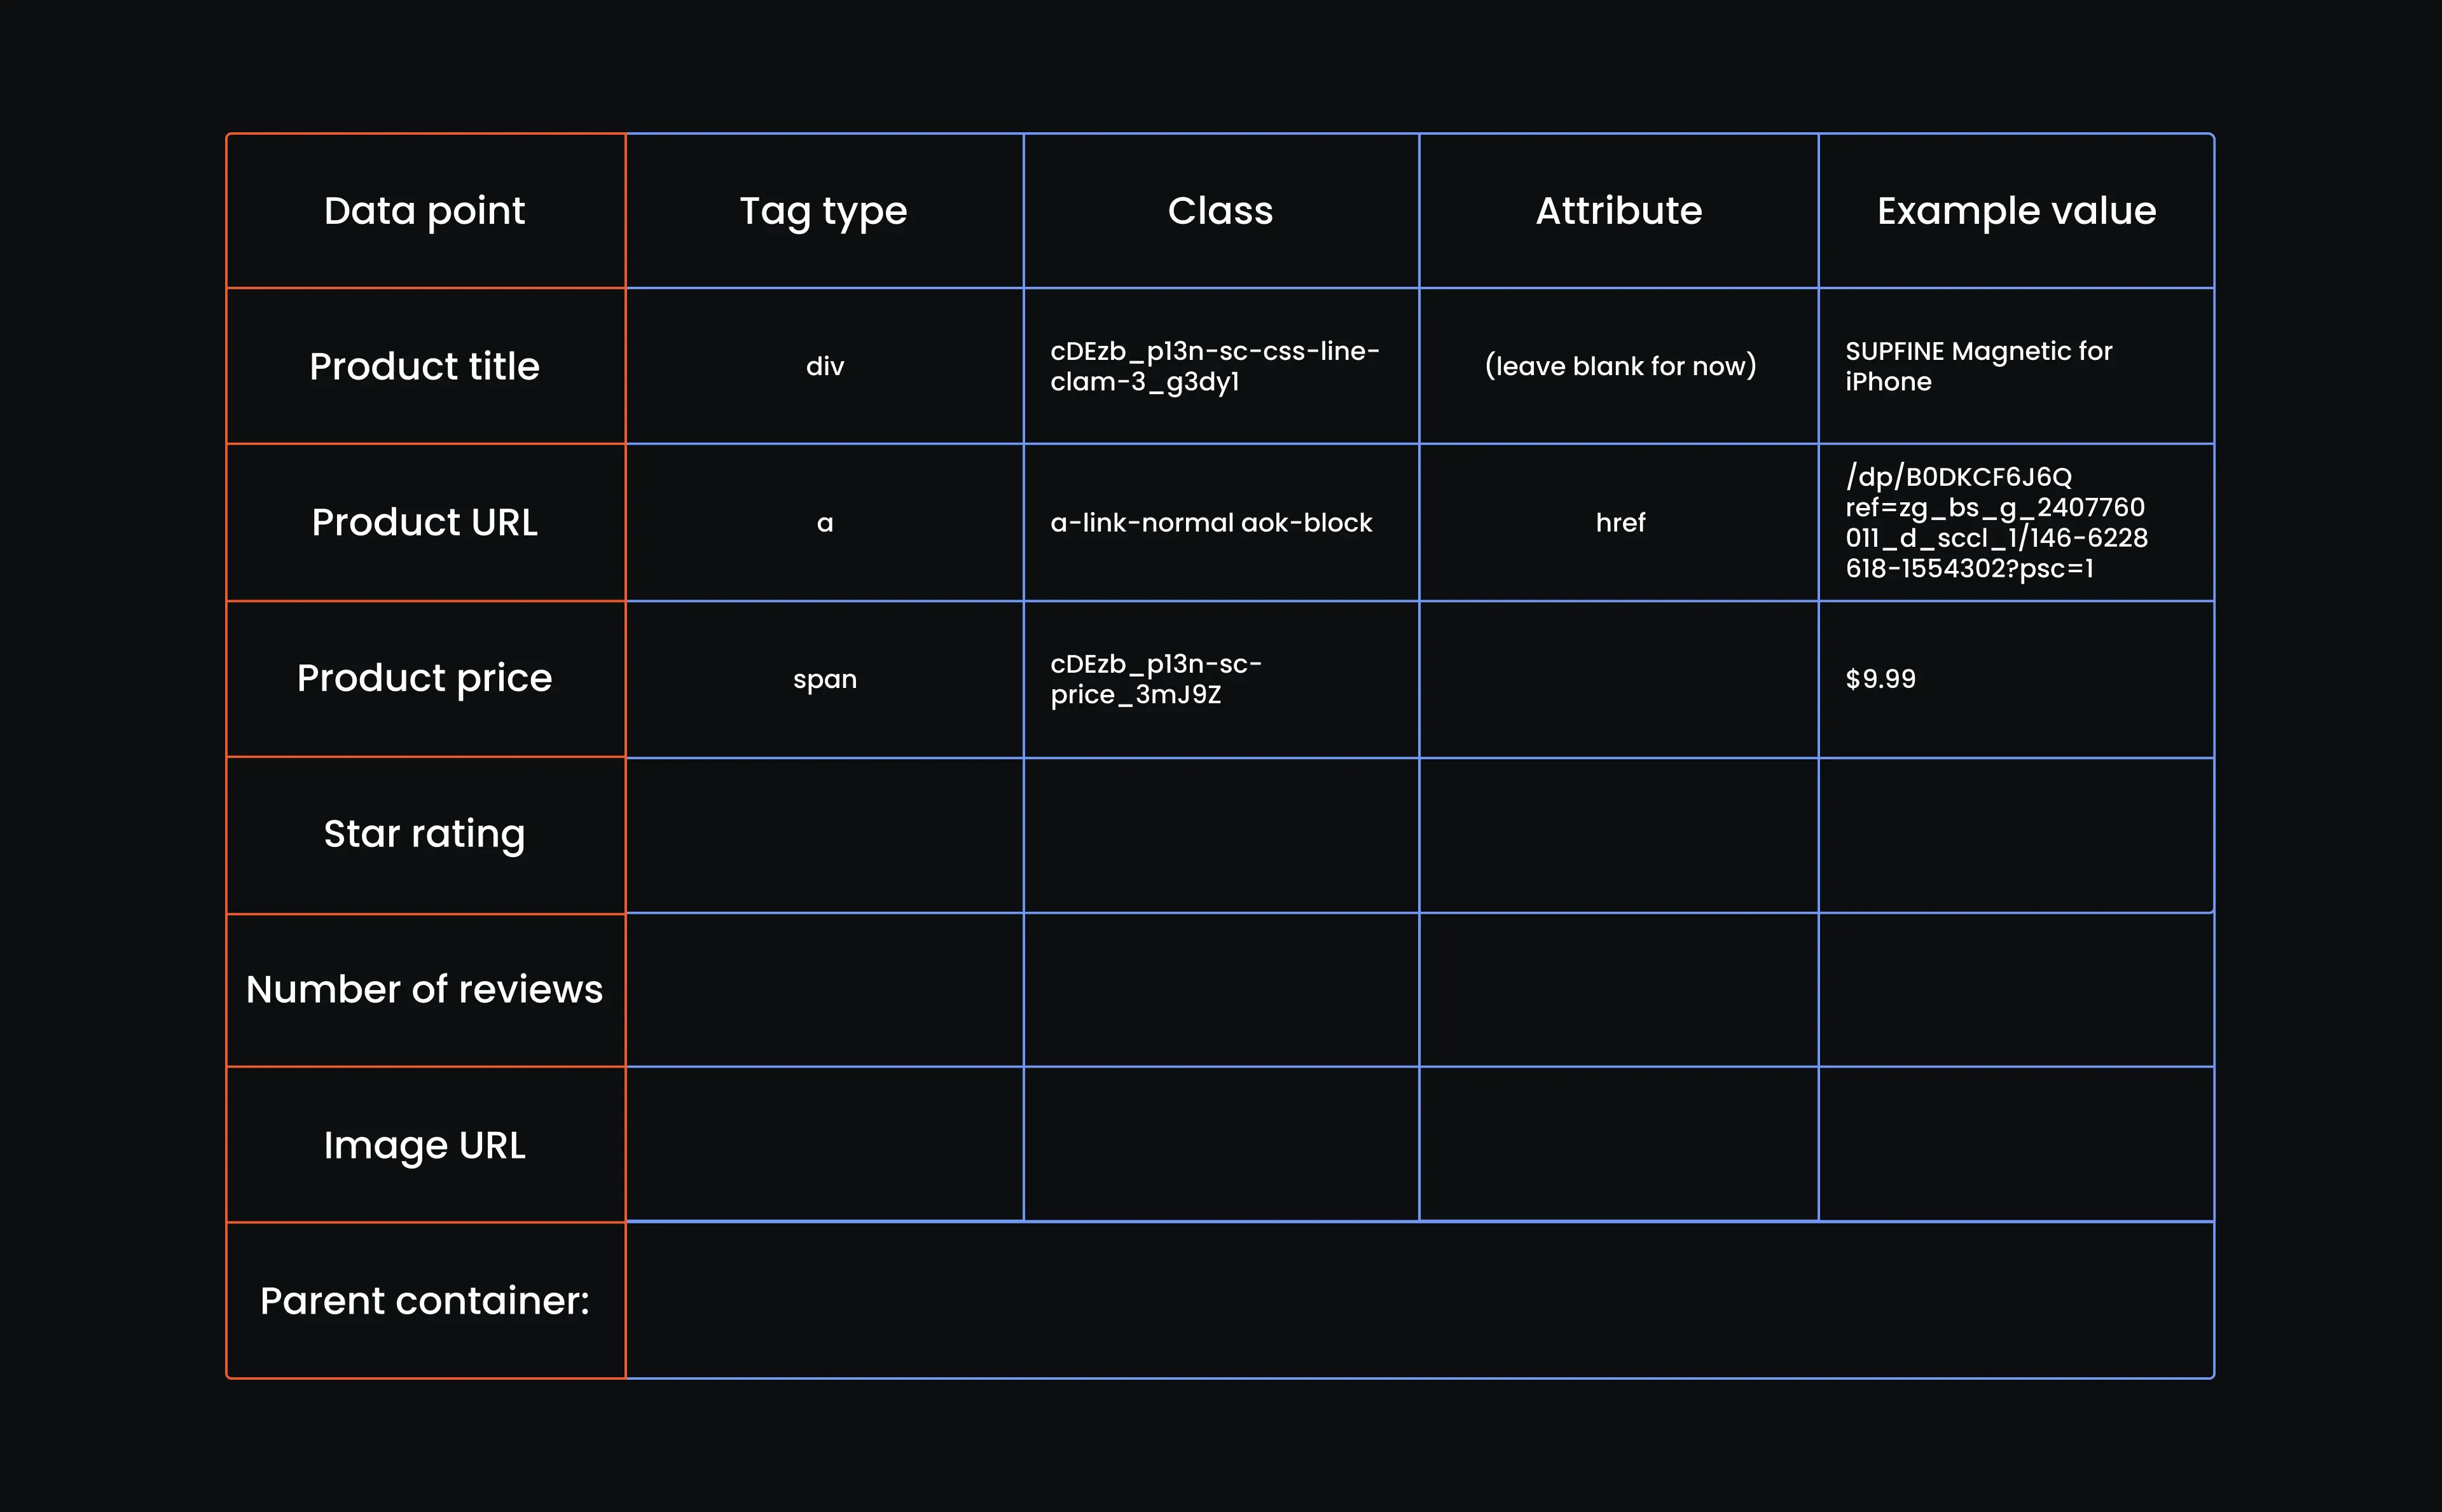
这一步很简单,您会看到价格干净利落地位于一个 <span> 标签内。直接复制完整类名并粘贴进去即可,这里不需要属性。示例值直接填入价格本身。以下是目前为止的参考表格:
- 查看星级评分
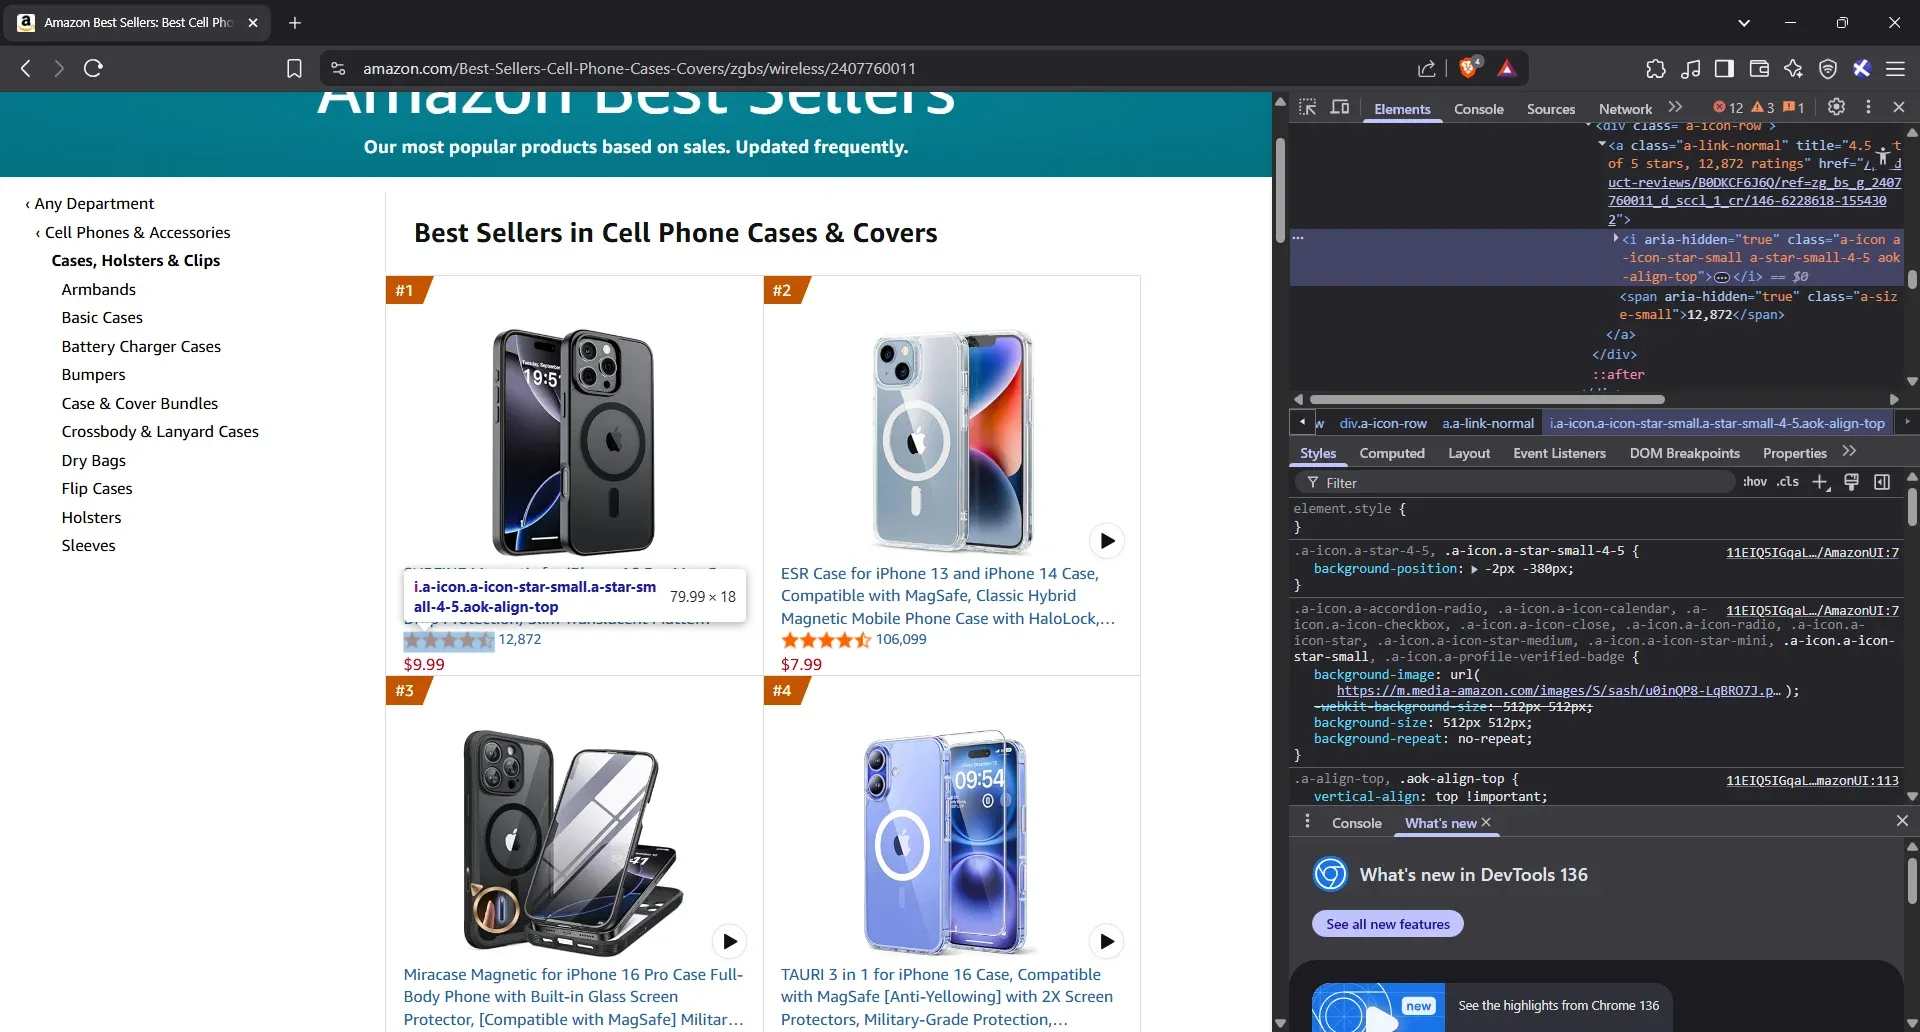
点击价格下方的星级评分,然后点击“检查”,浏览器右侧会弹出 HTML 面板。和之前一样,将鼠标悬停在高亮部分,确认它锁定的是正确的元素。
- 提取星级评分相关元素
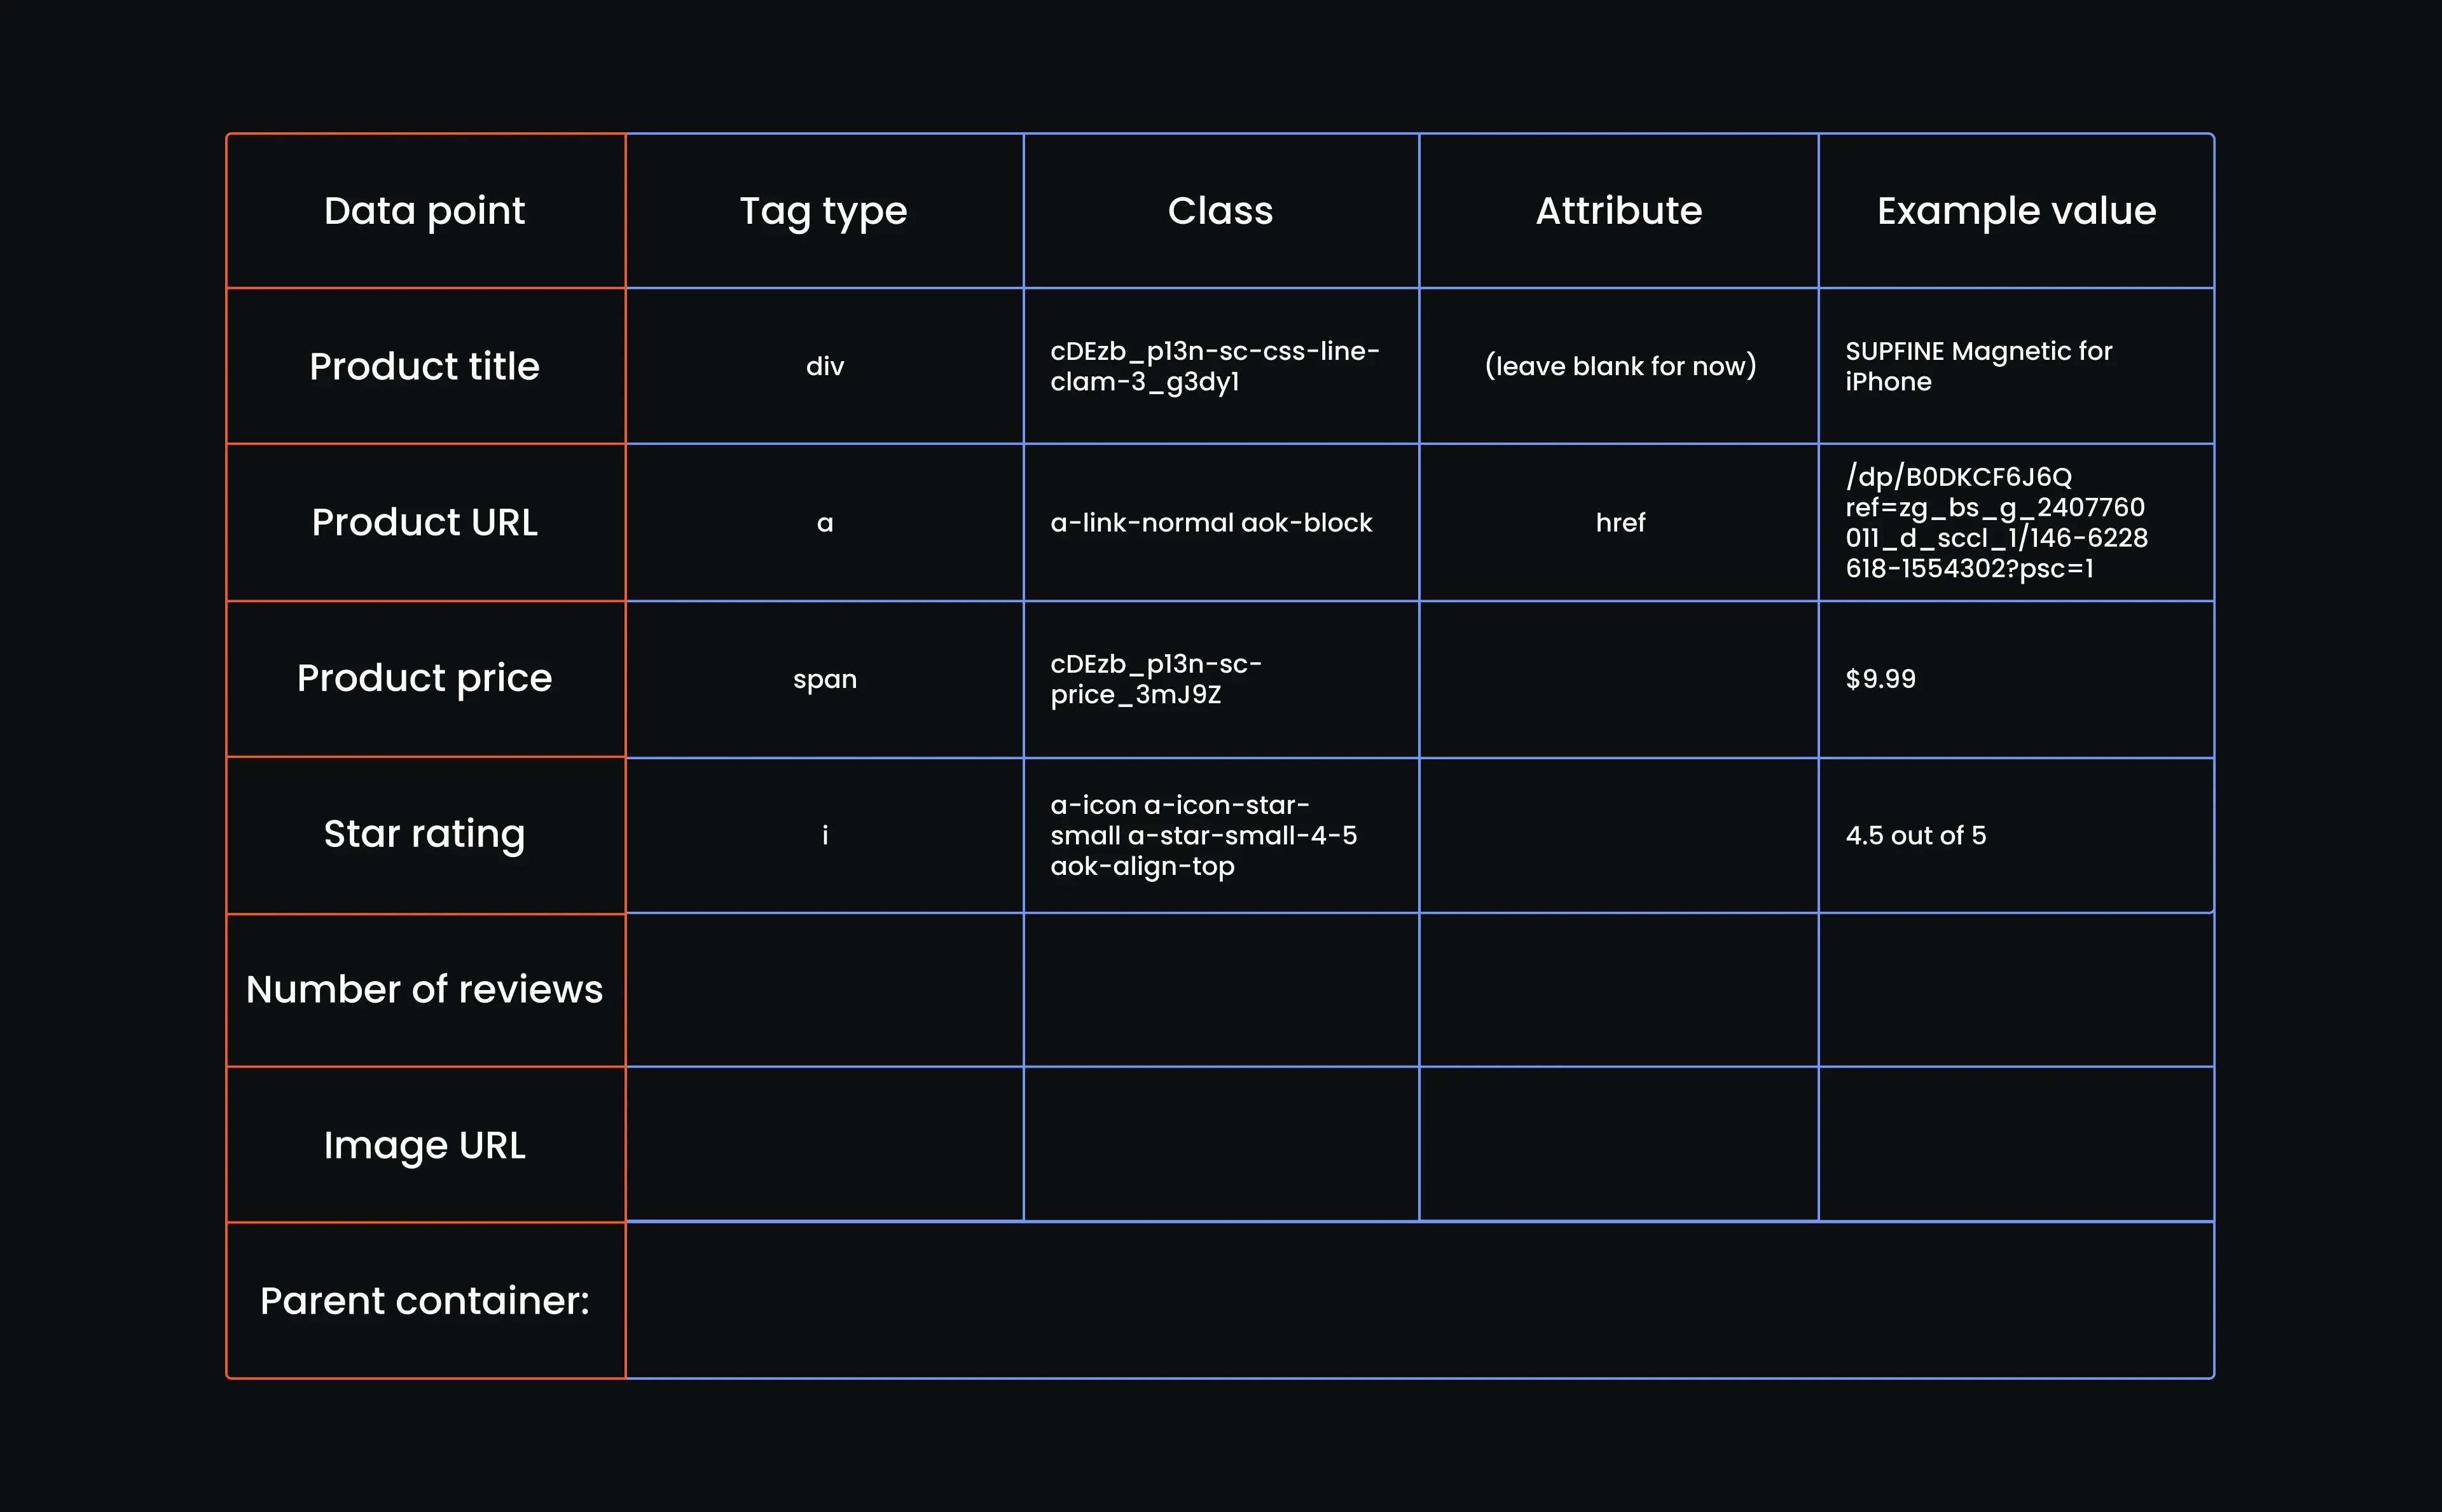
那个星星图标位于一个 <i> 标签内。请完整复制类名字符串,不要做任何裁剪。这里不需要属性,示例列直接填入 a-star-small-4-5 即可。
- 查看评论数量
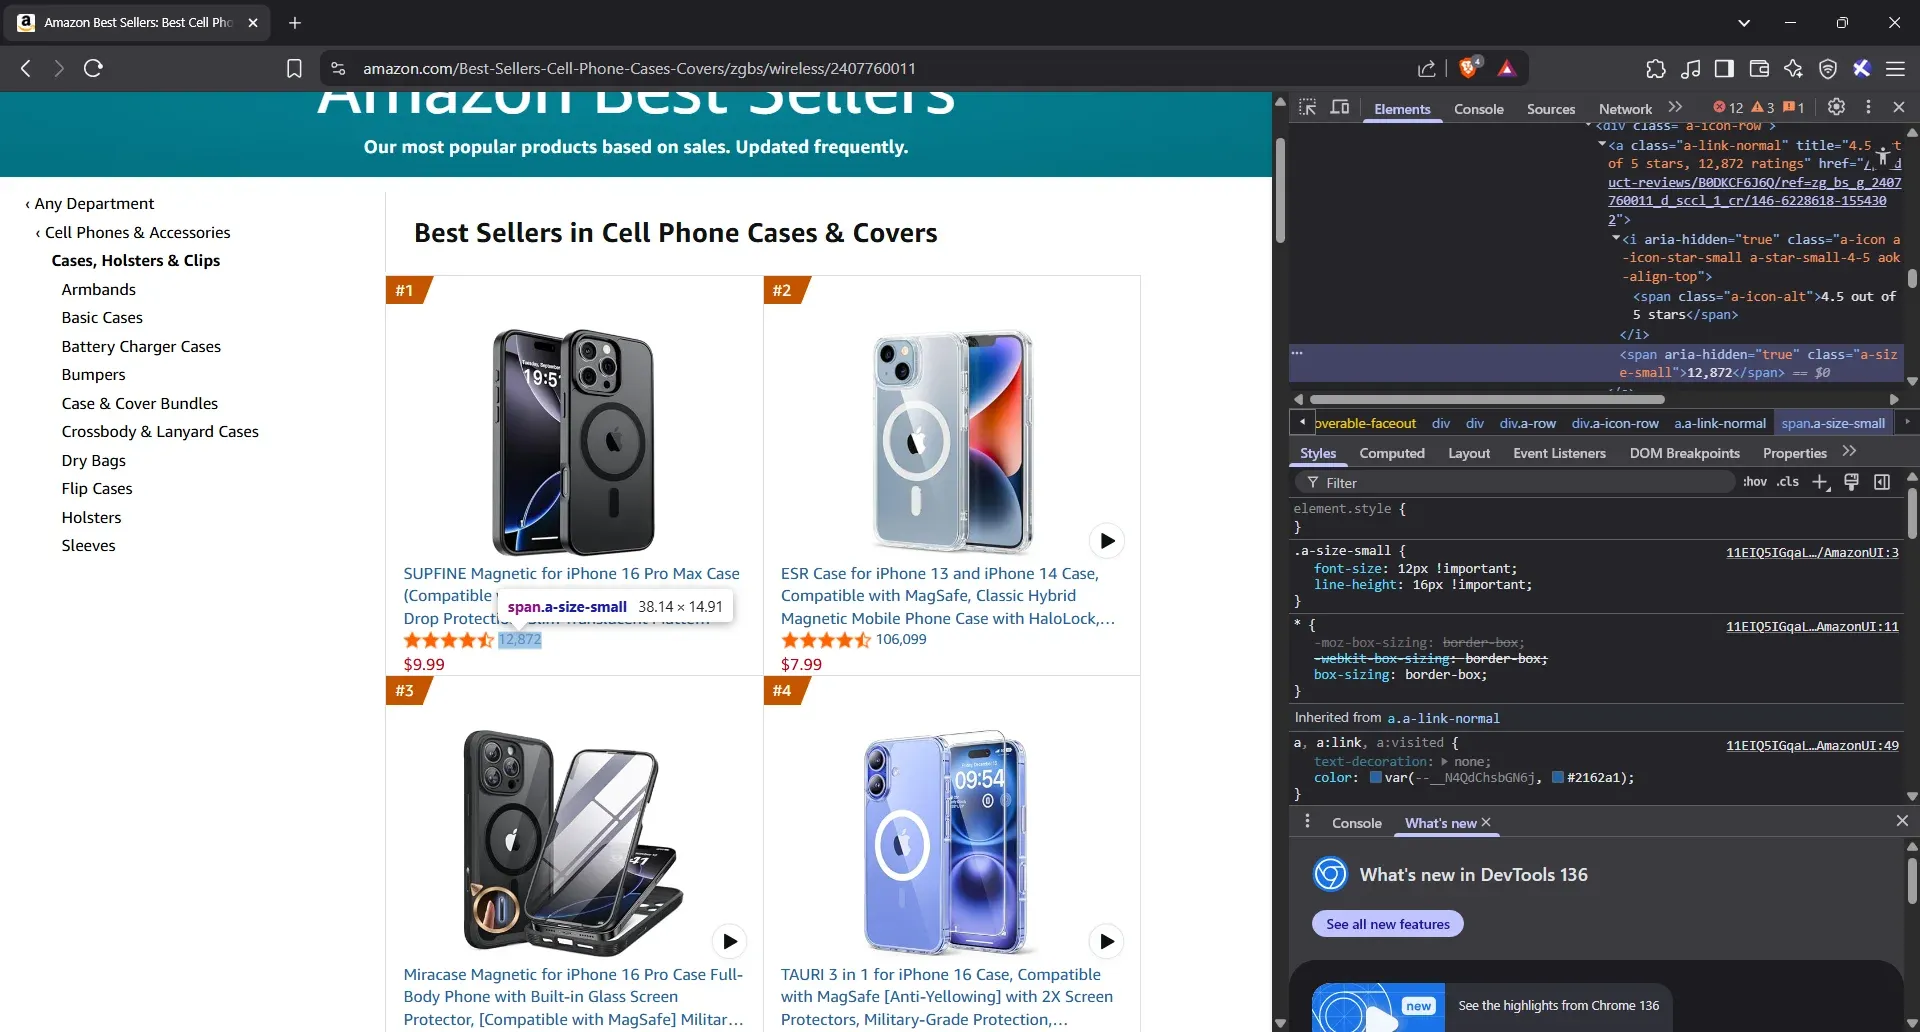
星星图标旁边会显示评论人数。点击这个数字,选择“检查”,浏览器就会显示它所在的 HTML 代码行。如果悬停时该数字高亮,就说明找对了。
- 提取评论数量相关属性
承载评论数量的 <span> 标签已经高亮显示,只需复制类名,并记下看到的数字,这一行就完成了。
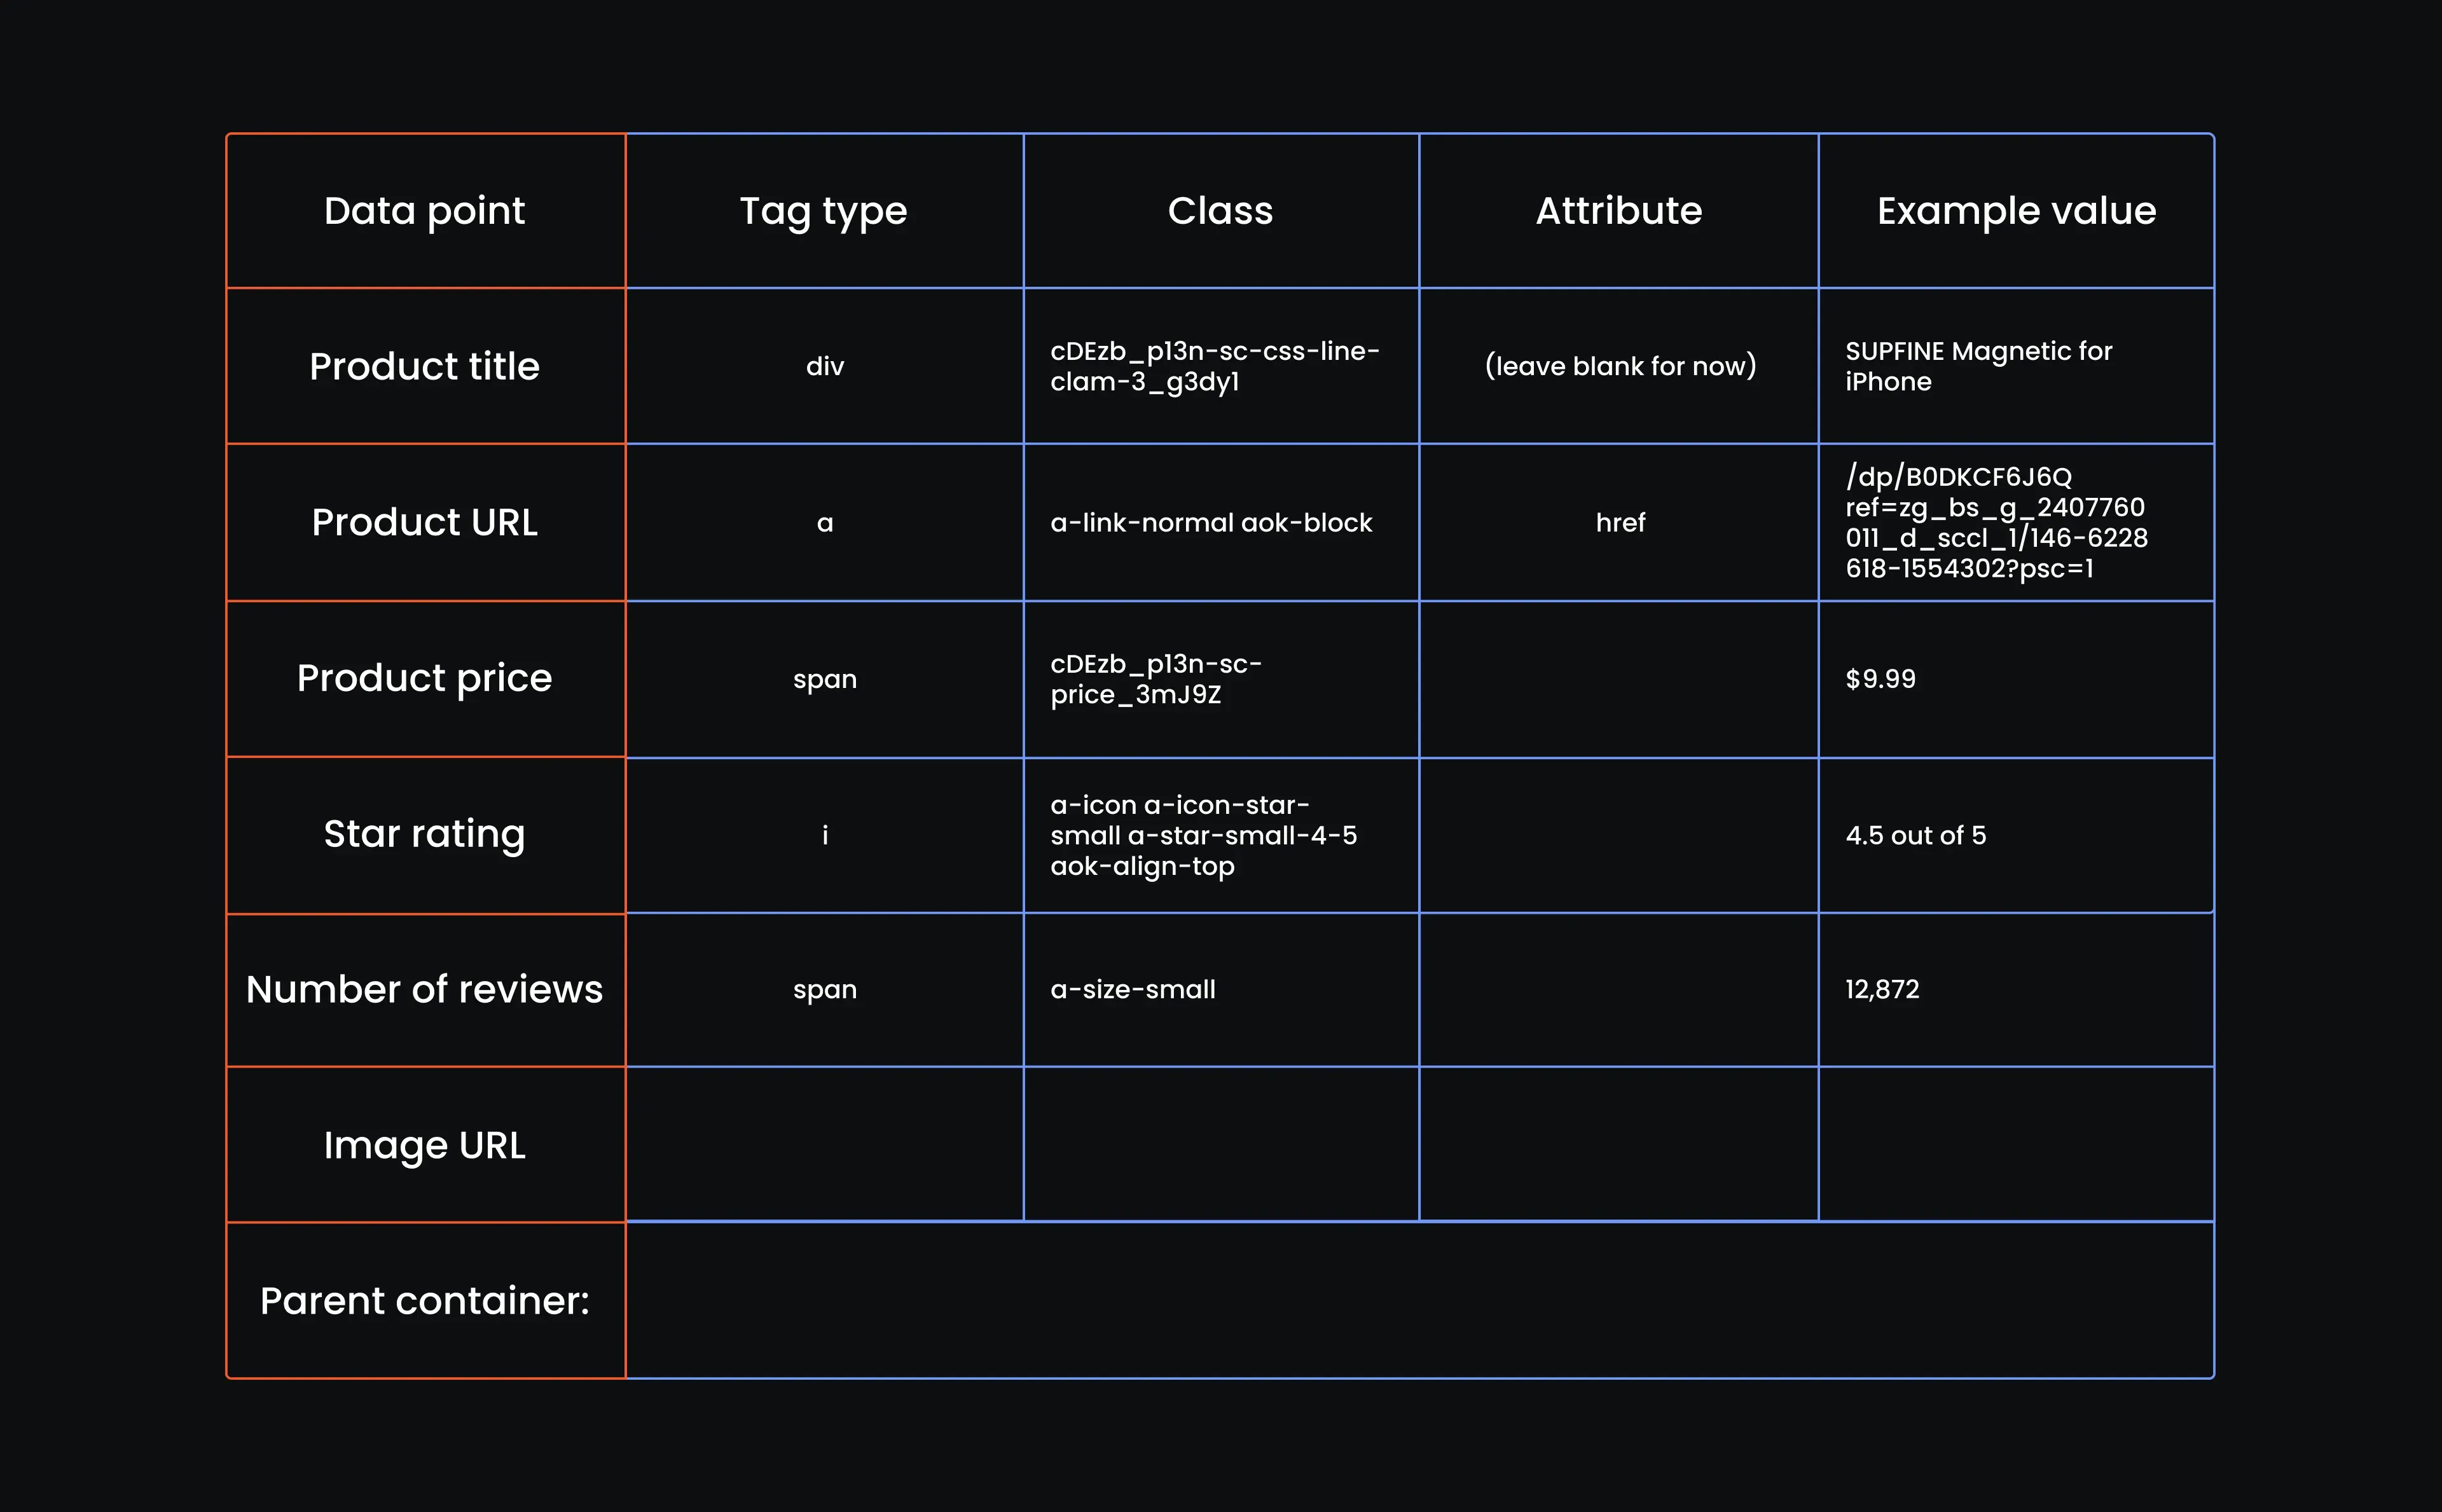
- 查看图片 URL
点击图片本身,然后点击“检查”。当 <img> 标签高亮后,将鼠标悬停在上面,如果页面上的图片随之发光高亮,就说明找对了位置。
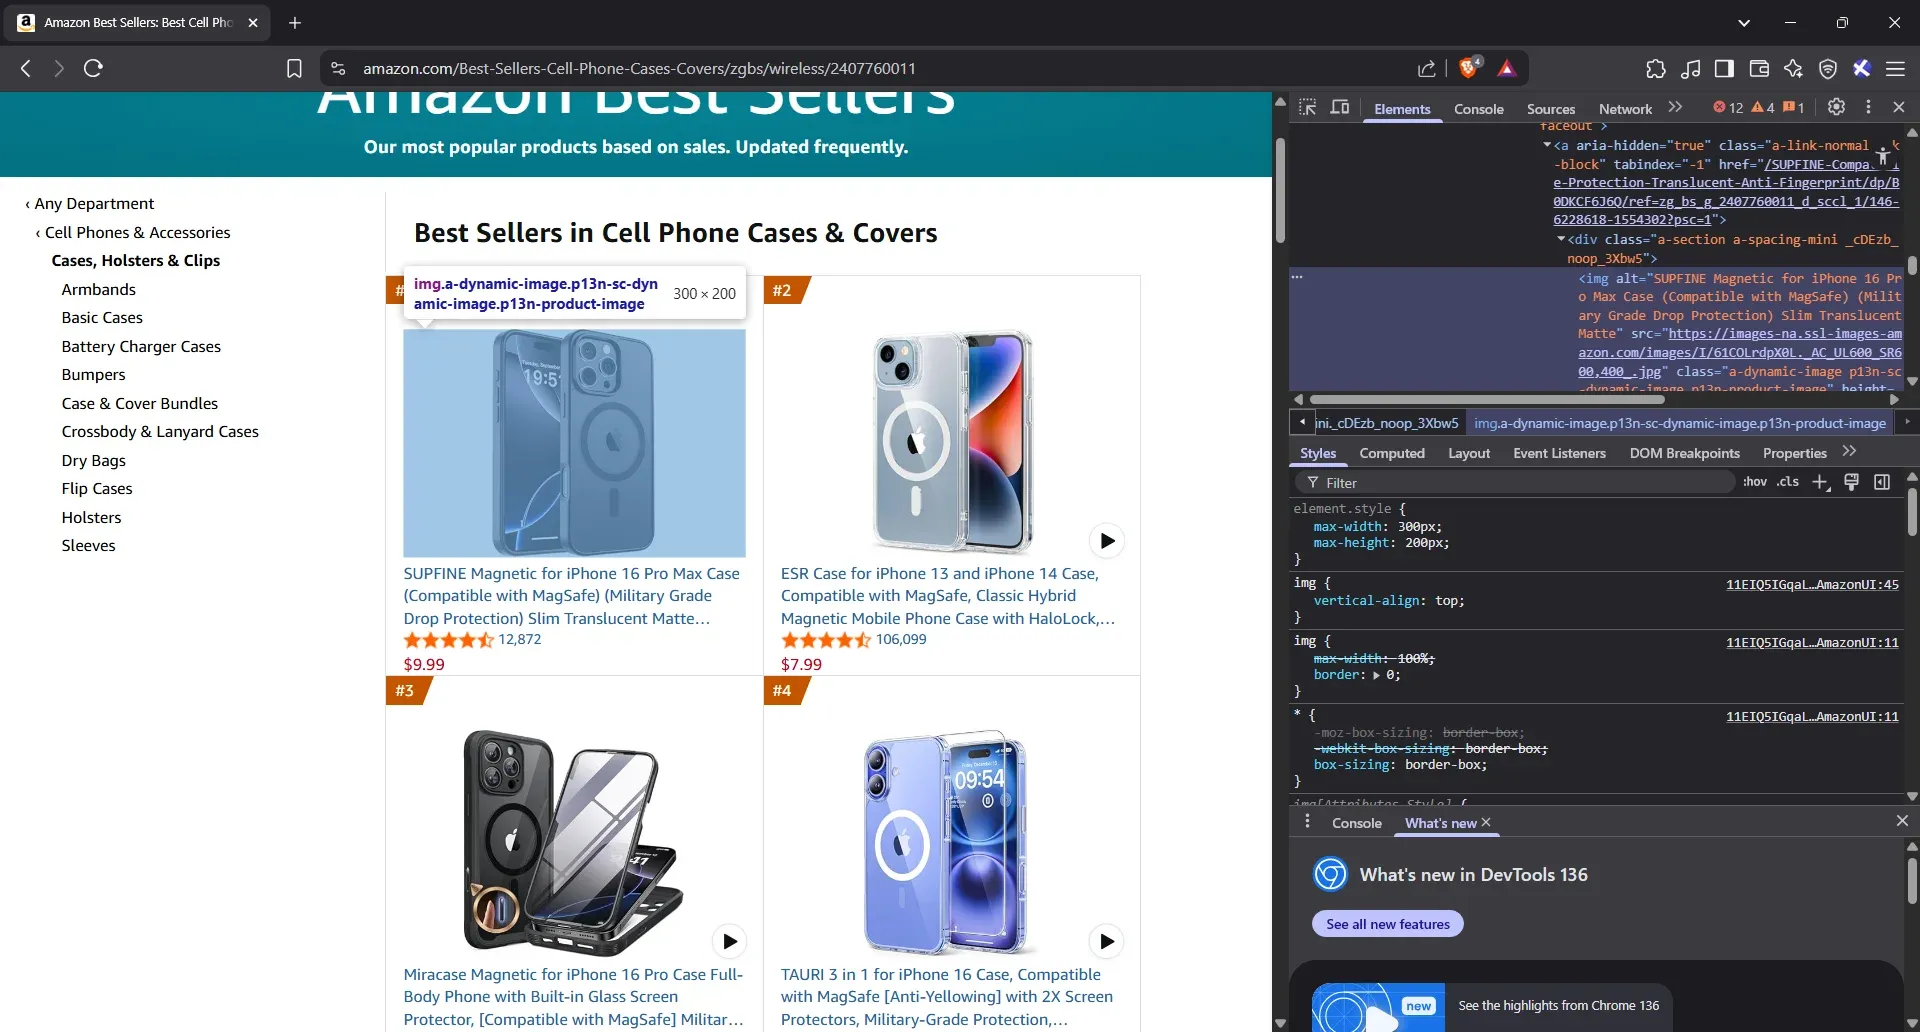
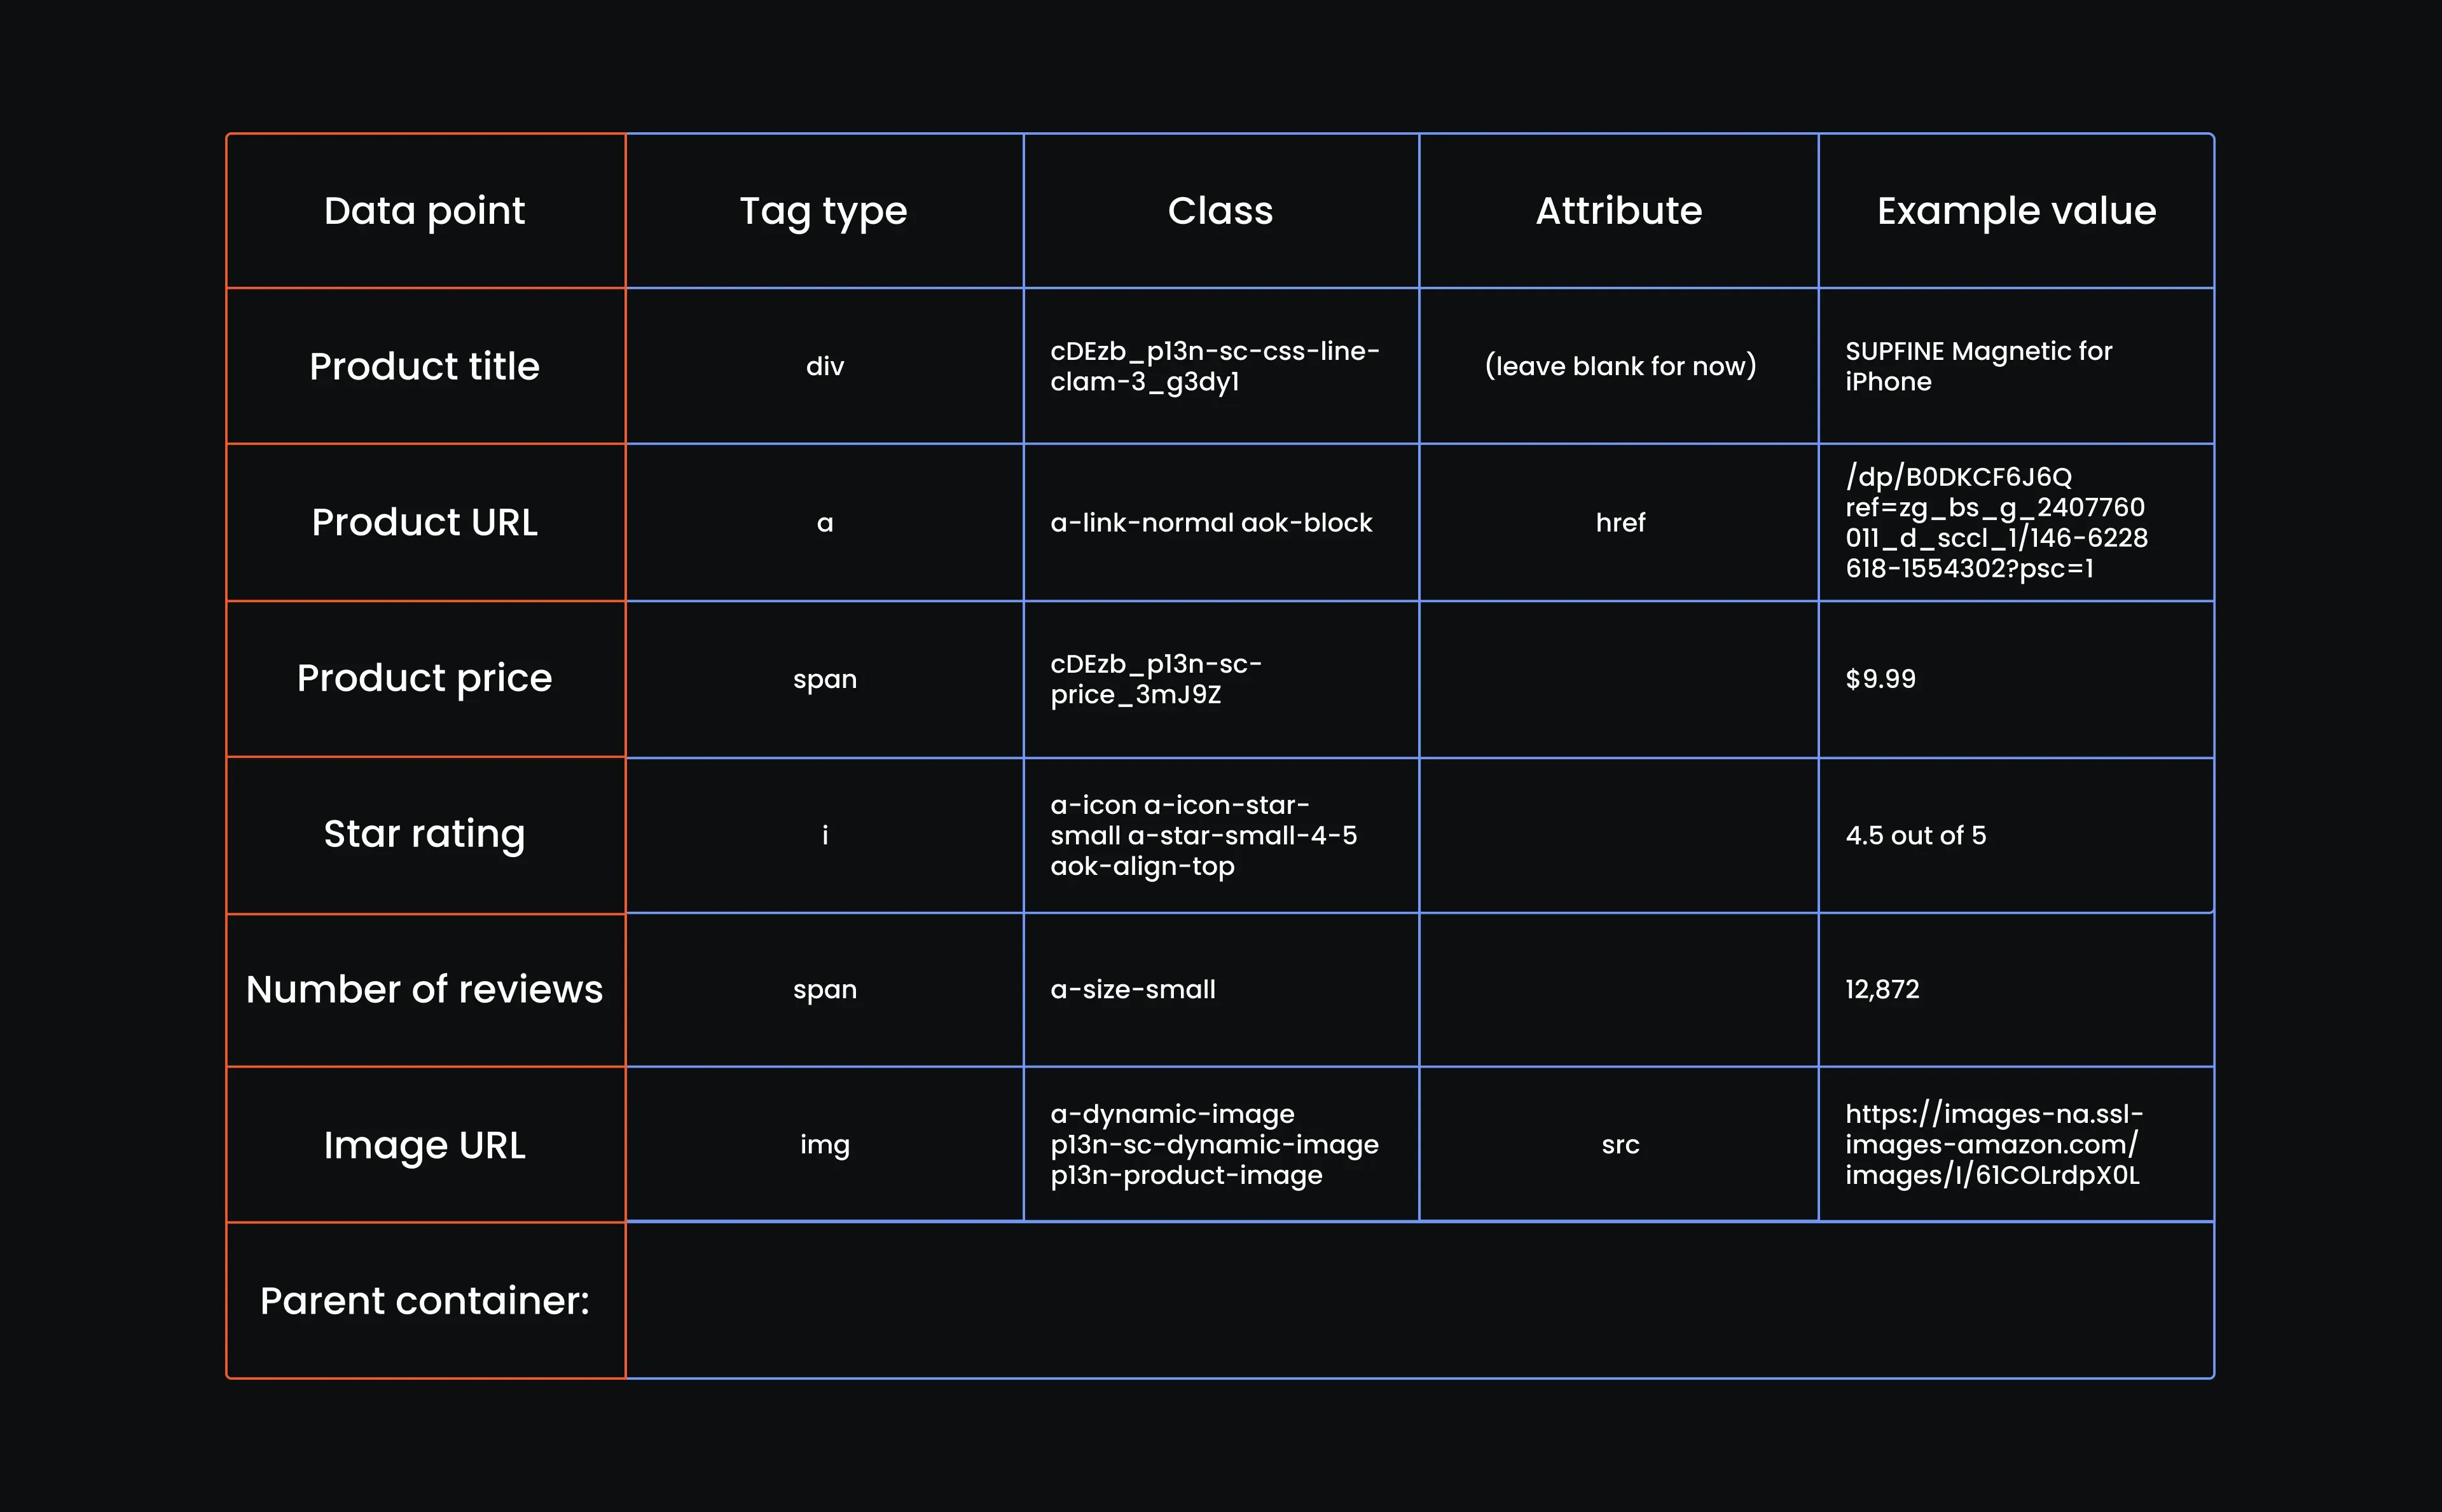
- 提取图片 URL 相关属性
当您悬停时图片高亮显示,就说明找到了目标。只需获取 img 标签,完整复制类名,并提取 src 属性,这就是商品图片。
- 找到父容器
我们已经接近真正开始抓取亚马逊手机壳畅销榜页面了,只差最后一件事。相信我们,这一步能帮您省去后续大量麻烦。
我们已经确定了标题、价格以及其他相关信息对应的标签,现在要做的是用一个巧妙的方法把这一切整合起来:找到承载整个商品列表的容器。
方法如下:回到亚马逊畅销榜页面,随便选一个商品(选哪个都无所谓),点击“检查”,HTML 代码会显示在侧边栏。接下来,开始沿着代码逐层往上悬停,您会看到列表中的各个部分被高亮,比如标题、图片和价格。
持续往上,直到整张商品卡片都高亮显示,这就是父容器。如果再往上悬停一层,发现其他商品也被一并包含进来,说明您已经找过头了,退回一层即可——那正是您要用来锚定整个抓取逻辑的目标元素。
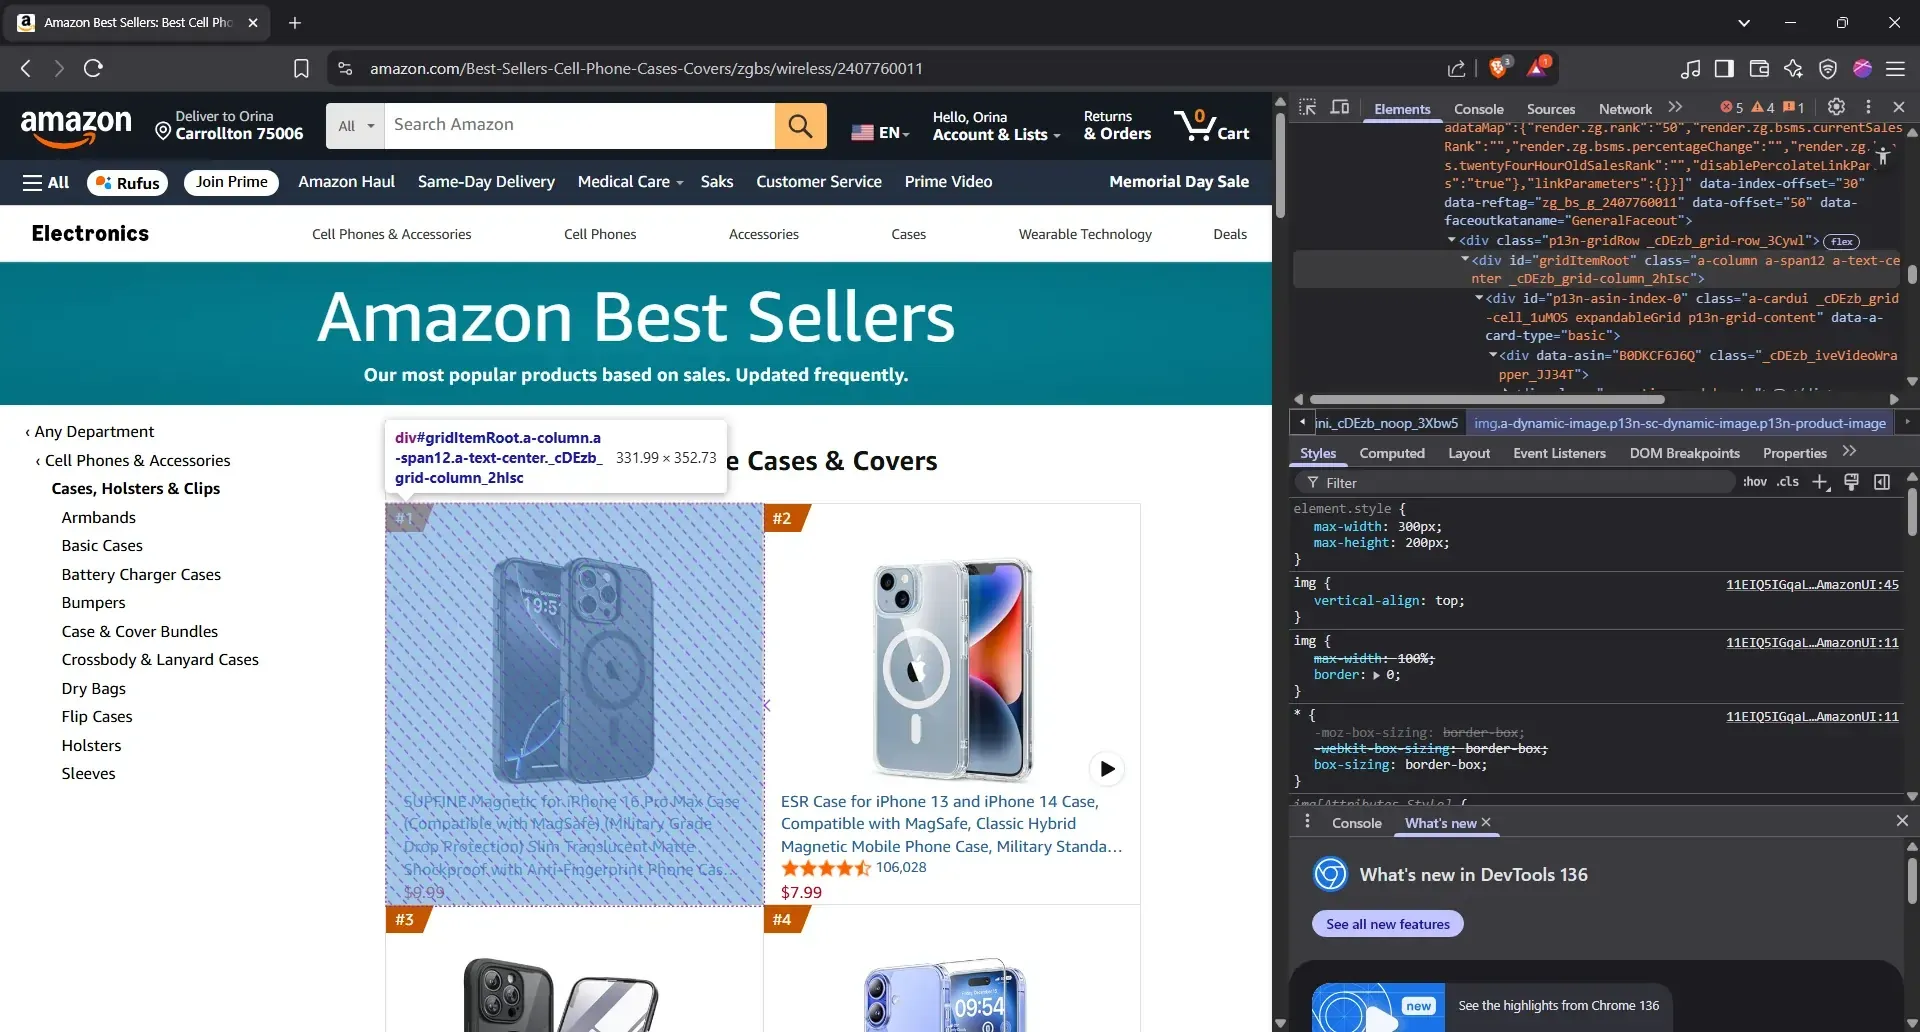
- 提取父容器
<div class="zg-grid-general-faceout">
现在我们可以填写完整的表格了:
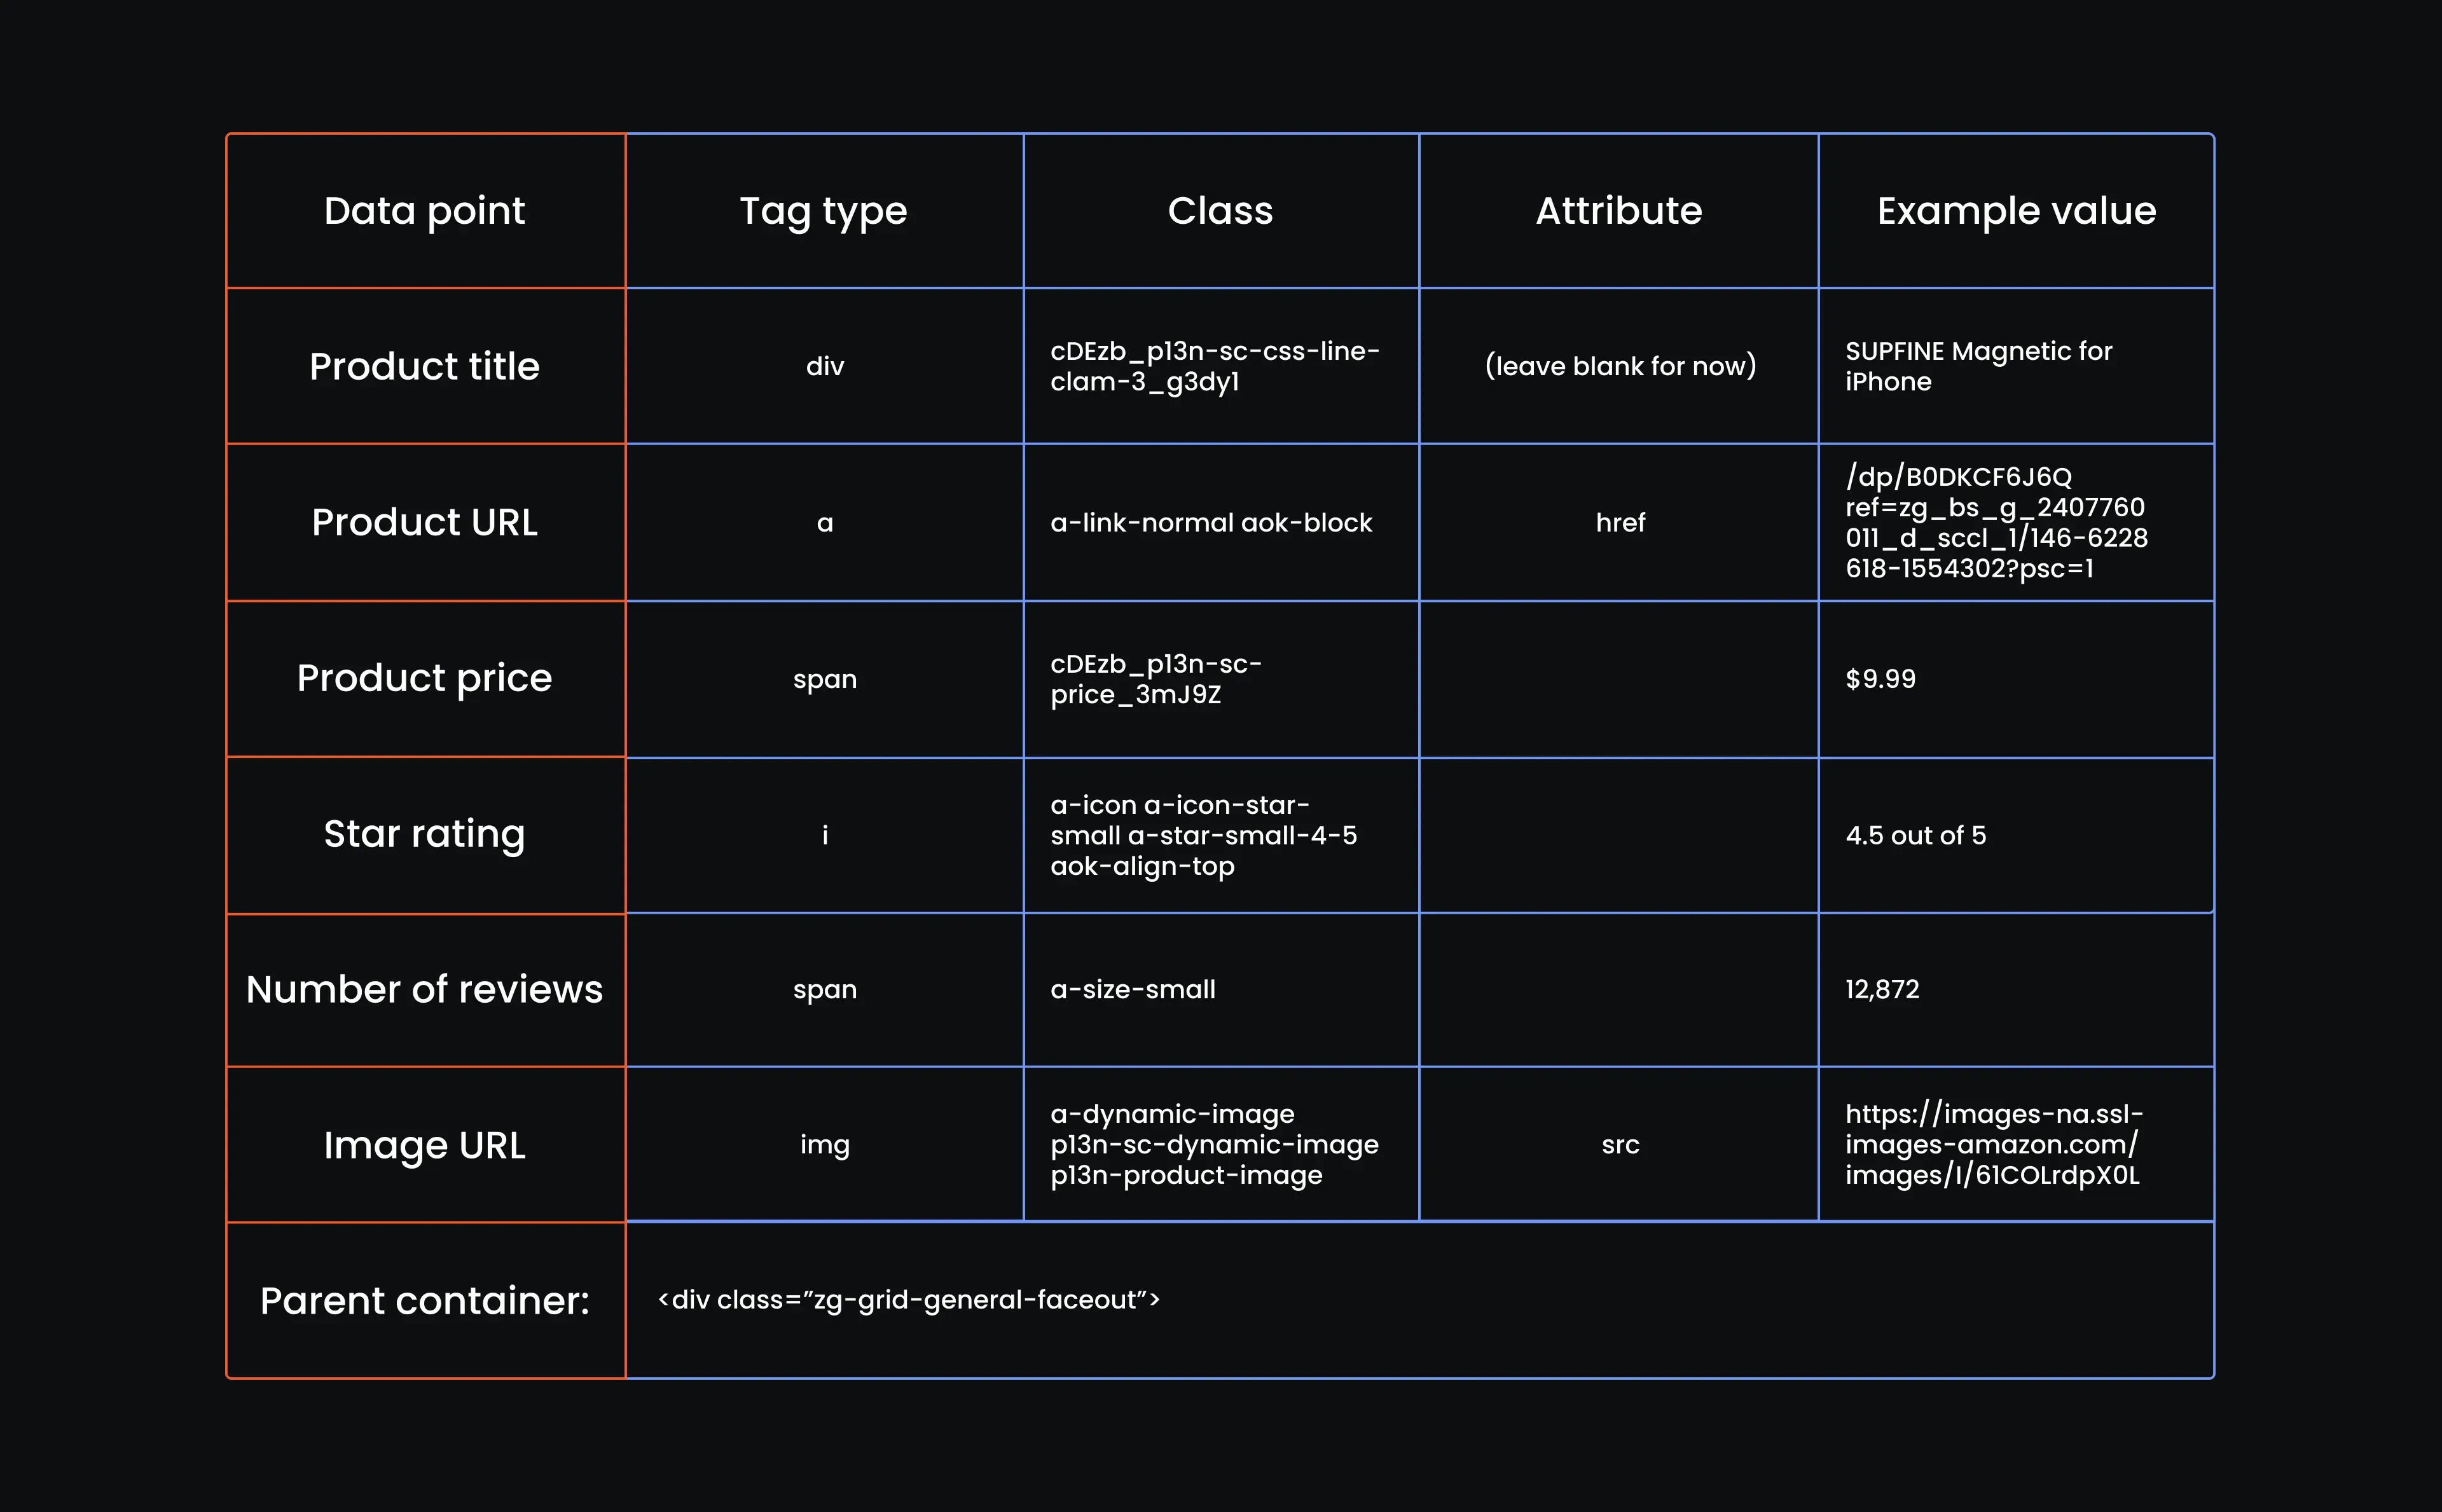
好了,我们已经梳理出所有元素,确定了它们对应的标签,并建好了参考表格。接下来呢?把这一切转化成真正能够逐行抓取亚马逊数据的代码。
第六步:定义请求头
还记得我们之前搭建的那个漫长的请求循环吗?它是其余所有内容的基础。每一次重试,都是一次绕过亚马逊防护机制的新尝试,这也是为什么我们要确保它会轮换 User-Agent、更换代理,并随机等待一段时间。现在,我们再为它增加一项优势:智能的动态请求头。
请求头就像是您访问一个网站时做的自我介绍:它告诉亚马逊您用的是什么浏览器、如何连接,以及您是从哪个页面过来的。如果这些信息不随每次请求变化,亚马逊就会察觉异常。因此,我们把请求头放进重试循环中——也就是轮换 User-Agent 和代理的那个循环,这样每个请求看起来都像是完全不同的访问者。
将脚本更新为如下内容(注意缩进):
# Session setup
session = requests.Session()

# Rules for retrying
retries = 3
delay = 10
success = False

# Main retry logic
while retries > 0 and not success:
    user_agent = ua.random
    proxies = random.choice(proxy_pool)

    # Add your headers at this point
    headers = {
        "User-Agent": user_agent,
        "Accept-Language": "en-US,en;q=0.9",
        "Accept-Encoding": "gzip, deflate, br",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
        "Connection": "keep-alive",
        "Upgrade-Insecure-Requests": "1",
        "Cache-Control": "no-cache",
        "Referer": random.choice([
            "https://www.google.com/",
            "https://www.bing.com/",
            "https://duckduckgo.com/"
        ]),
        "Sec-Fetch-Dest": "document",
        "Sec-Fetch-Mode": "navigate",
        "Sec-Fetch-Site": "none",
        "Sec-Fetch-User": "?1",
        "Sec-Ch-Ua": '"Chromium";v="118", "Not=A?Brand";v="99", "Google Chrome";v="118"',
        "Sec-Ch-Ua-Mobile": "?0",
        "Sec-Ch-Ua-Platform": '"Windows"'
    }

    print(f"Trying with User-Agent: {user_agent}")
    print(f"Using Proxy: {proxies['http']}")

    # Natural pause
    time.sleep(random.uniform(3, 8))

    # Our GET request
    try:
        response = session.get(
            "https://www.amazon.com/Best-Sellers-Cell-Phones-Accessories/zgbs/wireless/2407760011",
            headers=headers,
            proxies=proxies,
            timeout=20
        )

        print(f"Status Code: {response.status_code}")

        # Parse the HTML response
        soup = BeautifulSoup(response.content, "html.parser")
        product_cards = soup.find_all("div", attrs={"data-asin": True})

        # Block detection logic
        if (
            "captcha" in response.url or
            "api-services-support@amazon.com" in response.text or
            soup.find("form", action="/errors/validateCaptcha") or
            response.status_code != 200 or
            len(product_cards) == 0
        ):
            print("Blocked or failed. Retrying...")
            retries -= 1
            time.sleep(delay)
            delay *= 2
            continue

        # Success condition: If we got here, we passed Amazon's outer wall
        print("Success! Got a response that wasn't blocked.")
        success = True

    # Catching request errors and retrying with exponential backoff
    except Exception as e:
        print(f"Request failed: {e}. Retrying after {delay} seconds...")
        time.sleep(delay)
        retries -= 1
        delay *= 2
下面我们逐行拆解这段请求头,让您清楚了解每一部分的作用及其重要性:
- User-Agent 就是我们之前随机生成的浏览器标识。
- Accept-Language 用于告诉 Amazon 您偏好的语言,真实浏览器都会带上这个字段,所以我们也需要加上。
- Accept-Encoding 说明浏览器支持哪些压缩格式,也会影响内容加载速度。
- Accept 定义了脚本可以接受的内容类型,可以把它理解为一份“菜单”。
- Connection 设置为 keep-alive,用来模拟真实浏览器保持连接而非每次请求都重新连接的行为。
- Upgrade-Insecure-Requests 告诉 Amazon 您接受使用 HTTPS。
- Cache-Control 告诉 Amazon 我们需要的是最新页面。
- Referrer 伪装成我们是从 Google、Bing 或 DuckDuckGo 跳转过来的。
- 以 Sec- 开头的请求头基本上用于描述请求的上下文信息。
接下来,我们需要把这段代码加入脚本中,内容如下:
import requests
from bs4 import BeautifulSoup
from fake_useragent import UserAgent
import csv
import random
import time
print("Environment is ready. Scraping started.")
ua = UserAgent()
# Setup user agent generator
ua = UserAgent()
# Replace YOUR_USERNAME and YOUR_PASSWORD with your actual MarsProxies credentials.
# Keep the country, state/city, session, and lifetime values in the same format shown below.

# Proxy pool with 5 full proxy entries (each includes http and https)
proxy_pool = [
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443"
    }
]
#Start of your request logic
session = requests.Session()

# Rules for retrying
retries = 3
delay = 10
success = False

# Main retry logic
while retries > 0 and not success:
    user_agent = ua.random
    proxies = random.choice(proxy_pool)

    # Add your headers at this point
    headers = {
        "User-Agent": user_agent,
        "Accept-Language": "en-US,en;q=0.9",
        "Accept-Encoding": "gzip, deflate, br",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
        "Connection": "keep-alive",
        "Upgrade-Insecure-Requests": "1",
        "Cache-Control": "no-cache",
        "Referer": random.choice([
            "https://www.google.com/",
            "https://www.bing.com/",
            "https://duckduckgo.com/"
        ]),
        "Sec-Fetch-Dest": "document",
        "Sec-Fetch-Mode": "navigate",
        "Sec-Fetch-Site": "none",
        "Sec-Fetch-User": "?1",
        "Sec-Ch-Ua": '"Chromium";v="118", "Not=A?Brand";v="99", "Google Chrome";v="118"',
        "Sec-Ch-Ua-Mobile": "?0",
        "Sec-Ch-Ua-Platform": '"Windows"'
    }

    print(f"Trying with User-Agent: {user_agent}")
    print(f"Using Proxy: {proxies['http']}")

    # Natural pause
    time.sleep(random.uniform(3, 8))

    # Our GET request
    try:
        response = session.get(
            "https://www.amazon.com/Best-Sellers-Cell-Phones-Accessories/zgbs/wireless/2407760011",
            headers=headers,
            proxies=proxies,
            timeout=20
        )

        print(f"Status Code: {response.status_code}")

        # Parse the HTML response
        soup = BeautifulSoup(response.content, "html.parser")
        product_cards = soup.find_all("div", attrs={"data-asin": True})

        # Block detection logic
        if (
            "captcha" in response.url or
            "api-services-support@amazon.com" in response.text or
            soup.find("form", action="/errors/validateCaptcha") or
            response.status_code != 200 or
            len(product_cards) == 0
        ):
            print("Blocked or failed. Retrying...")
            retries -= 1
            time.sleep(delay)
            delay *= 2
            continue

        # Success condition: If we got here, we passed Amazon's outer wall
        print("Success! Got a response that wasn't blocked.")
        success = True

    # Catching request errors and retrying with exponential backoff
    except Exception as e:
        print(f"Request failed: {e}. Retrying after {delay} seconds...")
        time.sleep(delay)
        retries -= 1
        delay *= 2
第七步:从解析后的 HTML 中提取手机壳产品数据
目前为止,我们写的所有代码都是为了一个核心目的:在确认 Amazon 确实返回了真实内容之前,绝不继续往下执行。在考虑提取数据之前,以下条件必须全部满足:
- 请求发送成功
- 返回的不是 CAPTCHA 页面
- 状态码为 200
- 返回内容中没有出现兜底的客服邮箱
- product_cards 中确实包含元素(即 len(product_cards) > 0)
只有以上条件全部满足,才能让爬虫正式开始采集数据。这也是为什么产品提取循环既不放在脚本末尾,也不放在重试代码块之外,而是紧跟在这一行之后:
# If we got here, we passed Amazon's outer wall
print("Success! Got a response that wasn't blocked.")
success = True
这个条件确保 Amazon 返回的是合法页面(而非 CAPTCHA 或诱饵页面),并且 soup 中确实存在真实的产品区块。只有满足这一点,我们才会继续解析标题、价格、评分等所需数据。现在可以开始编写数据提取代码块了:
- 遍历每个产品卡片
下面开始遍历 product_cards,逐一提取产品详情,编写以下脚本:
# Success condition: If we got here, we passed Amazon's outer wall
print("Success! Got a response that wasn't blocked.")
success = True

#Your product extraction loop starts here
if response.status_code == 200 and len(product_cards) > 0:
    for idx, card in enumerate(product_cards, start=1):
这段代码开始遍历您之前通过 find_all 定位到的每个产品容器。
- 提取标题
回到参考表格,查看第一行,内容如下:
Tag type: div, class: cDEzb_p13n-sc-css-line-clamp-3_g3dy1
下面是如何将其转换成 Python 文件能够识别的代码:
title_tag = card.find("div", class_=lambda c: c and "line-clamp" in c)
product_title = title_tag.get_text(strip=True) if title_tag else None
您可能会好奇,为什么不直接使用参考表格中完整的 class 字符串?因为 Amazon 的前端代码变化非常频繁,class 名称会被重新生成、混淆,甚至拆分。但关键字 "line-clamp" 始终保持不变。因此,与其依赖容易失效的精确匹配,不如采用更灵活的方式。lambda c: 这部分的意思其实是:“只要 class 存在并且包含 'line-clamp',就提取它。”
- 提取 URL
接下来看参考表格的第二行:手机壳的 URL。
您需要查找的是:
- 标签:a
- Class:a-link-normal aok-block
- 属性:href
现在把它转换成 Python 代码:
link_tag = card.find("a", class_="a-link-normal aok-block")
product_url = f"https://www.amazon.com{link_tag['href']}" if link_tag and 'href' in link_tag.attrs else None
我们来逐步拆解:
- 我们在告诉 BeautifulSoup:“在这张卡片内部查找带有该 class 的 <a> 标签。”
- 然后检查:它是否真的包含 href 属性?
- 如果有,很好,我们在前面加上 https://www.amazon.com 即可完成
- 如果没有,就返回 None,脚本继续稳定运行
- 提取产品价格
接下来要提取的是产品价格,回到表格的第三行。
您需要关注的是:
- 标签:span
- Class:cDEzb_p13n-sc-price_3mJ9Z
用代码实现如下:
price_tag = card.find("span", class_=lambda c: c and "price" in c)
product_price = price_tag.get_text(strip=True) if price_tag else None
具体含义如下:
- .find() 只定位第一个匹配的标签
- .get_text(strip=True) 用于提取价格,并去除多余的空格和换行
- 如果没有找到价格(例如遇到赞助商品或其他特殊情况),else None 可以防止脚本出错崩溃
- 提取星级评分
根据表格:
- 标签:i
- Class:a-icon a-icon-star-small a-star-small-4-5 aok-align-top
代码如下:
star_tag = card.find("i", class_=lambda c: c and "star" in c)
star_rating = star_tag.get_text(strip=True) if star_tag else None
这段代码的作用如下:
- .find() 在当前产品区块内查找该 <i> 标签
- .get_text(strip=True) 用于提取实际星级评分,并去除多余的空白字符
- if ... else None 这部分确保即使没有评分,脚本也不会报错,而是直接继续执行
- 提取评论数量
接下来获取评论数量,对应参考表格的第五行。这里要定位的是一个简单的 <span> 标签,class 为 a-size-small,不需要处理任何属性。
下面把它转换成代码:
reviews_tag = card.find("span", class_="a-size-small")
number_of_reviews = reviews_tag.get_text(strip=True) if reviews_tag else None
具体过程如下:
- find() 会在每张产品卡片内查找该 class 对应的 <span> 标签
- get_text(strip=True) 用于提取评论数量,并去除多余的空格和换行
- if ... else None 只是一个兜底机制,避免某张卡片没有评论时导致脚本崩溃
- 提取图片 URL
现在来看第六行:
- 标签:img
- Class:a-dynamic-image p13n-sc-dynamic-image p13n-product-image
- 属性:src
代码如下:
image_tag = card.find("img", class_=lambda c: c and "image" in c)
image_url = image_tag["src"] if image_tag and "src" in image_tag.attrs else None
具体含义如下:
- .find() 将搜索范围限定在每个产品列表中的目标图片标签
- ["src"] 直接获取图片 URL
- if image_tag else None 可以确保 Python 文件稳定运行、不会崩溃
- 存储所有已提取的数据
所有数据都已提取完成,现在把它们打包整理。在循环内部继续添加以下代码:
product_data = [product_title, product_url, product_price, star_rating, number_of_reviews, image_url]
具体过程如下:
- 将刚刚抓取到的该产品所有数据归为一组
- 每个字段都按固定顺序排列,便于后续写入 CSV 文件
- 如果某项数据缺失(例如某产品没有评分),之前设置的 None 会占据该位置
- 完整代码块
至此,数据提取逻辑已经完成,完整代码块如下:
# Success condition: If we got here, we passed Amazon's outer wall
print("Success! Got a response that wasn't blocked.")
success = True

# Product extraction loop starts here
if response.status_code == 200 and len(product_cards) > 0:
    for idx, card in enumerate(product_cards, start=1):
        title_tag = card.find("div", class_=lambda c: c and "line-clamp" in c)
        product_title = title_tag.get_text(strip=True) if title_tag else None

        link_tag = card.find("a", class_="a-link-normal aok-block")
        product_url = f"https://www.amazon.com{link_tag['href']}" if link_tag and "href" in link_tag.attrs else None

        price_tag = card.find("span", class_=lambda c: c and "price" in c)
        product_price = price_tag.get_text(strip=True) if price_tag else None

        star_tag = card.find("i", class_=lambda c: c and "star" in c)
        star_rating = star_tag.get_text(strip=True) if star_tag else None

        reviews_tag = card.find("span", class_="a-size-small")
        number_of_reviews = reviews_tag.get_text(strip=True) if reviews_tag else None

        image_tag = card.find("img", class_=lambda c: c and "image" in c)
        image_url = image_tag["src"] if image_tag and "src" in image_tag.attrs else None

        product_data = [
            product_title,
            product_url,
            product_price,
            star_rating,
            number_of_reviews,
            image_url
        ]

        print(f"Extracted product {idx}: {product_title[:50] if product_title else '[No Title]'}")
我们来回顾一下目前为止的代码:
import requests
from bs4 import BeautifulSoup
from fake_useragent import UserAgent
import csv
import random
import time

print("Environment is ready. Scraping started.")

ua = UserAgent()

# Replace YOUR_USERNAME and YOUR_PASSWORD with your actual MarsProxies credentials.
# Keep the country, state/city, session, and lifetime values in the same format shown below.

# Proxy pool with 5 full proxy entries (each includes http and https)
proxy_pool = [
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443"
    }
]

# Session setup
session = requests.Session()

# Rules for retrying
retries = 3
delay = 10
success = False

# Main retry logic
while retries > 0 and not success:
    user_agent = ua.random
    proxies = random.choice(proxy_pool)

    # Add your headers at this point
    headers = {
        "User-Agent": user_agent,
        "Accept-Language": "en-US,en;q=0.9",
        "Accept-Encoding": "gzip, deflate, br",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
        "Connection": "keep-alive",
        "Upgrade-Insecure-Requests": "1",
        "Cache-Control": "no-cache",
        "Referer": random.choice([
            "https://www.google.com/",
            "https://www.bing.com/",
            "https://duckduckgo.com/"
        ]),
        "Sec-Fetch-Dest": "document",
        "Sec-Fetch-Mode": "navigate",
        "Sec-Fetch-Site": "none",
        "Sec-Fetch-User": "?1",
        "Sec-Ch-Ua": '"Chromium";v="118", "Not=A?Brand";v="99", "Google Chrome";v="118"',
        "Sec-Ch-Ua-Mobile": "?0",
        "Sec-Ch-Ua-Platform": '"Windows"'
    }

    print(f"Trying with User-Agent: {user_agent}")
    print(f"Using Proxy: {proxies['http']}")

    # Natural pause
    time.sleep(random.uniform(3, 8))

    # Our GET request
    try:
        response = session.get(
            "https://www.amazon.com/Best-Sellers-Cell-Phones-Accessories/zgbs/wireless/2407760011",
            headers=headers,
            proxies=proxies,
            timeout=20
        )

        print(f"Status Code: {response.status_code}")

        # Parse the HTML response
        soup = BeautifulSoup(response.content, "html.parser")
        product_cards = soup.find_all("div", attrs={"data-asin": True})

        # Block detection logic
        if (
            "captcha" in response.url or
            "api-services-support@amazon.com" in response.text or
            soup.find("form", action="/errors/validateCaptcha") or
            response.status_code != 200 or
            len(product_cards) == 0
        ):
            print("Blocked or failed. Retrying...")
            retries -= 1
            time.sleep(delay)
            delay *= 2
            continue

        # Success condition: If we got here, we passed Amazon's outer wall
        print("Success! Got a response that wasn't blocked.")
        success = True

        # Product extraction loop starts here
        if response.status_code == 200 and len(product_cards) > 0:
            for idx, card in enumerate(product_cards, start=1):
                title_tag = card.find("div", class_=lambda c: c and "line-clamp" in c)
                product_title = title_tag.get_text(strip=True) if title_tag else None

                link_tag = card.find("a", class_="a-link-normal aok-block")
                product_url = f"https://www.amazon.com{link_tag['href']}" if link_tag and "href" in link_tag.attrs else None

                price_tag = card.find("span", class_=lambda c: c and "price" in c)
                product_price = price_tag.get_text(strip=True) if price_tag else None

                star_tag = card.find("i", class_=lambda c: c and "star" in c)
                star_rating = star_tag.get_text(strip=True) if star_tag else None

                reviews_tag = card.find("span", class_="a-size-small")
                number_of_reviews = reviews_tag.get_text(strip=True) if reviews_tag else None

                image_tag = card.find("img", class_=lambda c: c and "image" in c)
                image_url = image_tag["src"] if image_tag and "src" in image_tag.attrs else None

                product_data = [
                    product_title,
                    product_url,
                    product_price,
                    star_rating,
                    number_of_reviews,
                    image_url
                ]

                print(f"Extracted product {idx}: {product_title[:50] if product_title else '[No Title]'}")

    # Catching request errors and retrying with exponential backoff
    except Exception as e:
        print(f"Request failed: {e}. Retrying after {delay} seconds...")
        time.sleep(delay)
        retries -= 1
        delay *= 2
到目前为止,我们已经写出了一个能抓取并解析首批 Amazon 产品信息的爬虫脚本,这是一个不错的开始。但这只是一轮、一个页面,是完整数据集中的一个快照而已。
我们希望做得更深入:加入分页功能,并在抓取过程中把每一条数据实时保存到 CSV 文件中。接下来的内容会把这个爬虫打造成一个真正实用的工具,能够从多个 Amazon 手机壳畅销榜页面中提取产品详情,并将其静默记录到文件中供后续使用。
下面开始实现:首先添加分页逻辑。
第八步:添加分页逻辑
每个 Amazon 手机壳畅销榜页面大约展示 30 款产品。我们希望获取 60 款,因此需要抓取第 1 页和第 2 页。但很多人忽略了一点:第 2 页的防护程度与第 1 页相当,有时甚至更高。这正是分页逻辑不能放在最后的原因。
相反,它应该包裹在整个重试代码块之外。每次加载一个页面,都应将其视为一次独立完整的抓取任务。放置位置如下:
# Start of your request logic
session = requests.Session()
添加以下代码块:
# Paginate through first two pages
for page in range(1, 3):  # Scrape pages 1 to 2
    retries = 3
    delay = 10
    success = False

    # Same code continues
    while retries > 0 and not success:
如果第 1 页失败,就重试第 1 页;如果第 2 页失败,就重试第 2 页。逻辑简单清晰,在抓取 Amazon 时也更加可靠。
此外,还需要在定义请求头之后立即添加以下代码块:
url = f"https://www.amazon.com/Best-Sellers-Cell-Phones-Accessories/zgbs/wireless/2407760011?pg={page}"
print(f"\nScraping Page {page}")
print(f"Trying with User-Agent: {user_agent}")
print(f"Using Proxy: {proxies['http']}")
此时您的代码块应如下所示:
session = requests.Session()

for page in range(1, 3):
    retries = 3
    delay = 10
    success = False

    while retries > 0 and not success:
        user_agent = ua.random
        proxies = random.choice(proxy_pool)

        headers = {
            "User-Agent": user_agent,
            ...
        }

        url = f"https://www.amazon.com/Best-Sellers-Cell-Phones-Accessories/zgbs/wireless/2407760011?pg={page}"
        print(f"\nScraping Page {page}")
        print(f"Trying with User-Agent: {user_agent}")
        print(f"Using Proxy: {proxies['http']}")
由于我们是在遍历 Amazon 畅销榜的分页,因此每次循环都需要更新 URL,以反映当前请求的具体页面。这正是 url = f"...?pg={page}" 的作用——它会动态填入分页循环中的当前页码。
我们还会记录页码、所选的身份字符串以及正在使用的代理。这些打印语句能大大简化调试工作,尤其是在出现问题或需要追踪失败请求规律时。
因此,请将这段代码放在请求头之后、发送 GET 请求之前。这样,抓取循环的每一次迭代都能知道应该抓取哪一页。
以下是加入分页逻辑后的脚本:
import requests
from bs4 import BeautifulSoup
from fake_useragent import UserAgent
import csv
import random
import time

print("Environment is ready. Scraping started.")

# Setup user agent generator
ua = UserAgent()

# Replace YOUR_USERNAME and YOUR_PASSWORD with your actual MarsProxies credentials.
# Keep the country, state/city, session, and lifetime values in the same format shown below.

# Proxy pool with 5 full proxy entries (each includes http and https)
proxy_pool = [
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443"
    }
]

# Session setup
session = requests.Session()

# Paginate through first two pages
for page in range(1, 3):  # Scrape pages 1 to 2
    retries = 3
    delay = 10
    success = False

    # Main request retry logic
    while retries > 0 and not success:
        user_agent = ua.random
        proxies = random.choice(proxy_pool)

        # Dynamic headers
        headers = {
            "User-Agent": user_agent,
            "Accept-Language": "en-US,en;q=0.9",
            "Accept-Encoding": "gzip, deflate, br",
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
            "Connection": "keep-alive",
            "Upgrade-Insecure-Requests": "1",
            "Cache-Control": "no-cache",
            "Referer": random.choice([
                "https://www.google.com/",
                "https://www.bing.com/",
                "https://duckduckgo.com/"
            ]),
            "Sec-Fetch-Dest": "document",
            "Sec-Fetch-Mode": "navigate",
            "Sec-Fetch-Site": "none",
            "Sec-Fetch-User": "?1",
            "Sec-Ch-Ua": '"Chromium";v="118", "Not=A?Brand";v="99", "Google Chrome";v="118"',
            "Sec-Ch-Ua-Mobile": "?0",
            "Sec-Ch-Ua-Platform": '"Windows"'
        }

        # Page-specific URL
        url = f"https://www.amazon.com/Best-Sellers-Cell-Phones-Accessories/zgbs/wireless/2407760011?pg={page}"

        print(f"\nScraping Page {page}")
        print(f"Trying with User-Agent: {user_agent}")
        print(f"Using Proxy: {proxies['http']}")

        # Natural pause
        time.sleep(random.uniform(3, 8))

        # Sending the GET request
        try:
            response = session.get(
                url,
                headers=headers,
                proxies=proxies,
                timeout=20
            )

            print(f"Status Code: {response.status_code}")

            # Parse the HTML response
            soup = BeautifulSoup(response.content, "html.parser")
            product_cards = soup.find_all("div", attrs={"data-asin": True})

            # Block detection logic
            if (
                "captcha" in response.url or
                "api-services-support@amazon.com" in response.text or
                soup.find("form", action="/errors/validateCaptcha") or
                response.status_code != 200 or
                len(product_cards) == 0
            ):
                print("Blocked or failed. Retrying...")
                retries -= 1
                time.sleep(delay)
                delay *= 2
                continue

            # Success condition
            print("Success! Got a response that wasn't blocked.")
            success = True

            # Product extraction loop starts here
            if response.status_code == 200 and len(product_cards) > 0:
                for idx, card in enumerate(product_cards, start=1):
                    title_tag = card.find("div", class_=lambda c: c and "line-clamp" in c)
                    product_title = title_tag.get_text(strip=True) if title_tag else None

                    link_tag = card.find("a", class_="a-link-normal aok-block")
                    product_url = f"https://www.amazon.com{link_tag['href']}" if link_tag and "href" in link_tag.attrs else None

                    price_tag = card.find("span", class_=lambda c: c and "price" in c)
                    product_price = price_tag.get_text(strip=True) if price_tag else None

                    star_tag = card.find("i", class_=lambda c: c and "star" in c)
                    star_rating = star_tag.get_text(strip=True) if star_tag else None

                    reviews_tag = card.find("span", class_="a-size-small")
                    number_of_reviews = reviews_tag.get_text(strip=True) if reviews_tag else None

                    image_tag = card.find("img", class_=lambda c: c and "image" in c)
                    image_url = image_tag["src"] if image_tag and "src" in image_tag.attrs else None

                    product_data = [
                        product_title,
                        product_url,
                        product_price,
                        star_rating,
                        number_of_reviews,
                        image_url
                    ]

                    print(f"Extracted product {idx}: {product_title[:50] if product_title else '[No Title]'}")

        # Catch request errors and retry with exponential backoff
        except Exception as e:
            print(f"Request failed: {e}. Retrying after {delay} seconds...")
            time.sleep(delay)
            retries -= 1
            delay *= 2
第九步:将解析后的数据保存到 CSV 文件
现在该把数据写入 CSV 文件了。但我们不希望每翻一页、每次重试或每次更换代理时都重新打开和关闭文件,这样很容易出错或丢失数据。因此,我们在一开始就打开一次 CSV 文件,并将所有抓取逻辑都包裹在其中,让整个过程都在同一个写入会话内完成。
请在请求脚本开头添加以下代码:
# CSV setup
csv_path = "amazon_products.csv"

with open("amazon_products.csv", mode="w", newline="", encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerow(["Title", "URL", "Price", "Rating", "Reviews", "Image"])

    # the code above opens the CSV file before you send the requests
    session = requests.Session()

    for page in range(1, 3):  # Scrape pages 1 to 2
        retries = 3
        delay = 10
        success = False

        while retries > 0 and not success:
            # same code continues
- csv_path = "amazon_products.csv" 将 CSV 文件名存储为一个变量(csv_path)
- with open(...) as file 会打开一次 CSV 文件,并在结束后自动关闭
- writer.writerow([...]) 用于写入表头,避免 CSV 文件成为一堆没有标签的数据
所有 Amazon 抓取操作都在 with 代码块内完成,这意味着每个产品一经抓取就会立即写入文件。
第十步:完整代码
现在,您的最终脚本已经可以用来抓取 Amazon 数据了:
import requests
from bs4 import BeautifulSoup
from fake_useragent import UserAgent
import csv
import random
import time

print("Environment is ready. Scraping started.")

# Setup user agent generator
ua = UserAgent()

# Replace YOUR_USERNAME and YOUR_PASSWORD with your actual MarsProxies credentials.
# Keep the country, state/city, session, and lifetime values in the same format shown below.

# Proxy pool with 5 full proxy entries (each includes http and https)
proxy_pool = [
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-no_city-oslo_session-abc123_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-us_state-connecticut_session-def456_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-gb_city-auckley_session-ghi789_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-za_city-bloemfontein_session-jkl012_lifetime-20m@ultra.marsproxies.com:44443"
    },
    {
        "http": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443",
        "https": "http://YOUR_USERNAME:YOUR_PASSWORD_country-fr_city-avignon_session-mno345_lifetime-20m@ultra.marsproxies.com:44443"
    }
]

# CSV setup
csv_path = "amazon_products.csv"

with open(csv_path, mode="w", newline="", encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerow(["Title", "URL", "Price", "Rating", "Reviews", "Image"])

    # Session setup
    session = requests.Session()

    # Paginate through first two pages
    for page in range(1, 3):  # Scrape pages 1 to 2
        retries = 3
        delay = 10
        success = False

        # Main request retry logic
        while retries > 0 and not success:
            user_agent = ua.random
            proxies = random.choice(proxy_pool)

            # Dynamic headers
            headers = {
                "User-Agent": user_agent,
                "Accept-Language": "en-US,en;q=0.9",
                "Accept-Encoding": "gzip, deflate, br",
                "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
                "Connection": "keep-alive",
                "Upgrade-Insecure-Requests": "1",
                "Cache-Control": "no-cache",
                "Referer": random.choice([
                    "https://www.google.com/",
                    "https://www.bing.com/",
                    "https://duckduckgo.com/"
                ]),
                "Sec-Fetch-Dest": "document",
                "Sec-Fetch-Mode": "navigate",
                "Sec-Fetch-Site": "none",
                "Sec-Fetch-User": "?1",
                "Sec-Ch-Ua": '"Chromium";v="118", "Not=A?Brand";v="99", "Google Chrome";v="118"',
                "Sec-Ch-Ua-Mobile": "?0",
                "Sec-Ch-Ua-Platform": '"Windows"'
            }

            # Page-specific URL
            url = f"https://www.amazon.com/Best-Sellers-Cell-Phones-Accessories/zgbs/wireless/2407760011?pg={page}"

            print(f"\nScraping Page {page}")
            print(f"Trying with User-Agent: {user_agent}")
            print(f"Using Proxy: {proxies['http']}")

            # Natural pause
            time.sleep(random.uniform(3, 8))

            # Sending the GET request
            try:
                response = session.get(
                    url,
                    headers=headers,
                    proxies=proxies,
                    timeout=20
                )

                print(f"Status Code: {response.status_code}")

                # Parse the HTML response
                soup = BeautifulSoup(response.content, "html.parser")
                product_cards = soup.find_all("div", attrs={"data-asin": True})

                # Block detection logic
                if (
                    "captcha" in response.url or
                    "api-services-support@amazon.com" in response.text or
                    soup.find("form", action="/errors/validateCaptcha") or
                    response.status_code != 200 or
                    len(product_cards) == 0
                ):
                    print("Blocked or failed. Retrying...")
                    retries -= 1
                    time.sleep(delay)
                    delay *= 2
                    continue

                # Success condition
                print("Success! Got a response that wasn't blocked.")
                success = True

                # Product extraction loop starts here
                if response.status_code == 200 and len(product_cards) > 0:
                    for idx, card in enumerate(product_cards, start=1):
                        title_tag = card.find("div", class_=lambda c: c and "line-clamp" in c)
                        product_title = title_tag.get_text(strip=True) if title_tag else None

                        link_tag = card.find("a", class_="a-link-normal aok-block")
                        product_url = f"https://www.amazon.com{link_tag['href']}" if link_tag and "href" in link_tag.attrs else None

                        price_tag = card.find("span", class_=lambda c: c and "price" in c)
                        product_price = price_tag.get_text(strip=True) if price_tag else None

                        star_tag = card.find("i", class_=lambda c: c and "star" in c)
                        star_rating = star_tag.get_text(strip=True) if star_tag else None

                        reviews_tag = card.find("span", class_="a-size-small")
                        number_of_reviews = reviews_tag.get_text(strip=True) if reviews_tag else None

                        image_tag = card.find("img", class_=lambda c: c and "image" in c)
                        image_url = image_tag["src"] if image_tag and "src" in image_tag.attrs else None

                        product_data = [
                            product_title,
                            product_url,
                            product_price,
                            star_rating,
                            number_of_reviews,
                            image_url
                        ]

                        writer.writerow(product_data)
                        print(f"Wrote product {idx}: {product_title[:50] if product_title else '[No Title]'}")

            # Catch request errors and retry with exponential backoff
            except Exception as e:
                print(f"Request failed: {e}. Retrying after {delay} seconds...")
                time.sleep(delay)
                retries -= 1
                delay *= 2

print("Scraping complete. Data saved to amazon_products.csv")
第十一步:运行完成的 Amazon 爬虫
代码已经写好,代理已经准备就绪,逻辑也已经搭建完成。现在是时候看看它究竟能返回什么了。回到终端,确认当前仍处于保存脚本的文件夹内,然后输入:
python final_amazon_scraper.py
按下回车键并耐心等待,稍微花点时间也属正常。爬虫会轮换 User-Agent、切换代理、检测 CAPTCHA,并逐页处理 Amazon 页面,请给它一点时间。
运行完成了吗?我们来解读一下输出结果。
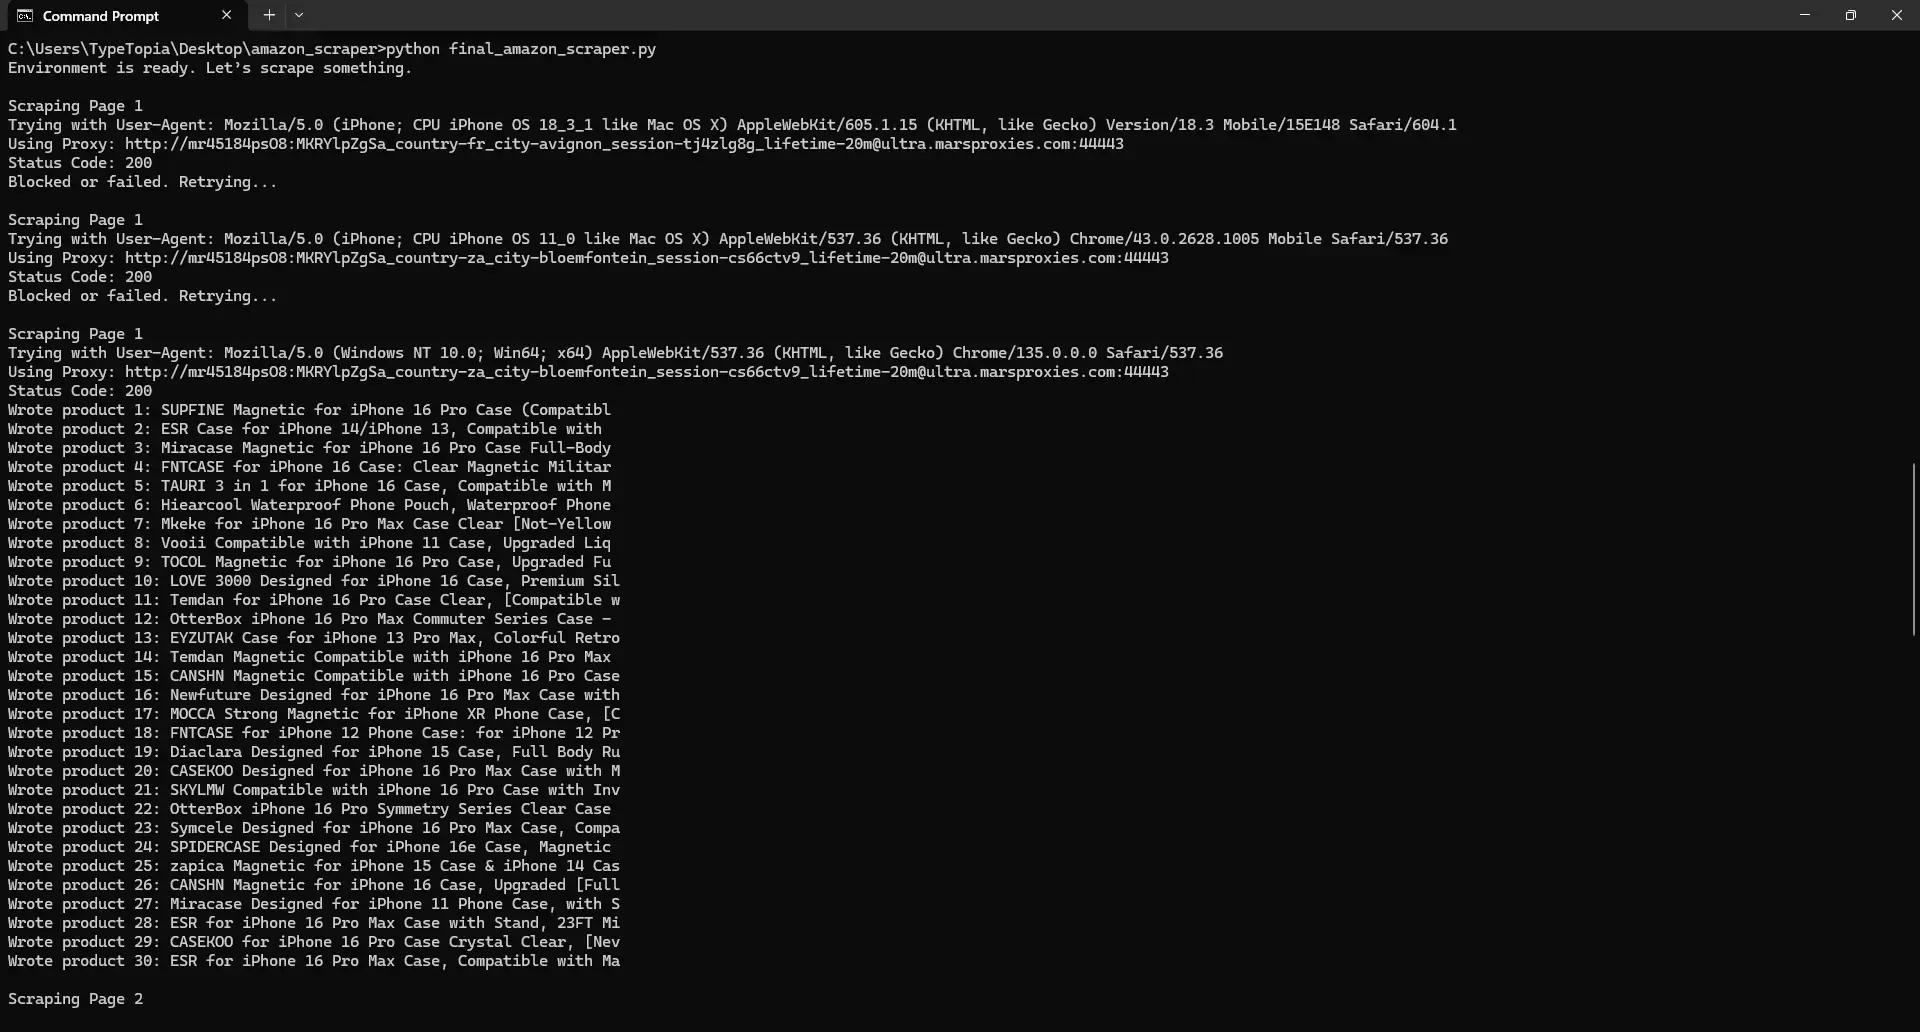
先看第一张截图,一切都按预期启动。接着,Amazon 爬虫对第 1 页发起了第一次请求,Amazon 返回了 200 OK,看起来像是成功了……但实际并非如此。您拿到的其实是一个诱饵页面,没有真实数据,很可能是 CAPTCHA 或占位 HTML。
幸运的是,封锁检测逻辑立刻发现了问题,没有浪费任何解析资源。脚本随即退避,等待 10 秒,切换到新的 IP 地址、全新的 User-Agent 和请求头,然后重新尝试。
第二次尝试呢?情况一样,又是一个虚假页面。但到了第三次,一切终于顺利:脚本成功突破 Amazon 的外层防护,识别出真实的产品容器,并提取了该页面全部 30 件商品。您甚至能看到每个产品在写入 CSV 文件时被实时记录下来,这就是一个稳健可靠的爬虫。
得益于分页循环,接下来我们继续抓取第 2 页。
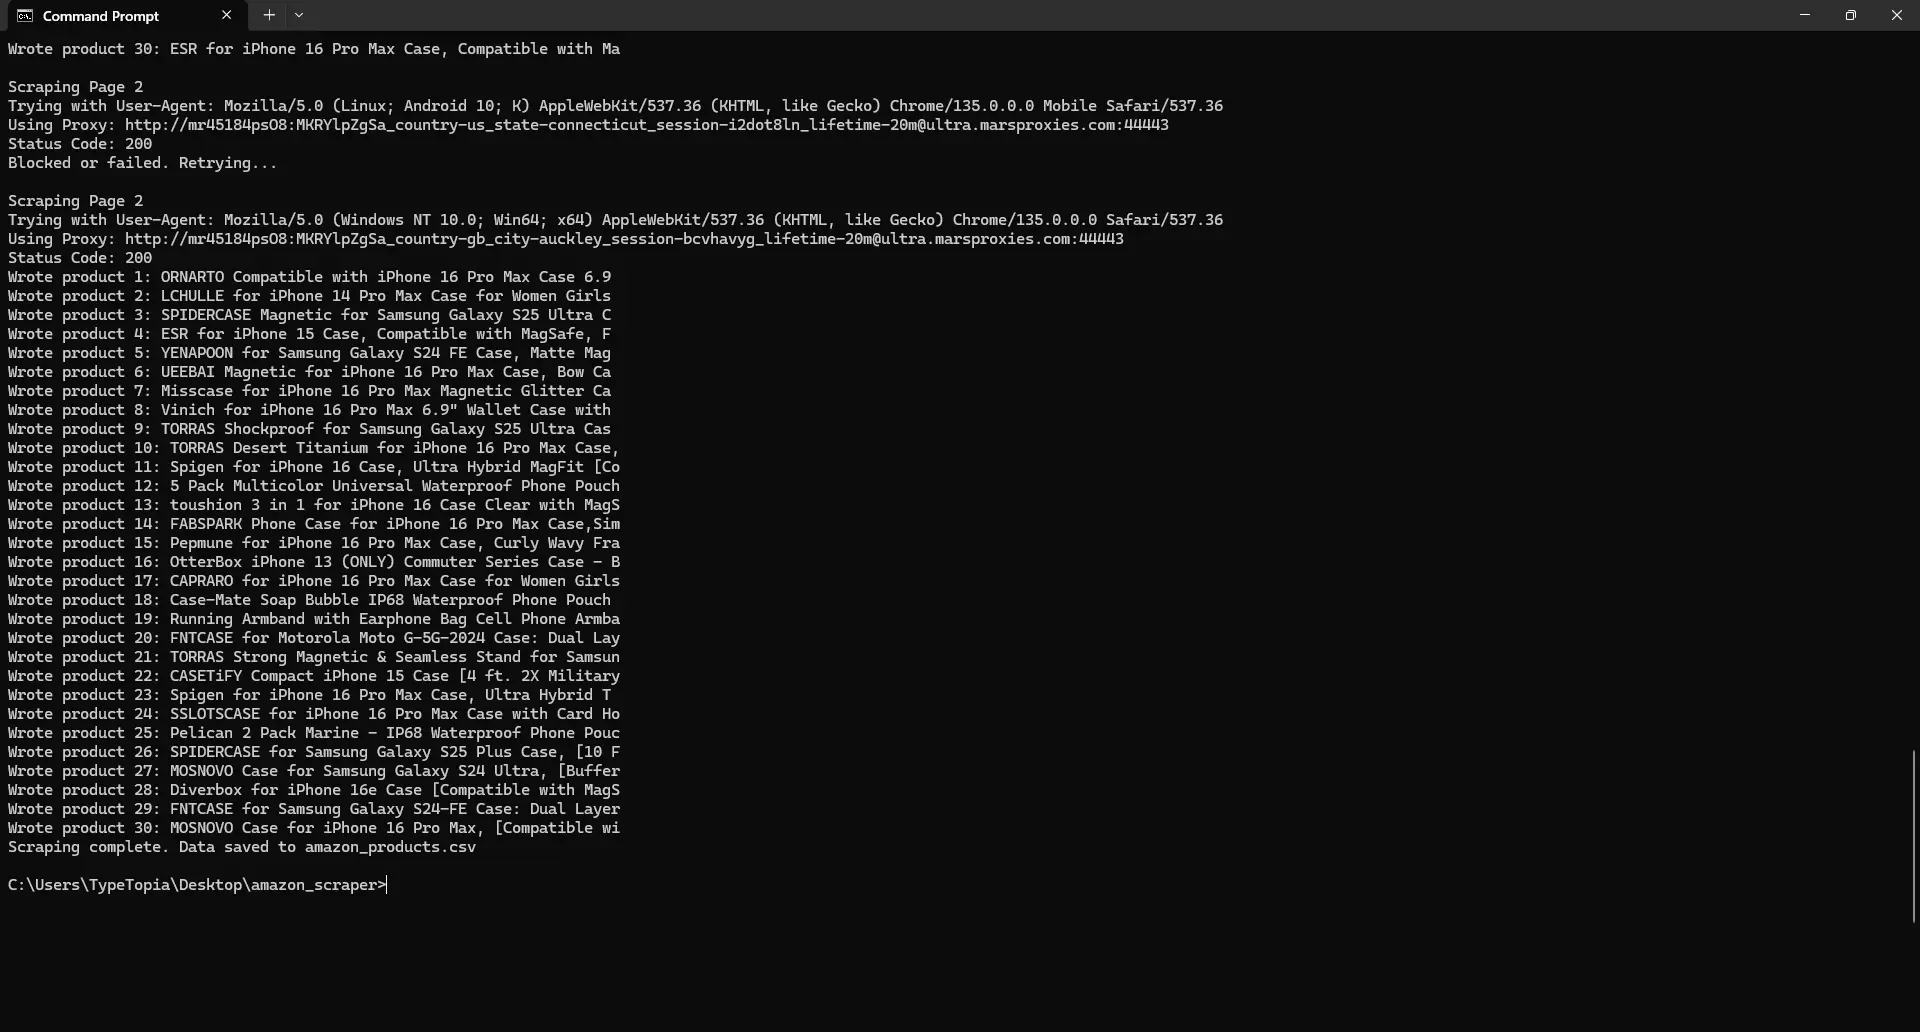
Amazon 又礼貌地返回了一个 200,但帷幕之后呢?很可能什么有用的内容都没有,也许只是占位 HTML,也许是一道 CAPTCHA 关卡。不管是哪种情况,我们都知道该怎么做:脚本暂停,换上新的代理和 User-Agent 重新伪装一番,再次发起请求。
这一次成功了。就像第一页一样,脚本定位到真正的商品容器,并开始逐条打印,总共又抓到 30 条。至此,整轮 Amazon 商品数据全部安全记录完毕,这是一次胜利。
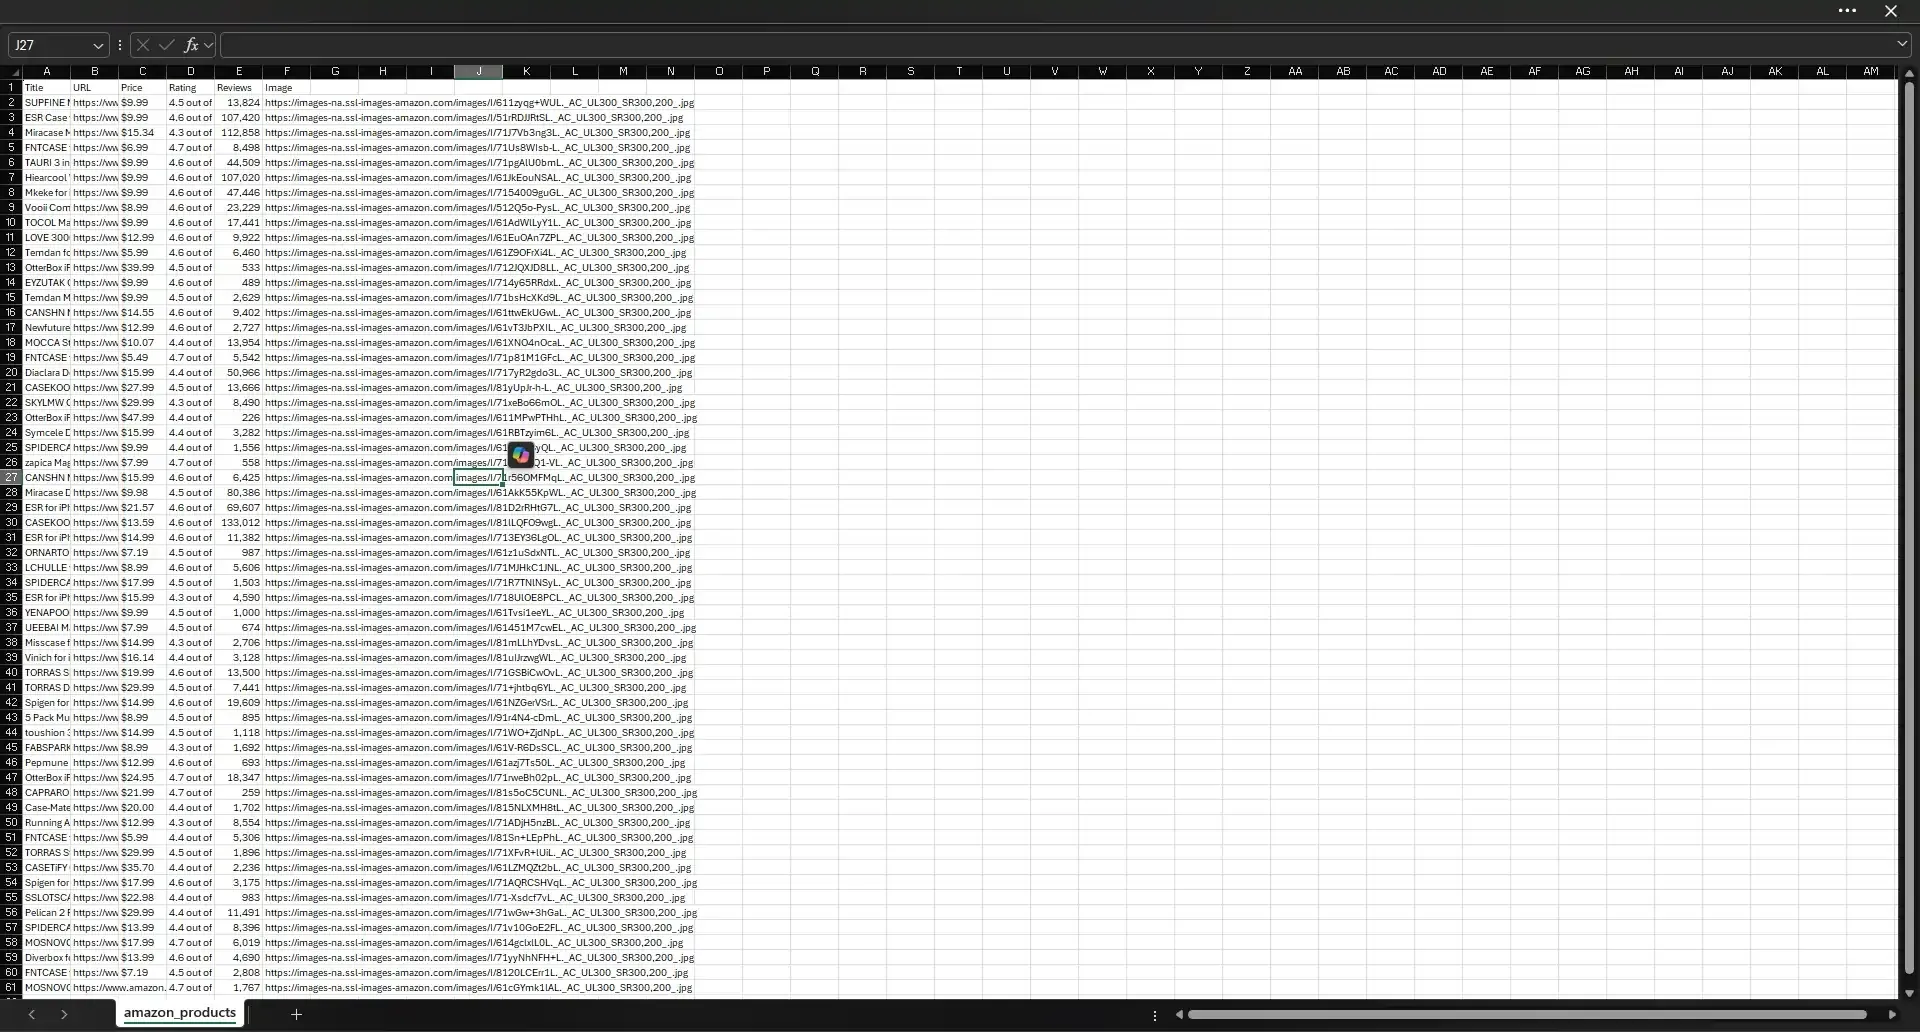
但数据真的保存到 CSV 文件里了吗?
来检查一下。进入 amazon_scraper 文件夹,找到名为 amazon_products.csv 的文件。如果一切顺利,里面应该有 60 条商品记录,每行包含标题、URL、价格、评分、评论数和图片 URL。下面是我们的结果:
Amazon 数据抓取中的常见难题
如果你原以为一个简单的 requests.get() 就能拿到商品列表,这段脚本大概已经改变了你的想法。你已经亲眼见过了:封锁、CAPTCHA,还有那些看起来真实却并非如此的假页面。
Amazon 的防护机制就是为了挡住机器人,我们的脚本也不例外。唯一的生存之道,就是提前预判它的检测、不断轮换身份、让行为更接近真人。因为那套默认的数据抓取套路在这里根本不管用。
以下是我们的数据抓取流程预判并应对的几项挑战:
数据错误或为空
你第一次看到这里可能会觉得奇怪:收到 Amazon 返回的 200 OK 之后,为什么还要检查 len(product_cards) > 0?200 不就意味着一切顺利吗?
从技术上说,是的。但在 Amazon 数据抓取里,它只意味着服务器返回了些东西,而那个东西未必是你想要的内容,这是故意为之的。
Amazon 很清楚,直接返回 403 或 429 这类明确的错误反而对你太有帮助了——你会立刻调整代码、换个 User-Agent 重试,或是轮换 IP。于是它给你的是一次“假成功”:HTML 看起来是真的,内容却是空的;更糟的情况是,CAPTCHA 被藏在一个外观酷似目标页面的 div 里。还有时候,那个 200 返回的其实是一个精简过的移动版页面。
所以我们不只检查响应是否有效,还要验证其中是否包含商品数据。如果没有,就先退避一段时间再重试。
这就像打开一扇看起来是你家的公寓门,走进去才发现里面没有一件东西是你的。同样的楼层,同样的门牌号,可一切都不对:灯确实能亮,但家具是摆设用的样板,连冰箱都没有。Amazon 的假响应正是如此:足以骗过机器人,却给不了我们人类真正有用的东西。
IP 封锁与速率限制
你可能还注意到另一点:我们从不急于求成地连续请求 Amazon,一次都没有。脚本每次被拦截,都不会慌张地立刻再发一次请求,而是先暂停——先等 10 秒,再等 20 秒,再等 40 秒。
这是一种规避速率限制的策略:Amazon 会对请求过快、过多的行为进行惩罚。
最佳实践与技巧
从我们的脚本中可以看出,抓取 Amazon 数据更多靠的是策略,而不是硬冲硬打,这意味着要遵循几项关键的最佳实践。
从分类页而非搜索页抓取
搜索页是 Amazon 防线最严密的关口:布局多变、脚本繁重,防护层层叠加,让数据抓取格外棘手。
相比之下,像畸销榜或细分商品列表这样的分类页,结构更加规律可预测。你仍然要躲开假页面和 CAPTCHA,但成功率会更高。可以把它们看作搜索结果页那位更“宽容”一点的亲戚。
轮换代理和真实 User-Agent
最容易被封的做法,就是两次都穿着同一套“衣服”出现。Amazon 会追踪模式,重复使用同一个 IP 或 User-Agent 字符串,是被挡在门外最快的方式之一。这就是我们的爬虫每发一次请求就同时切换这两者的原因。
控制请求频率
Amazon 会盯着你敲门的频率。敲得太频繁、太快,就会被拒之门外。我们用两种策略应对这个问题:在 3 到 8 秒之间随机延迟,模拟人类浏览;一旦被拦截,就采用指数级退避——第一次失败等 10 秒,再 20 秒,再 40 秒。
适合 Amazon 数据抓取的工具
Python 库
不妨花点时间,认识一下让这段脚本真正跑起来的那些小而强大的工具。正是这些库完成了繁重的工作:
- requests 负责发送我们的 GET 请求,并附带请求头和代理。
- BeautifulSoup 解析原始数据(HTML),让我们能够识别并提取商品标题、价格、图片和评论。
- fake_useragent 每次都替换 User-Agent 字符串,让我们的身份保持新鲜。
- csv 为最终数据提供了以表格形式存储的位置。
- random 为请求增添了一些不可预测性,避免看起来像机器人。
- time 负责暂停脚本运行,配合 random 模拟接近真实用户的行为。
本文还提供了更多有关如何借助工具、技巧和方法精通 Python 网络爬取的内容。
浏览器自动化工具:Selenium 与 Playwright
如果这段脚本告诉了你什么,那就是 Amazon 的反抓取机制会积极地反击。要减少爬虫中安全检查和容错逻辑的数量,可以考虑换用 Selenium 或 Playwright 这类无头浏览器工具。它们是完全模拟的浏览器,能看到真实用户所看到的一切,包括大量依赖 JavaScript 的内容、弹窗、移动端视图,甚至 CAPTCHA 提示。
这种额外的可见性,能让你捕捉到 requests 看不到的问题。遇到空白页面,或是缺少数据容器的移动端布局?自动化工具能检测到。碰上 CAPTCHA?截图、解决(借助相关服务或自己写的处理逻辑),然后继续。你不会消除所有数据抓取难题,但在这些工具能一次性解决的问题上,你肯定会少花很多时间写变通方案。
代理服务:住宅代理与数据中心代理对比
我们在这个项目中特意选择了住宅代理,因为它们更容易融入正常流量。这些 IP 分配给真实的用户和真实的 ISP,反映的是真正的住宅网络流量。当你要抓取像 Amazon 这样防护严密的平台时,这一点就很关键——每一个看起来正常的请求,都能帮你多一点时间不被察觉。
数据中心代理确实速度快、易于大规模扩展,但它是一把双刃剑。因为它们来自云基础设施和数据农场,会留下明显的指纹特征。Amazon 很清楚这一点,会持续监测这类模式并迅速作出反应。
所以,数据中心 IP 或许能帮你先进门,但也会让你更快被踢出去。相比之下,住宅 IP 能让你看起来本就属于这里。想了解 Mars 住宅代理在真实网络爬取场景中的表现,请阅读我们的指南。
抓取 Amazon 商品数据的几种方法
到目前为止,你已经能够搭建一个模拟真实用户的定制化 Amazon 爬虫,但这并不是从这个电商平台获取商品数据的唯一方式——你还可以选择使用数据抓取 API 或无代码工具。
合适的方案取决于你需要多大程度的控制权、你对编码的熟练程度、结果需要多快到手,以及你愿意为维护工作投入多少精力。
接下来,一起看看该如何选择适合抓取 Amazon 商品数据的方法,你需要了解哪些关键信息:
定制化爬虫
- 适合人群:开发者、技术团队,以及任何希望为数据驱动决策获得最大控制权的人
- 所需技术水平:高,需要具备 Python 网络爬取技能。
- 搭建速度:最慢
- 灵活性:最高
- 维护负担:最高
- 可扩展性:强,前提是架构设计得当
- 成本:软件成本较低,时间成本较高
数据抓取 API
- 适合人群:希望获得数据而不想维护抓取基础设施的企业、团队和个人
- 所需技术水平:低到中
- 搭建速度:快
- 灵活性:中等
- 维护负担:低
- 可扩展性:高
- 成本:中到高
- 示例:IPRoyal、Bright Data、ScraperAPI、ZenRows、Oxylabs Web Scraper API
无代码工具
- 适合人群:新手、非技术用户,以及一次性的快速提取任务
- 所需技术水平:最低
- 搭建速度:最快
- 灵活性:最低
- 维护负担:低
- 可扩展性:通常有限
- 成本:中等,具体取决于平台
- 示例:Octoparse、Browse AI、ParseHub
合规考量与最佳实践
以下是如何负责任地从 Amazon 提取数据:
- 遵守 robots.txt 与服务条款
Amazon 的 robots.txt 文件限制机器人抓取其许多页面,但在大多数司法辖区,忽略该文件本身并不违法。
- 限制请求频率,避免服务器过载
我们在脚本中加入了延迟和指数级退避,以保持低调,避免在短时间内发送过多请求。Amazon 通常会在你把系统搞崩之前就先封锁你,但话说回来:别成为它对所有人收紧限制的那个导火索。
- 确保数据隐私与合规
只采集公开可获取的数据,避免涉及任何可能暴露用户个人信息的内容。
我们的文章深入介绍了如何从任意网站抓取数据,不只限于 Amazon。如果你想了解通用的网络爬取技巧,这是一个不错的起点。
结语
如果你读到了这里,现在应该明白,Amazon 并非无法抓取,只是它不会让这件事变得轻松。没关系,你本就不需要轻松——你需要的是聪明、有策略、有耐心:那种会自我调整、懂得重试、不断轮换身份、并在宣布成功之前反复核实的抓取方式。
祝你好运,愿你每一次抓取都遇到真正的 200,而不是那种表面微笑、背后却藏着 CAPTCHA 的假象。愿你的代理始终新鲜、User-Agent 足够逼真、CSV 里装满真正的商品数据。
想获取更多技巧、代理配置方案,以及其他一线数据抓取者的实战经验?来我们的Discord 频道看看,欢迎加入。
立即开始使用 Amazon 代理,让 Amazon 数据抓取不再中断。
Amazon 是否允许网络爬取?
亚马逊的 robots.txt 文件会屏蔽机器人,其条款也明确写着“禁止抓取”,但违反条款并不等同于违法,关键在于您的抓取行为是否造成损害、侵犯用户隐私或滥用数据。
亚马逊是否允许抓取价格信息?
亚马逊的官方规则不允许抓取价格信息,但从公开可见的商品页面抓取价格并非一定违法,这取决于您使用的方法、目的以及操作是否合规、负责任。
亚马逊会屏蔽网络爬虫吗?
没错。我们的代码足以证明,亚马逊不仅会屏蔽抓取工具,还会对其“耍花招”:它往往不会直接报错,而是通过伪造页面、缺失数据或隐蔽的 CAPTCHA 让您误以为一切正常。
如何在不被封锁的情况下抓取亚马逊数据?
要像亚马逊一样思考:它预期机器人会重复请求、动作过快或表现得像机器,因此请放慢速度、切换 IP、使用真实的请求头,遇到封锁及时回退,并始终核实数据——返回 200 OK 并不代表数据真实有效。
抓取亚马逊数据的工具有哪些?
这取决于您想做到多深入。对于基础任务,requests 搭配 BeautifulSoup 已经足够;但如果需要处理 JavaScript、CAPTCHA 或伪造页面,Playwright、Selenium、Puppeteer 等无头浏览器会是更好的选择,别忘了再搭配智能代理服务。
亚马逊是否提供可用于大规模抓取的官方 API?
亚马逊确实提供官方 API,但这些 API 并非为抓取亚马逊数据而设计的通用方案。Product Advertising API 用于在获得使用许可后获取特定类型的商品数据;而 Selling Partner API 更多是帮助卖家管理在亚马逊上的业务,而非用于抓取网站数据。
无代码抓取工具是否有效?
如果您只需要简单的设置,且技术背景有限,无代码抓取工具确实能派上用场。这类工具适合小型项目,但从长期来看,其灵活性、控制力和稳定性都不及自定义爬虫或数据抓取 API。