世界由数据驱动。在过去十年里,数据催生了许多重大创新,其中人工智能和机器学习最为突出。从用户对 ChatGPT 产生情感依恋的担忧,到 Michael Kors 等奢侈品零售商部署人工智能虚拟助手,数据已成为我们所处这个数字化、人工智能驱动的世界的核心驱动力。
如果您希望借助人工智能和机器学习为企业创造价值,首先需要确保数据格式正确,这正是数据标准化发挥作用的地方。简单来说,数据标准化是指将数值型和文本型数据转换为统一格式,从而提高机器学习模型准确率的过程。
基于这一点,本文将探讨:
- 数据标准化及其重要性
- 常见的数据标准化方法
- 如何在 Python 中应用这些方法
请继续阅读,获取更多详细内容。
什么是数据标准化?
数据标准化是数据预处理过程中最重要的步骤之一,缺少这一环节,从信息中获取数据洞察将变得困难,尤其是在处理多种多样的数据集时。
例如,如果您想比较班级学生在不同科目上的表现,而这些科目采用不同的评分标准,就可以借助数据标准化方法,将各科成绩转换到统一的量度上,以便于比较。
以数学、科学、英语和历史为例,假设这几门科目采用以下评分标准:
- 数学:0 至 100
- 英语:0 至 50
- 科学:0 至 80
- 历史:0 至 30
某学生的各科成绩如下:
- 数学:80
- 英语:35
- 科学:50
- 历史:20
乍一看,由于各科目采用不同的评分体系,数学成绩似乎比历史成绩重要得多,按照当前的数据格式来比较学生表现相当复杂。不过,数据标准化可以将这些分数重新缩放到统一范围(通常是 0 至 1 或 -1 至 1),从而简化比较过程。
首先,我们计算各科目的百分比得分,为数据标准化做准备:
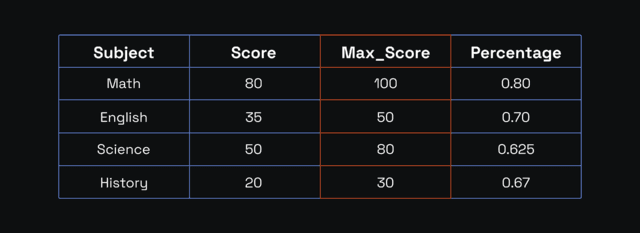
其中最高百分比为 0.80(数学),最低为 0.625(科学)。
数据标准化最简单的方法之一是简单特征缩放,也称为 Min-Max 缩放。该方法将每个数值除以该特征的最大值。下面我们用它手动对上述成绩数据进行标准化,公式如下:
Normalized Value = (X - X_min) / (X_max - X_min)
其中:
- X 表示原始值。
- X_min 表示该特征在数据集中的最小值。
- X_max 表示该特征在数据集中的最大值。
我们可以按如下方式对这些数据进行标准化:
- 数学:
Normalized Value = (0.80- 0.625) / (0.80- 0.625) = 1.000
- 英语:
Normalized Value = (0.70- 0.625) / (0.80- 0.625) = 0.429
- 科学:
Normalized Value = (0.625- 0,625) / (0.80 - 0.625) = 0.000
- 历史:
Normalized Value = (0.67- 0.625) / (0.80 - 0.625) = 0.257
现在得到:
- 数学:1.00
- 英语:0.429
- 科学:0.000
- 历史:0.257
现在各科成绩已经统一到相同量度,更容易从数据中分析出表现最好和最差的科目。这正是数据标准化所要达到的目的。
为什么数据标准化很重要
在为算法和机器学习模型预处理数据时,数据标准化非常重要。为了解其中原因,我们回顾一下之前的学生成绩示例,重新列出各科分数:
- 数学:80
- 英语:35
- 科学:50
- 历史:20
假设我们想用这些数据来训练一个机器学习算法。如果直接按当前格式将这些数据点输入系统,后续可能会引发各种问题。为了解释原因,我们将给出一个大致的总体说明,而不深入探讨复杂的细节。
可以把机器学习的过程想象成一片由大小不一的山丘组成的地形;最低点代表最小误差,最高峰代表最大误差。算法的目标自然是尽可能到达最低点。
多数现代人工智能模型,尤其是使用神经网络的模型,通过不断迭代调整模型参数来实现学习。每一次迭代中,算法都会朝着能让误差降到最低点的方向调整参数。
比如数学得分为 80,对应一座大山丘;历史得分为 20,对应一座小山丘。这些科目本应同等重要,但由于算法直接处理原始数据,它并不知道这一点,因此可能会更关注大山丘而忽略小山丘,从而导致预测结果出现偏差、不够准确。
这就是数据标准化如此重要的原因。它能够拉平这些山丘,确保所有科目看起来同样重要,这样一来,模型就能朝着最低点稳健、准确地前进,这一过程也被称为收敛。
简而言之,数据标准化分析方法可以确保人工智能模型不会仅因为某个特征的取值范围更大就过度关注它。将数据统一缩放到标准量度后,算法会同等看待每一个数据点,从而更快、更准确地实现收敛。
理解 Python 中的数据标准化
现在我们来到本文的核心内容:如何在 Python 中实现数据标准化。不过在此之前,先来看看为什么选择 Python。编程语言有很多种,究竟是什么让 Python 特别适合用于数据标准化?请继续阅读下文寻找答案。
功能强大的数据标准化库
使用 Python 进行数据标准化的主要原因之一,是该平台拥有丰富的库生态系统,包括:
- Pandas
该库提供了多种多样的数据分析和结构化工具。
- Scikit-learn
这是一个功能全面的库,内置了 MinMaxScaler、StandardScaler 等标准化函数。
- NumPy
该库支持数组和矩阵运算,适合用于自定义标准化任务。
简洁易用的语法
作为一种编程语言,Python 语法流畅自然,代码易读易懂。凭借强大的社区支持,代码维护和调试也相对简单,网络上还有大量免费资源可供参考。
与机器学习框架的集成
Python 能够顺畅集成 Tensorflow、PyTorch 等常用机器学习框架。这也让它自然而然地成为处理机器学习模型输入数据标准化的常用语言。
了解了这门编程语言的多功能性之后,您可能会好奇具体该如何在 Python 中进行数据标准化。别担心,下文将为您一一讲解:
如何在 Python 中实现数据标准化
本文将介绍 Python 中几种常见的数据标准化方法:
Min-Max 缩放
还记得我们用来标准化学生成绩的那个公式吗?之所以称为 Min-Max 缩放,是因为它会利用给定数据集中的最小值和最大值来计算标准化后的数值,回到之前的例子:
- 数学:100 分中的 80 分
- 英语:50 分中的 35 分
- 科学:80 分中的 50 分
- 历史:30 分中的 20 分
接下来,我们用 Python 中的 Min-Max 缩放对这些数据进行标准化。请在您选用的编辑器中安装好所有依赖项后运行以下代码:
from sklearn.preprocessing import MinMaxScaler
import pandas as pd

# Original data

data = {
  'Subject': ['Math', 'English', 'Science', 'History'],
  'Score': [80, 35, 50, 20],
  'Max_Score': [100, 50, 80, 30]
}

# Convert to DataFrame
df = pd.DataFrame(data)

# Calculate the percentage score
df['Percentage'] = df['Score'] / df['Max_Score']

# Initialize the MinMaxScaler
scaler = MinMaxScaler()

# Fit and transform the percentage scores
df['Normalized'] = scaler.fit_transform(df[['Percentage']])

# Display the normalized data
print(df[['Subject', 'Normalized']])
运行后将得到以下结果:
科目 标准化值
0 Math 1.000000
1 English 0.428571
2 Science 0.000000
3 History 0.238095
可以看到,这个结果与我们手动计算的标准化数值非常接近。处理大型数据集时,这种方法速度更快,能节省大量时间。
Z-Score 标准化
Min-Max 方法利用数据集中的最小值和最大值进行标准化,而 Z-Score 标准化方法则以标准差为基准对数据进行中心化处理,确保每个特征对模型的贡献相同。公式如下:
Z = (X - μ) / σ
其中:
- Z 表示 Z 分数(标准化后的数值)。
- X 表示原始值。
- μ(mu) 表示该特征的均值。
- σ(sigma) 表示该特征的标准差。
与其花时间手动计算(尤其是面对大型数据集时),不如直接用 Python 通过 Z-Score 标准化对数据进行处理。沿用之前的例子,代码如下:
from sklearn.preprocessing import StandardScaler

import pandas as pd
# Original data

data = {
    'Subject': ['Math', 'English', 'Science', 'History'],
    'Score': [80, 35, 50, 20]
}

# Convert to DataFrame
df = pd.DataFrame(data)

# Initialize the StandardScaler
scaler = StandardScaler()

# Fit and transform the data
df['Z-Score'] = scaler.fit_transform(df[['Score']])

# Display the standardized data
print(df[['Subject', 'Z-Score']])
您将得到以下结果:
科目 Z-Score
0 Math 1.095445
1 English -0.297076
2 Science 0.000000
3 History -0.798369
如果您好奇为什么结果不同,这是因为我们采用了不同的计算方法。Z 分数衡量的是某个数值偏离均值的标准差个数。
例如,得分最低的科学与均值相差 0 个标准差,而得分最高的数学与均值相差 1.095 个标准差。可以看出,这两种方法对数据的解读结果是一致的。
MaxAbs 缩放
这种数据标准化方法适用于同时包含正负值的数据集。它通过将每个特征除以其绝对值的最大值,把数据缩放到特定范围(通常是 -1 至 1),公式如下:
X_scaled = X / max(|X|)
其中:
- X_scaled 表示该特征的缩放值。
- X 表示该特征的原始值。
- max(|X|) 表示该特征的最大绝对值。
我们换一个例子来说明这种方法的具体操作。假设有一个数据集,包含以下数值:
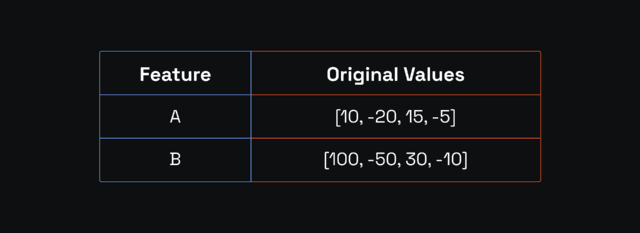
我们将使用以下 Python 代码,通过 MaxAbsScaler 对特征 A 进行标准化:
from sklearn.preprocessing import MaxAbsScaler

import pandas as pd
# Original data

data = {'Feature': [10, -20, 15, -5]}
df = pd.DataFrame(data)

# Initialize the MaxAbsScaler
scaler = MaxAbsScaler()

# Fit and transform the data
df['Scaled'] = scaler.fit_transform(df[['Feature']])

# Display the scaled data
print(df[['Feature', 'Scaled']])
您将得到以下结果:
Feature Scaled
0 10 0.50
1 -20 -1.00
2 15 0.75
3 -5 -0.25
现在数据被统一到 -1 至 0.5 的标准范围内,算法处理起来也更加容易。
小数定标缩放
这种方法适用于小数位数不一致的数据集,通过根据特征的绝对值移动小数点来实现标准化,公式如下:
X_scaled = X / 10^j
其中:
- X_scaled 表示该特征的缩放值。
- X 表示该特征的原始值。
- 10^j 表示 10 的 j 次方,j 的取值取决于该特征的最大值。
接下来我们用 Python 中的小数定标缩放对以下数据集进行标准化:
- 数值:0.345、-1.789、2.456、-0.678
代码如下:
import pandas as pd

# Original data with decimal points
data = {
   'Feature': [0.345, -1.789, 2.456, -0.678]
}

df = pd.DataFrame(data)

# Find the maximum absolute value in the dataset
max_abs_value = df['Feature'].abs().max()
# Determine the scaling factor
import math

# Find the smallest power of 10 greater than the maximum absolute value
scaling_factor = 10 ** math.ceil(math.log10(max_abs_value))

# Apply Decimal Scaling
df['Scaled'] = df['Feature'] / scaling_factor

# Display the original and scaled data
print(df)
结果如下:
Feature Scaled
0 0.345 0.0345
1 -1.789 -0.1789
2 2.456 0.2456
3 -0.678 -0.0678
如何使用 Python 规范化文本数据
在对机器学习模型进行数据分析和准备时,您可能还需要对文本数据进行规范化处理。与数值不同,文本数据规范化通常包括转换为小写、去除标点符号和分词。例如,您可能需要将文本拆分为称为词元(token)的单元,这些单元可以是短语或符号。假设我们要拆分这段文本:
"Tokenization splits texts into words."
使用以下代码对该文本数据进行规范化处理:
import nltk

from nltk.tokenize import word_tokenize

# Download the necessary NLTK resource
nltk.download('punkt')

# Sample text
text = "Tokenization splits text into words."

# Tokenize the text
tokens = word_tokenize(text)

# Display the tokens
print(tokens)

The tokenized text should be as follows:
['Tokenization', 'splits', 'text', 'into', 'words', '.']
结论
关于数据规范化方法的讨论到此结束。这一过程对于为机器学习模型准备输入数据至关重要。虽然您可以手动完成数据规范化,但面对大规模数据集时并不现实。
Python 之所以受到青睐,是因为它拥有丰富的库、简洁流畅的语法,并且是开源的。本文介绍的方法包括最小-最大缩放、小数定标和 Z-Score 标准化。现在,您可以用更高的准确率训练机器学习模型。
常见问题
缩放(Scaling)与规范化(Normalization)有什么区别?
虽然两者都是常见的数据预处理技术,但二者之间存在细微差别。规范化会尝试将数值调整到特定范围内,而缩放则是调整特征值的范围,但不一定将其限制在特定区间内。
标准化(Standardization)与规范化(Normalization)有什么区别?
标准化会将数据转换为均值为零、标准差为一的分布,而不将其限制在特定范围内。规范化则会将数据重新缩放到特定范围内,例如 [0,1] 或 [-1,1]。
规范化数据与反规范化数据有什么区别?
规范化数据是在机器学习数据预处理过程中转换为特定范围内的数据。而反规范化数据则是已还原为原始形式的数据。