关键考量
- Python 适合做原型开发,但 Java 在高并发和企业系统集成方面更具优势,适合大规模场景。
- 使用 Gradle 搭建项目、Jsoup 处理静态页面、Selenium 处理动态网站、WebMagic 执行大规模爬取。
- 我们的 Hacker News 演示配置了 Gradle,通过轮换代理抓取博客文章,并将结果保存为 CSV 文件。
虽然 Python 常常是网络爬取的首选语言,但在某些场景下 Java 其实更合适。如果您的项目本身运行在 Java 框架上,或者需要直接对接企业系统,继续使用 Java 可以节省时间、减少复杂度。
本教程将带您使用可靠的库从零构建一个 Java 爬虫。您将学会如何发送 HTTP 请求、用 CSS 选择器解析 HTML、并高效提取数据。我们会一步步讲解完整流程,让您能将 Java 用于实际的网络爬取任务。
为什么选择 Java 进行网络爬取
如果您读过我们关于使用 Python 爬取 Amazon 或 Best Buy 的教程,就会知道代码虽长,但一条命令就能运行。
Java 不是这样,因为这门语言强制要求代码结构化。每个公共类都必须放在自己的 .java 文件里。最终您会得到一个用于运行整体流程的主文件,还有分别存放爬取库、爬虫配置,也许还有 HTTP 客户端的独立文件。
这是一套需要更多准备工作的不同流程。既然 Python 更简单,为什么人们还要用 Java 做网络爬取呢?
Java 在网络爬取中的优势
Java 在网络爬取中的核心优势,在于它对企业级系统的良好支持。不同于那些只需运行一两次的临时脚本,Java 的设计初衷就是面向合规性、可审计性和系统集成都是硬性要求的环境。
性能与安全
抓取100个页面时,Python 完全够用。但当页面量达到10万、且对实时性有要求时,CPython 中的全局解释器锁(GIL)就可能成为瓶颈。
GIL 使 CPU 密集型任务无法实现真正的并行处理。为了突破这一限制,开发者会使用多进程或异步 I/O,但两者都会在内存管理、协调或配置上增加复杂度。
这正是 Java 展现优势的地方。
Java 线程以原生操作系统线程的形式运行,因此任务可以在不受 GIL 限制的情况下跨 CPU 核心并行执行。结合线程池、执行器,或是 Akka、Vert.x 等高性能框架,Java 能够为繁重的工作负载提供可自然扩展的并发能力。
Java 虚拟机(JVM)生态与库
现代网络爬取工具需要的远不止基本的请求与响应。如今的流程通常包括:
- 启动无头浏览器以渲染依赖 JavaScript 的动态网站
- 维护会话和 Cookie,使爬虫表现得像已登录用户
- 借助第三方破解工具或人工介入服务处理 CAPTCHA 和反机器人防护
- 使用支持 CSS 选择器或 XPath 的库处理 HTML 内容
- 借助 Apache PDFBox 或 Tesseract OCR 等工具从 PDF 或图片中提取数据
- 将结果流式写入存储系统
Java 的生态系统在支持这一切方面具备独特的优势。
执行 JavaScript,支持规避检测
Selenium WebDriver(Java)、Playwright for Java
通过 ExecutorService 实现真正的操作系统线程,浏览器交互全程保持强类型
保持登录状态、轮换身份、检测软封锁
OkHttp + CookieJar、Apache HttpClient + CookieStore、Selenium Cookie 管理
将会话状态定义为类型化对象,可轻松持久化到磁盘或数据库,通过 ChallengeStrategy 接口替换逻辑
解析页面、调用 API、从 PDF/图片中提取数据
Jsoup(HTML + CSS 选择器)、Jackson(JSON)、JAXP、Jackson XML、JOOX(XML)、PDFBox、iText(PDF)、Tess4J、ImageIO(OCR/图像格式)
支持流式解析并可控制垃圾回收,为大规模爬取任务提供背压支持
写入数据库、传输至 Kafka、批量导入云端或数据湖
JDBC + HikariCP、jOOQ、MyBatis、Kafka 客户端、Pulsar 客户端、AWS SDK、GCS SDK、Hadoop FS
稳定的生产级连接器,在高负载下实现精细的事务处理
使用现代语法、添加脚本层
Kotlin(代码更简洁)、Scala(借助 Akka 实现并发)、Groovy(脚本/模板)
在不离开 JVM 的情况下与 Java 混合搭配使用,针对不同任务选用合适的工具,同时保持共享内存、类型和部署的一致性
类型安全与可维护性
刚接触 Java 时,相比 Python 可能会觉得它比较死板。但这种结构恰恰在后期会带来回报。用 Python 写的爬虫可能一直运行良好,直到网站某个细节发生变化——比如价格字段从 19.99 变成了 19,99。
Python 不会给出警告——脚本会继续运行,错误要到工作流的后续环节才会暴露出来。而在 Java 中,您必须预先定义好数据类型。
如果某个价格无法被解析为声明的类型,Java 会在边界处直接抛出明确的异常,而不是让错误数据悄无声息地混过去。这种类型安全可以避免整整一类隐藏 bug,并让调试过程在爬虫复杂度上升时依然保持可预测性。
企业级集成
Java 能很好地融入企业 IT 环境。许多大型组织已经在依赖基于 Java 的中间件、用于流处理的 Kafka,以及用于数据存储的 Oracle 或 PostgreSQL。
在这样的环境中进行 Java 网络爬取时,您可以直接使用现有的企业连接器,而无需依赖临时脚本或封装层。
您的爬虫可以原生运行在现有生态系统中,使用与其他生产服务相同的部署流水线、监控工具和安全策略。
这种流畅的集成能力,正是 Java 网络爬取有时会被用于大规模 ETL 工作流的原因之一。使用 Java 网络爬取库构建的结构良好的爬虫,可以从目标网站拉取数据、处理 HTML 内容并输出结果。
与 Python 相比的不足之处
Java 在网络爬取中具备出色的集成能力、并发性能和类型安全,但也并非没有局限。与 Python 相比,正是那种让 Java 在大规模场景下稳健可靠的结构,在做实验性尝试时会显得有些繁琐。
- Java 在语言层面的不足
Java 就像那种碰球之前要先花20分钟讲解规则手册的朋友。在网络爬取中,这意味着大量样板代码:配置客户端、构建器模式、类型声明、try-with-resources,这些都要在提取第一行文本之前完成。
- 生态缺口与阻力
许多 Java 爬取库最初是为企业级网络通信设计的,而非专为爬取工作流打造。相比之下,Python 的生态系统是由那些长期从网络上抓取数据、处理封锁、快速迭代的社区塑造而成的。这也是为什么 Scrapy、Requests、Playwright 这样的框架在爬取方面感觉量身定制,而大多数 Java 工具却做不到这一点。
Python 与 Java 在网络爬取中的对比:速查指南
速度快、配置简单
速度较慢,样板代码较多
能很好地处理破损标记(Beautiful Soup)
解析较严格,处理格式错误的 HTML 较吃力
Playwright/Selenium 生态成熟
封装工具较少,文档较薄弱
借助异步框架可良好扩展,但在 CPU 密集型任务上受 GIL 限制
凭借原生线程和 JVM 性能,适合并行任务
数据库/ETL 依赖外部连接器
与 Kafka、数据库及基于 JVM 的数据工具深度集成
灵活但类型约束较松
类型约束强,大规模场景下更安全
以爬取为核心的工具与文档
以企业需求为核心的库
搭建开发环境
是时候动手实践 Java 网络爬取了。首先,请确保已安装 Java 及其他前置工具。
在设备上安装 Java
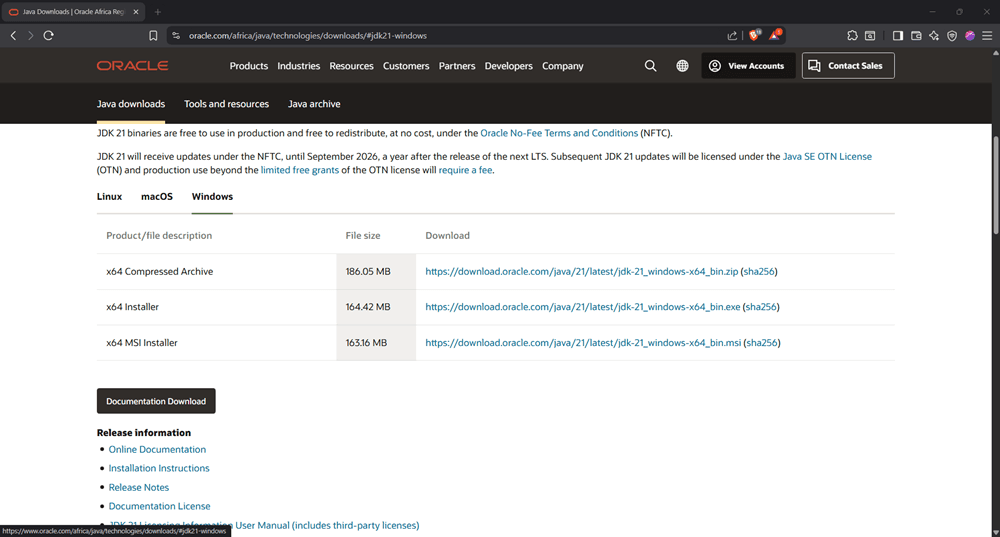
第1步:下载 Java SE 开发工具包(JDK)
访问Oracle 官网(或某个 OpenJDK 提供商),下载 Java 21——这是 Gradle 完全支持的最新长期支持(LTS)版本。先不要下载21以上的最新版本,原因我们稍后会解释。
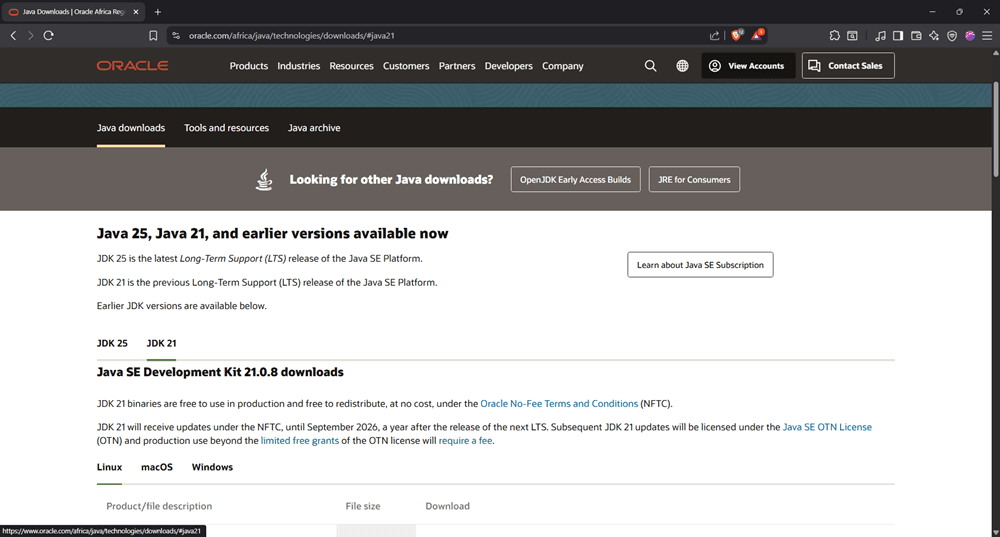
第2步:选择操作系统并下载 JDK 安装包
选择您的操作系统并下载安装包。在 Windows 上,通常是 .zip 文件(如果偏好安装程序,也可选择 .msi)。在 Linux 和 macOS 上,通常会看到 .tar.gz 文件。本教程将以 Windows 的 .zip 发行版为例进行演示。
第3步:在 Program Files 中创建 Java 文件夹
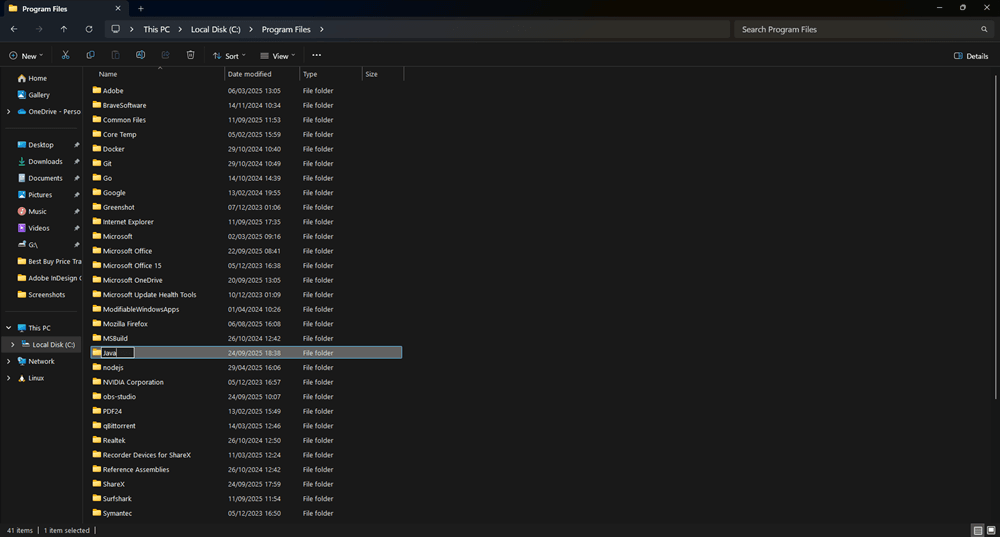
在 C:\Program Files 中新建一个名为 Java 的文件夹,这里将用来存放解压后的 JDK。如果您使用的是 .msi 安装程序,该文件夹可能已经存在;但如果是从 .zip 文件安装,就需要手动创建。
第4步:将 JDK 压缩包解压到 Java 文件夹中
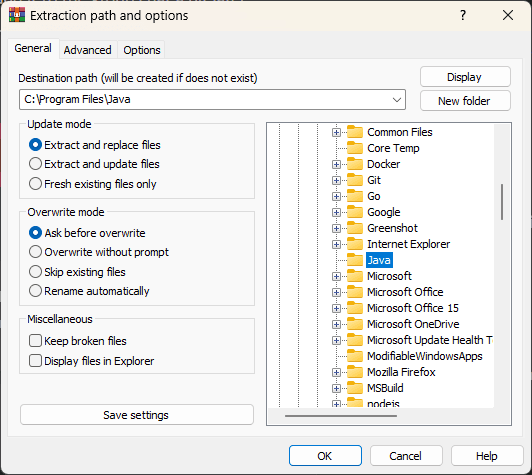
将下载的 JDK 压缩包解压到 C:\Program Files\Java 中。解压后,您应该能在 C:\Program Files\Java 中看到类似 jdk-21 的文件夹,这将作为您 Java 安装的基础目录。
第5步:设置环境变量
按 Win + S 并搜索“Environment Variables”。
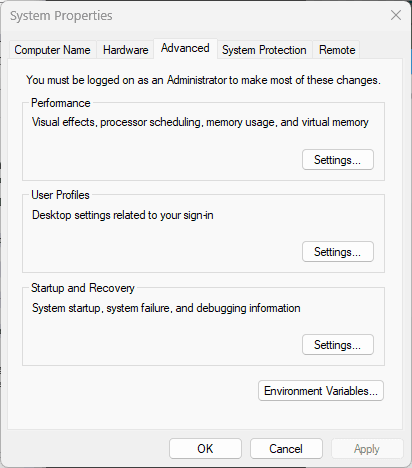
在“System Variables”下,点击“New”并输入:
- 变量名:JAVA_HOME
- 变量值:C:\Program Files\Java\jdk-21
同样在“System Variables”下,找到“Path”,点击“Edit”,再点击“New”,添加:
C:\Program Files\Java\jdk-21\bin
点击“OK”保存所有更改。
第6步:验证安装
打开命令提示符并执行:
java -version
您应该能看到 Java 安装的相关信息。
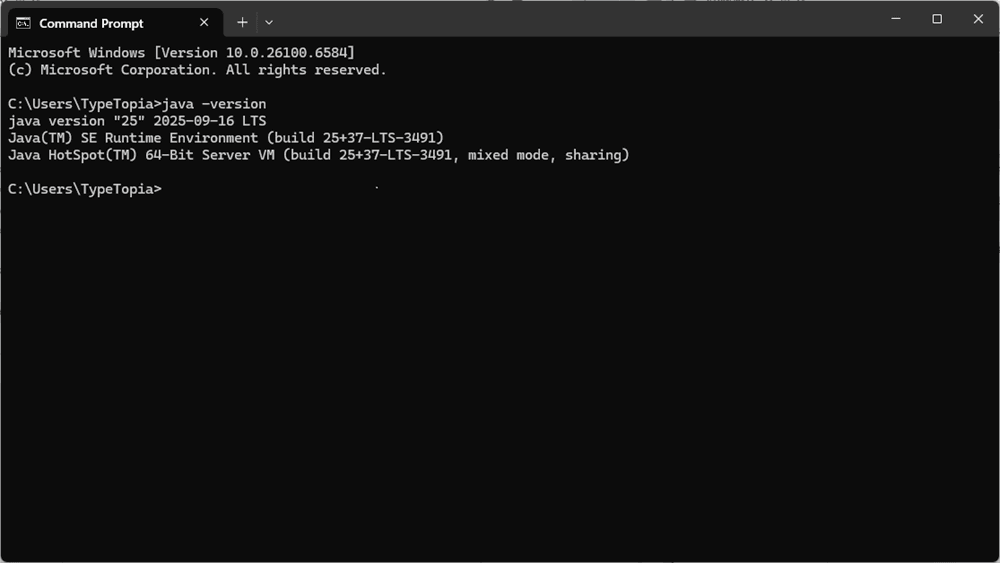
再执行:
javac -version
如果两条命令都返回了版本信息,说明一切就绪。
构建工具
如果您是从 Python 转过来的,要做好心理准备:Java 不会让您随手写个脚本就能跑起来。在 Python 中,您可以用 pip 安装一个库、导入它,然后在几分钟内开始爬取。而在 Java 中,即便是最基础的爬虫也需要更完整的结构。
- 需要将 .java 文件编译为 .class 文件
- 需要声明并解析 Jsoup、OkHttp 或 Selenium 等外部库
- 项目必须遵循编译器所要求的文件夹和包结构规范
这些步骤虽然可以手动完成,但很快就会变得混乱。因此,在实际的 Java 数据抓取项目中,Maven、Gradle 这类构建工具已是行业标准。
Maven
Maven 为您的爬虫提供清晰的项目结构、依赖管理,并在后台自动完成重复的构建步骤。借助 Maven,您可以:
- 管理 Jsoup、OkHttp、Selenium 等依赖,无需手动下载 .jar 文件
- 通过一条命令构建整个项目
- 将代码打包为可运行的 .jar 文件或可部署的构建产物
- 定义项目的生命周期,使整个网络爬取流程——从编译代码到生成输出——可重复、可一致执行
为此,Maven 强制规定了一套每个 Java 网络爬虫都要遵循的标准项目结构,具体如下:
├── pom.xml
└── src/
    └── main/
        └── java/
            └── com/
                └── orina/
                    └── scraper/
                        ├── Main.java
                        └── HtmlParser.java
    └── test/
        └── java/
            └── com/
                └── orina/
                    └── scraper/
                        └── MainTest.java
- src/main/java 存放实际的网络爬取逻辑,包括发送 HTTP 请求、使用 CSS 选择器读取 HTML 内容
- src/test/java 存放测试文件(为可选项,但在构建需要大规模运行的爬虫时非常有价值)
- pom.xml 是整个项目的核心配置文件,用于定义 Maven 要执行的任务:项目所需的数据抓取库、使用的 Java 版本,以及代码的构建和运行方式
Gradle
另一款可用于管理 Java 项目的工具是 Gradle,它比 Maven 更灵活,对开发者也更友好。它完成的核心任务相同:
- 管理 Jsoup、Selenium、OkHttp 等数据抓取库
- 将 .java 文件编译为 .class 文件
- 将 Java 网络爬虫打包为可运行的 .jar 文件
- 为爬虫定义一套可预测的构建流程
两者的区别在于实现方式:Gradle 不像 Maven 那样使用 XML,而是采用更简洁的脚本语言——Kotlin 或 Groovy,读起来更像真正的代码,也为自定义网络爬取流程留出了空间。它更易修改、更易自动化,在爬虫后续迭代时维护起来也更轻松。
以下是在 Maven 中添加 Jsoup 1.15.3 版本的方式:
<project>
  <modelVersion>4.0.0</modelVersion>
  <groupId>com.orina</groupId>
  <artifactId>web-scraper</artifactId>
  <version>1.0</version>
  <dependencies>
    <dependency>
      <groupId>org.jsoup</groupId>
      <artifactId>jsoup</artifactId>
      <version>1.15.3</version>
    </dependency>
  </dependencies>
</project>
这种方式虽然可行,但代码冗长,且所有内容都必须嵌套在标签中。下面是用 Gradle 实现同样效果的写法:
plugins {
    id 'java'
}

group = 'com.orina'
version = '1.0'

repositories {
    mavenCentral()
}

dependencies {
    implementation 'org.jsoup:jsoup:1.15.3'
}
结果相同,Jsoup 都被添加到项目中。但使用 Gradle 时,代码更短、更易读。本教程将使用 Gradle,安装方式如下:
安装 Gradle
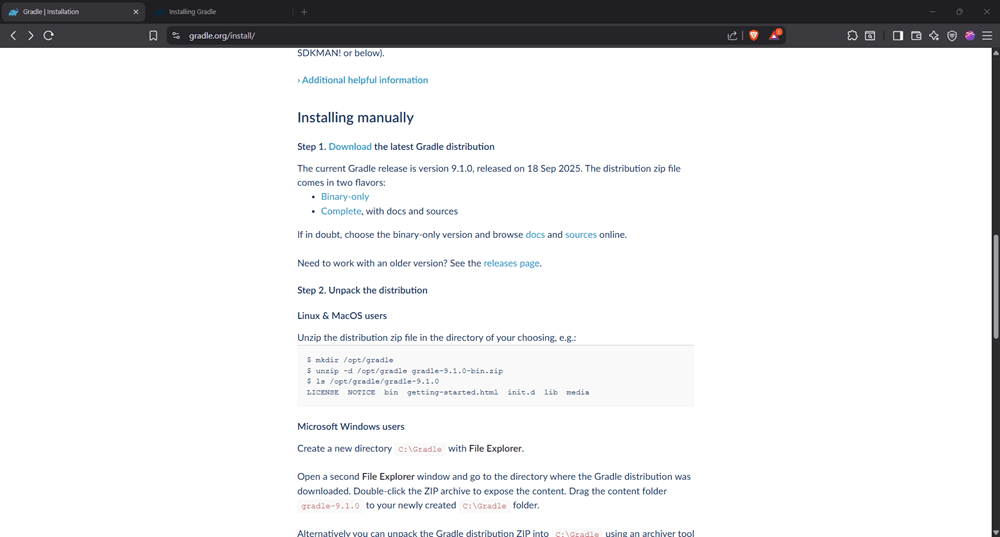
第 1 步:打开 Gradle 官网
访问官方 Gradle 网站,点击“Install Gradle 9.1.0”按钮,向下滚动至“Installing manually”部分:
第 2 步:下载发行包
点击第一步中的“Download”按钮,页面会跳转至新的下载页。
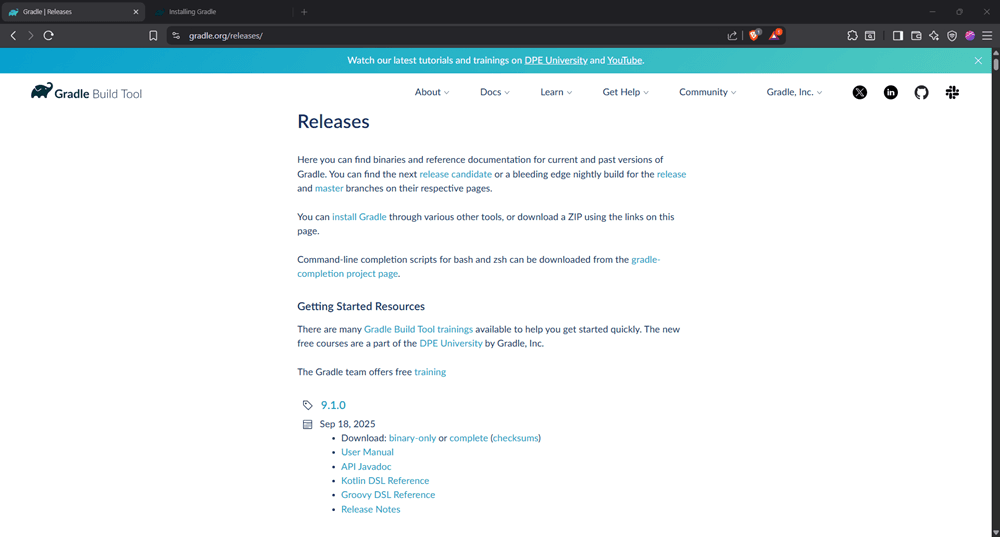
下载完整文件。
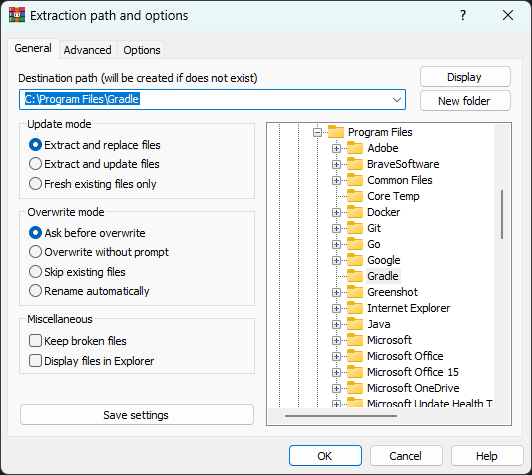
第 3 步:创建 Gradle 文件夹
创建以下文件夹:
C:\Program Files\Gradle
第 4 步:解压 Gradle
将下载的文件解压到上述文件夹中。
第 5 步:设置环境变量
按 Win + S 搜索“Environment Variables”。
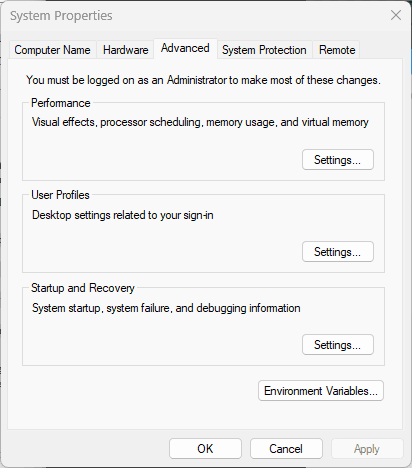
系统会跳转到以下窗口:
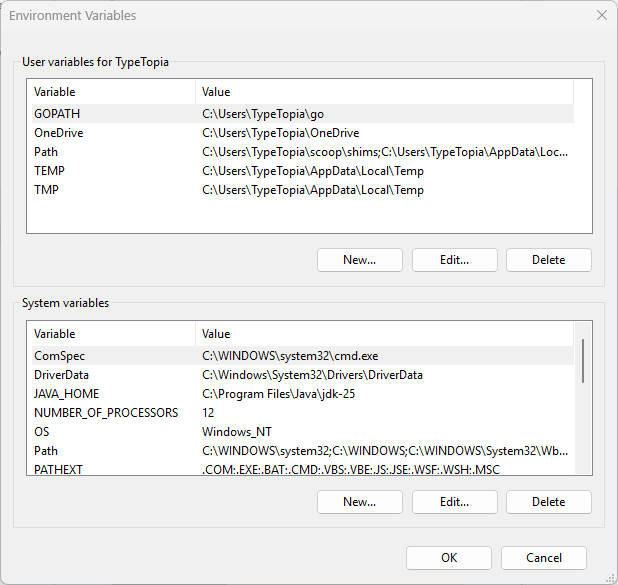
在“系统变量”下,点击“新建”。
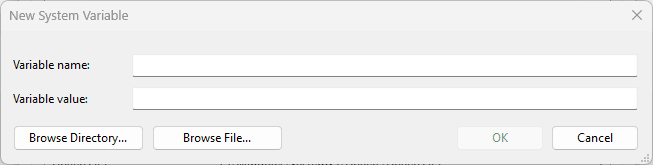
并添加:
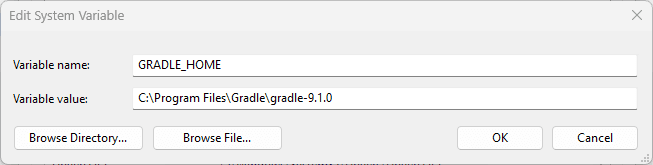
- 变量名:GRADLE_HOME
- 变量值:C:\Program Files\Gradle\gradle-9.1
点击“确定”保存。
第 6 步:更新 Path
在“系统变量”中选择“Path”变量
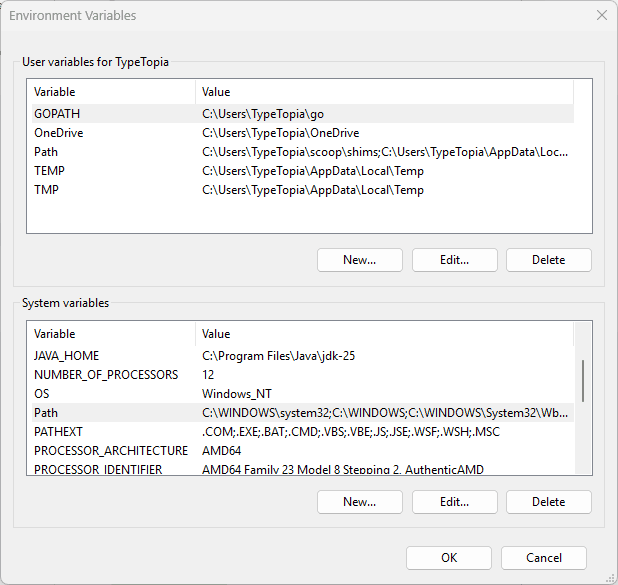
点击“编辑”,然后点击“新建”。
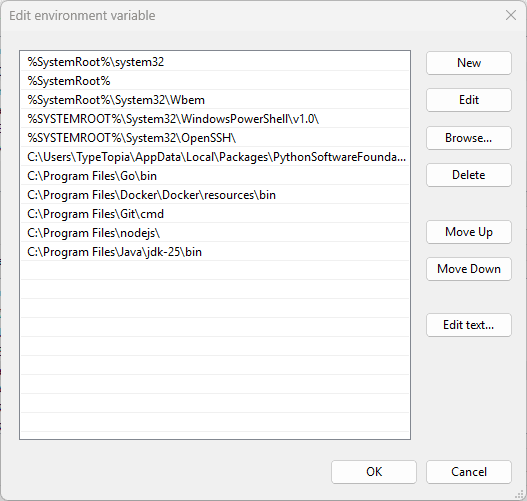
添加:
%GRADLE_HOME%\bin
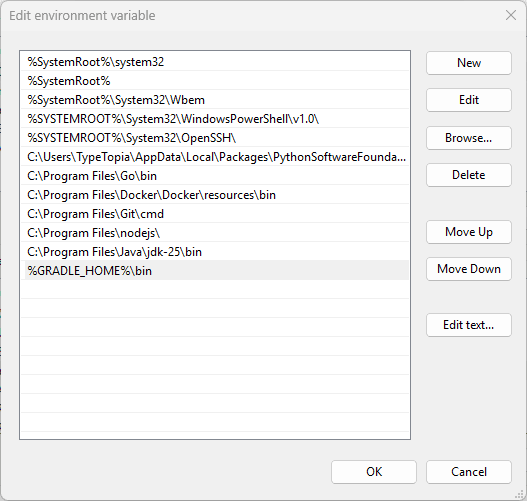
在所有窗口中点击“确定”保存更改。
第 7 步:验证安装
打开新的命令提示符并执行:
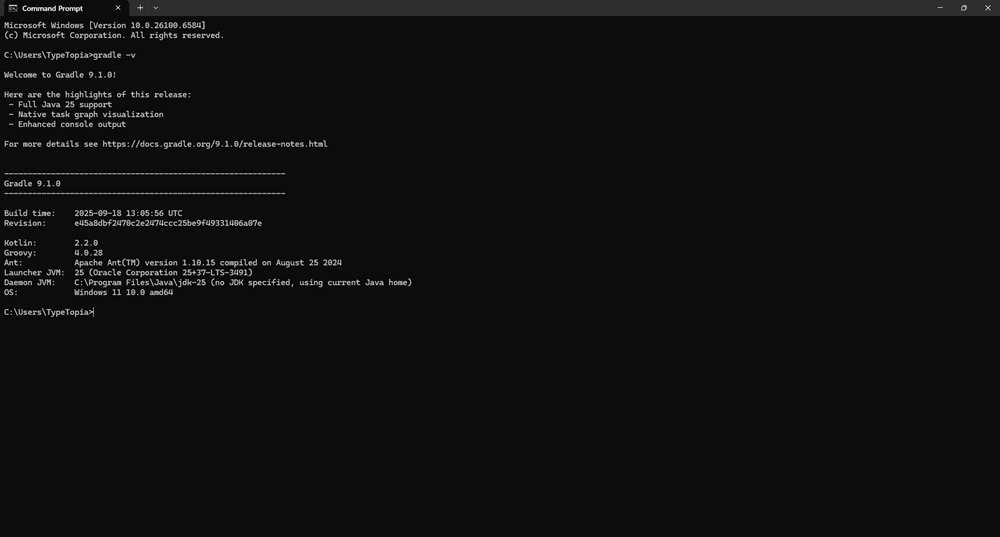
gradle -v
您应该会看到当前 Gradle 版本的相关信息,如下所示:
哪款 IDE 更适合 Java 网络爬取?
在开始编写代码之前,还有最后一件事要确定:您的集成开发环境(IDE)。
在 Python 中,这不算什么大问题——您可以在任意编辑器中编写脚本,再从终端运行。但 Java 有自己的一套规则,因此需要一款能为您处理好这一切的 IDE。
对于使用 Java 进行网络爬取而言,IntelliJ IDEA 是适合的选择。它是 Java 开发者的行业常用工具,能让您的工作流程更快、更简洁、更不容易出错。
它有两个版本:
- 社区版(免费)
- 非常适合构建网络爬虫
- 内置对 Gradle、Maven 的支持
- 自动处理 Java 构建、错误检查和文件夹结构
- 旗舰版(付费)
- 更适合使用重量级框架的企业级应用
- 对于网络爬取或管理数据抓取库而言并非必需
本教程全程使用 IntelliJ IDEA 社区版,因为它已能满足我们所需的全部功能。前往 JetBrains 官网,下载安装程序并按提示操作。安装完成后,打开 build.gradle 文件,IntelliJ 会自动导入所有依赖并为您准备好网络爬取环境。
使用 Jsoup 抓取静态页面
现在可以开始了。在编写代码之前,先把语法弄清楚。对于静态页面,我们将使用 Jsoup 库,稍后会详细介绍。以下是入门步骤:
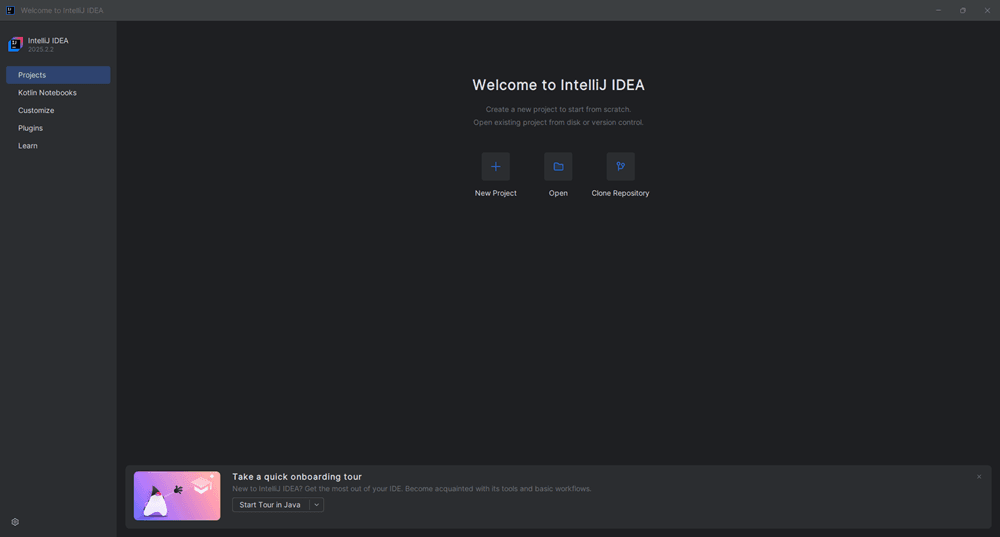
第 1 步:启动 IntelliJ IDEA
打开 IntelliJ IDEA。
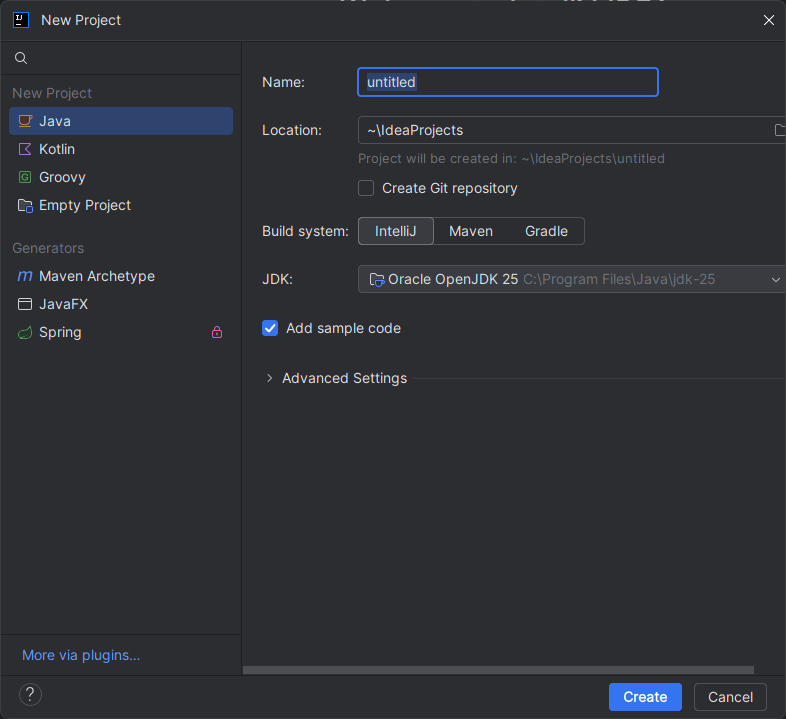
第 2 步:新建项目
选择“New Project”。
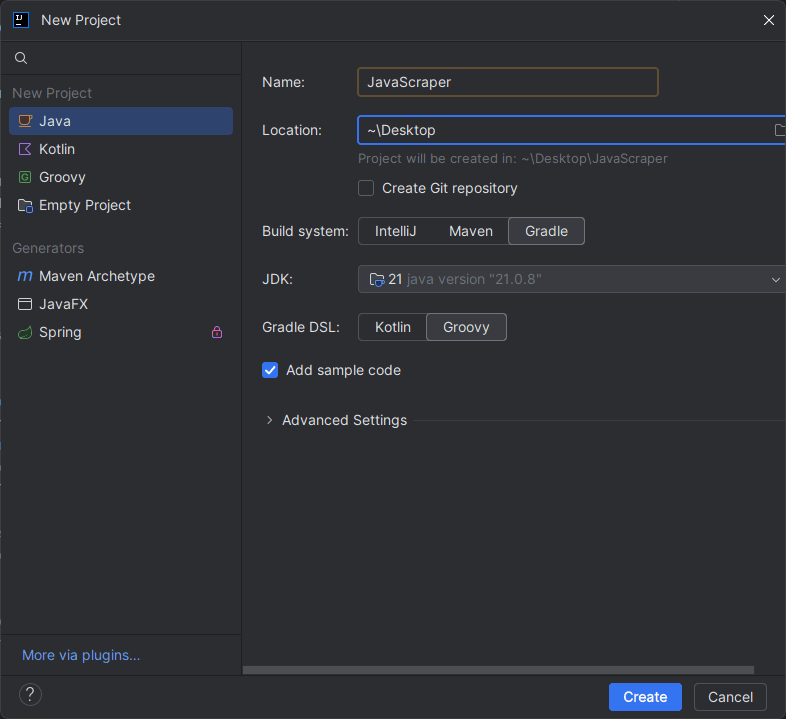
第 3 步:配置项目设置
设置:
- 名称:JavaScraper
- 位置:桌面
- 构建系统:选择 Gradle
- JDK:确认为您之前安装的版本,Oracle OpenJDK 21
- Gradle DSL:选择 Groovy,它更为简单
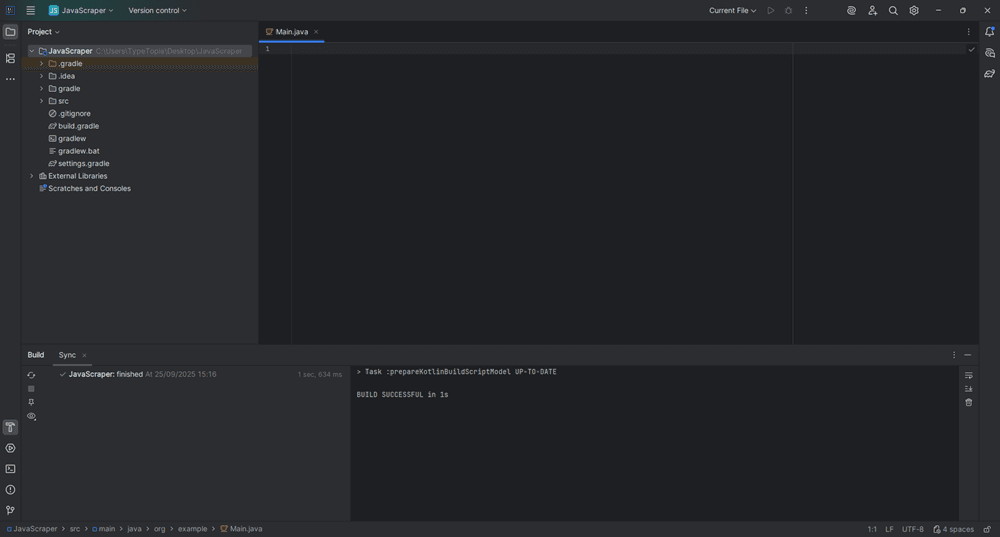
第 4 步:创建项目
点击“Create”。
第 5 步:准备添加依赖
现在可以开始编写代码了。
第 6 步:将 Jsoup 添加到 build.gradle
在屏幕左上方的 Project 区域中,找到名为“build.gradle”的文件(带有 Gradle 图标),点击打开。
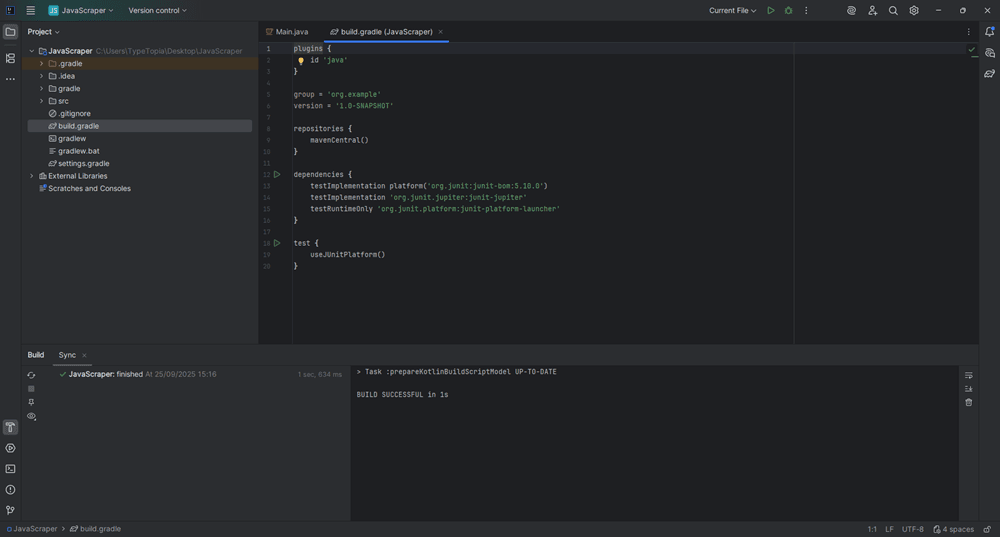
将代码替换为以下内容:
plugins {
    id 'java'
}

group = 'com.tutorial'
version = '1.0'

repositories {
    mavenCentral()
}

dependencies {
    implementation 'org.jsoup:jsoup:1.15.3'
}
第 7 步:同步 Gradle 项目
在左下角点击“Sync now”图标以更新项目。
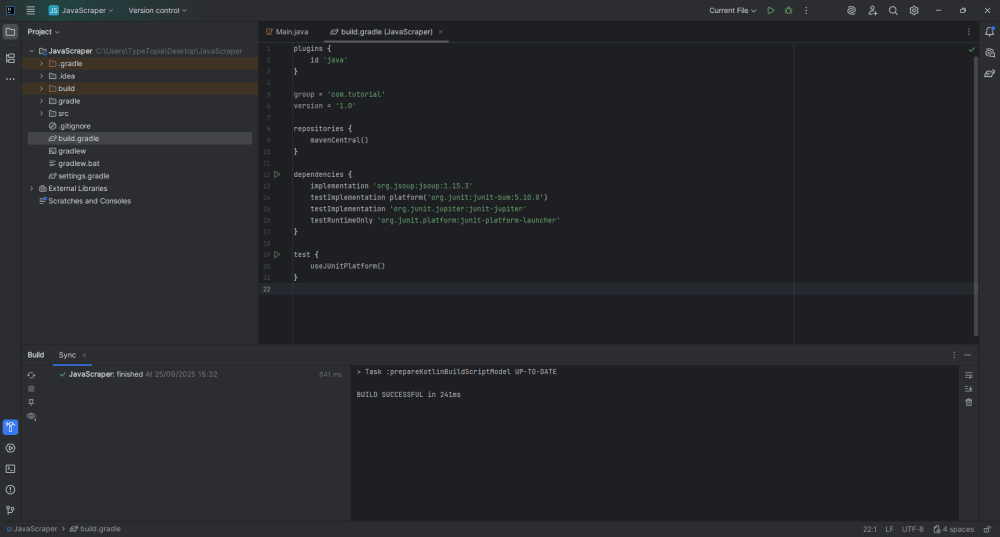
Gradle 会下载依赖,并在构建成功后提示您。至此,您已成功安装 Jsoup,可用于抓取静态内容。
使用 Selenium 处理动态内容
在抓取静态页面时,Jsoup 表现出色:它能获取 HTML 数据,并通过元素选择器干净地完成解析。但它的能力也就止于此——由于 Jsoup 不会执行 JavaScript,也不会跟踪 DOM 变化,因此它只能解析初始 HTML,无法获取在加载过程中后续渲染出的元素。
因此,如果要抓取的页面是动态加载数据的,仅靠 Jsoup 无法完成任务,这时 Selenium 就必不可少。它是一种完整的浏览器自动化工具,能让您的 Java 爬虫控制真实浏览器或无头浏览器。
Selenium 可以模拟以下用户行为:
- 滚动页面
- 点击按钮
- 提交表单
- 等待 AJAX 请求完成
- 获取原始源代码中不存在的内容数据
对于动态网站而言,这是实现稳定 Java 网络爬取的唯一方式。Selenium 同时支持 Chrome 和 Firefox,通过 WebDriver API 与 Java 无缝集成,并能与 Jsoup 等其他 Java 网络爬取库配合使用,在同一抓取流程中同时处理静态与动态内容。
安装 Selenium
第 1 步:打开 build.gradle
在 IntelliJ IDEA 左上方的 Project Tool Window 中,找到并打开 build.gradle(旁边带有 Gradle 图标)。
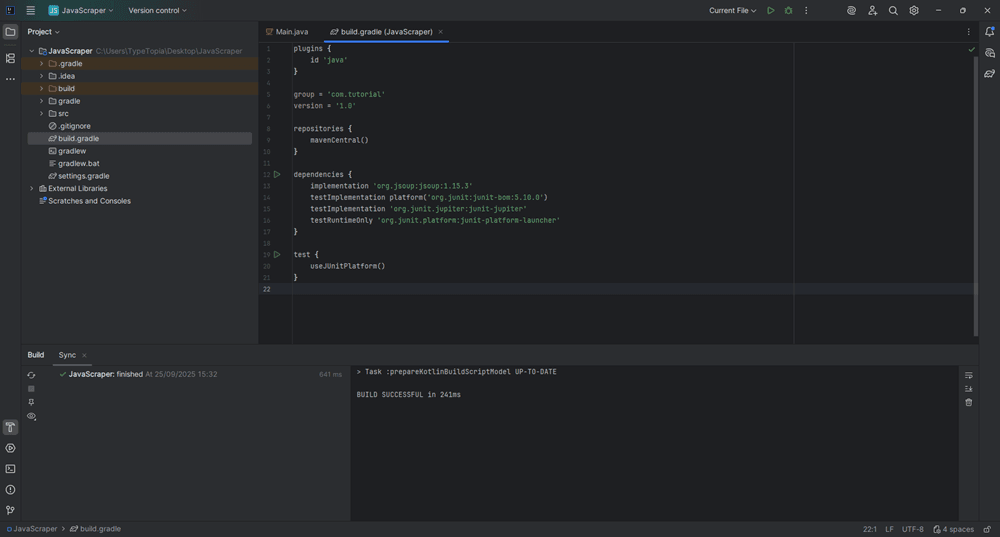
第 2 步:添加 Selenium 和 WebDriverManager 依赖
接下来,滚动到 dependencies 代码块中并添加以下内容:
implementation 'org.seleniumhq.selenium:selenium-java:4.21.0'
implementation 'io.github.bonigarcia:webdrivermanager:5.8.0'
此时您的代码应如下所示:
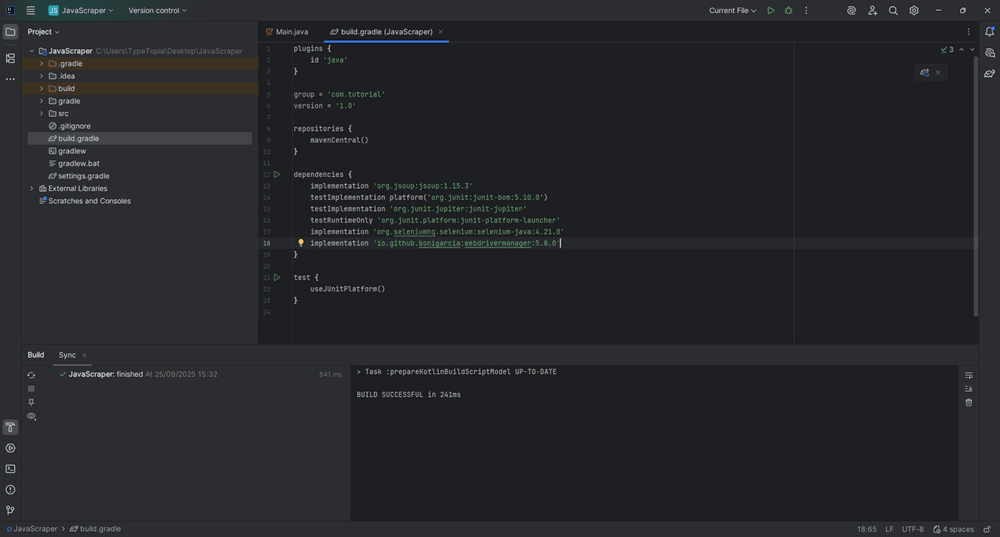
第 3 步:同步 Gradle 项目
点击“Sync”按钮,让 Gradle 下载 Selenium。
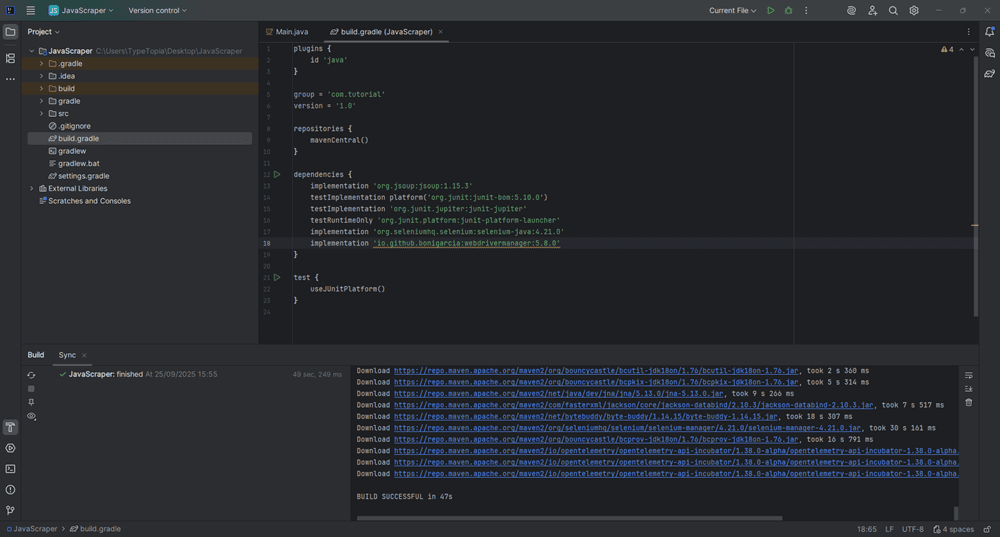
至此,本教程将用到的两款 Java 网络爬取工具已全部安装完成。
主流 Java 网络爬取库对比
到目前为止,您已经了解了如何配置 Jsoup 和 Selenium。但 Java 的选择远不止这两种。以下是几款主流 Java 网络爬取库的详细对比,以及各自适用的场景。
- Jsoup
适合静态 HTML 的数据抓取,速度快、使用直观,在数据已包含在初始页面加载内容中时表现出色。您可以通过元素选择器提取数据,轻松处理 HTML 内容。但它无法执行 JavaScript,也无法等待动态元素加载,因此不适用于依赖大量 JavaScript 的页面。
- HtmlUnit
HtmlUnit 模拟无头浏览器,并支持轻量级 JavaScript 处理,适用于不依赖复杂前端逻辑的简单动态网站。不过,它在应对现代 Web 架构时表现欠佳,对新 API 的支持也有限,可以将其理解为一个轻量级模拟器,而非完整浏览器。
- Selenium
当涉及动态内容时,Selenium 就变得不可或缺。它能启动真实浏览器或无头浏览器,让您的网络爬虫像真实用户一样与页面进行交互,是从 JavaScript 渲染页面或单页应用(SPA)中提取数据的常用工具。
- WebMagic
如果您要构建可扩展的网络爬虫或分布式爬虫,WebMagic 值得了解。它支持配置页面处理器、线程池、重试逻辑、处理管道以及调度流程。
下表对比了上文介绍的几款 Java 网络爬取库:
适用于数据已包含在页面源代码中、无需 JS 即可呈现的场景。
通过元素选择器解析静态 HTML,适合结构清晰的页面,抓取速度快。
无法渲染或与 JavaScript 交互,也无法加载动态内容。
适用于抓取博客文章、产品列表、公开表格或基于站点地图的页面。
适用于需要轻量级 JS 支持、但不想承担 Selenium 全部开销的场景。
可执行部分 JavaScript,在不打开界面的情况下模拟无头浏览器。
在应对现代 SPA、重度依赖 AJAX 的网站及复杂前端 JS 时表现欠佳。
适用于登录表单、小型动态网站,或交互较轻的旧版应用。
适用于网站需要加载、滚动、点击或等待 JS 渲染后数据才会出现的场景。
可完全控制浏览器,能模拟用户操作、等待元素加载,并处理 SPA 页面。
速度较慢,资源占用较高,需要良好的代理和反封锁策略配合。
适用于抓取实时价格、JS 密集型页面、无限滚动信息流,或 React、Vue 等 SPA。
适用于构建具备复杂逻辑、重试机制、大规模运行的多页面爬虫的场景。
内置处理管道、处理器、重试机制、代理支持与多线程功能。
存在一定学习成本,实际页面交互仍需接入 Jsoup 或 Selenium 完成。
适用于构建新闻网站、电商商品目录、潜在客户列表的爬虫,或抓取数千个 URL。
按 Enter 键创建该文件。该文件保存的是您的爬虫在抓取 Hacker News 时将轮换使用的住宅代理列表。真实案例:抓取博客文章
现在,有了目前为止搭建的全部环境,我们可以正式开始使用 Java 进行网络爬取了。接下来我们将从Hacker News抓取数据——这是一家由 Y Combinator 创建并维护、专注于科技新闻聚合的网站。我们的目标是借助轮换代理,提取博客风格文章的标题、链接和时间戳。
步骤一:在 IntelliJ IDEA 中创建新项目
打开 IntelliJ IDEA,创建一个新项目
设置以下选项:
- 位置:选择您喜欢的文件夹(例如桌面)
- 构建系统:Gradle
- 语言:Java
- 项目 SDK:JDK 21
- Gradle DSL:Groovy
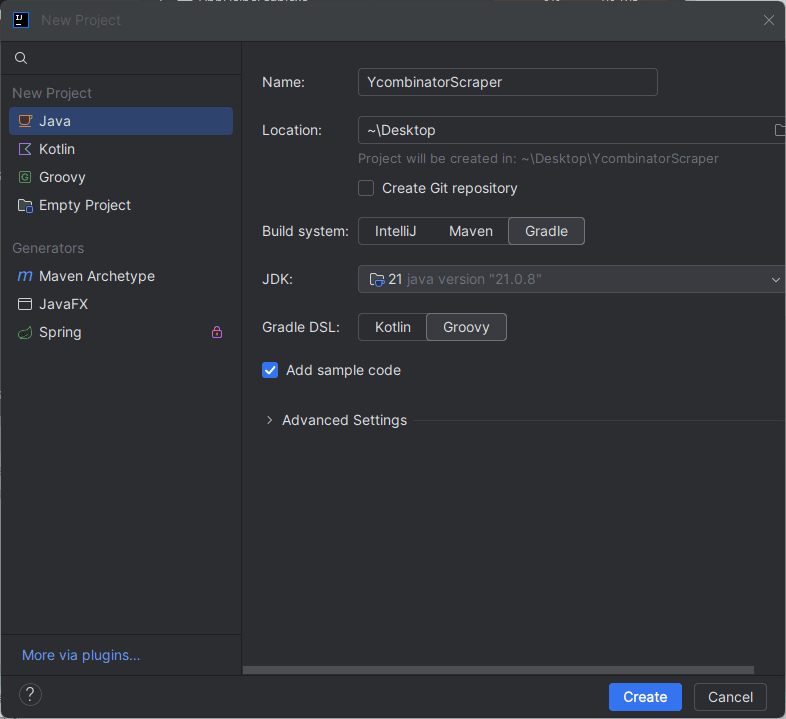
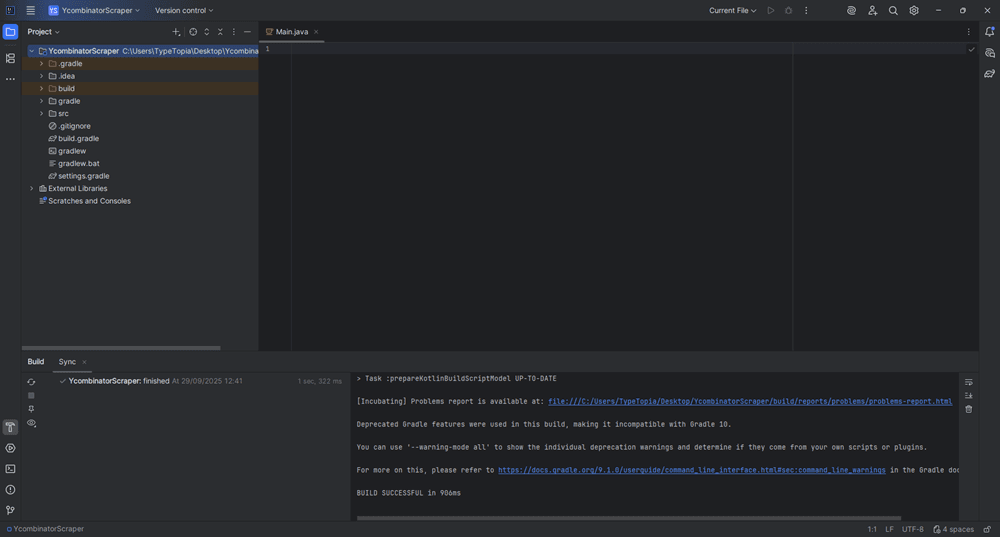
点击“Create”生成项目,随后会跳转到以下界面:
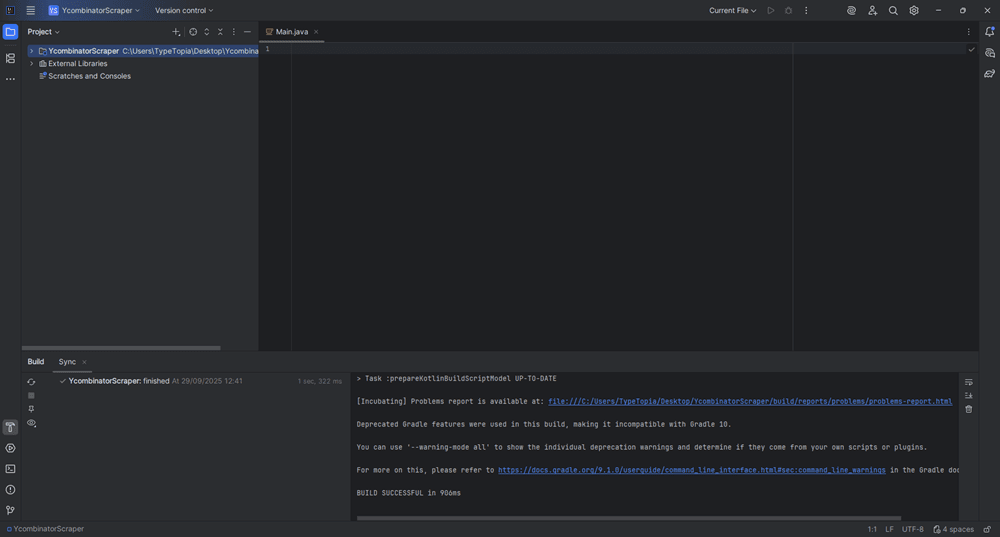
步骤二:查看项目结构
在 Project 工具窗口中,展开 YcombinatorScraper 文件夹即可查看包结构
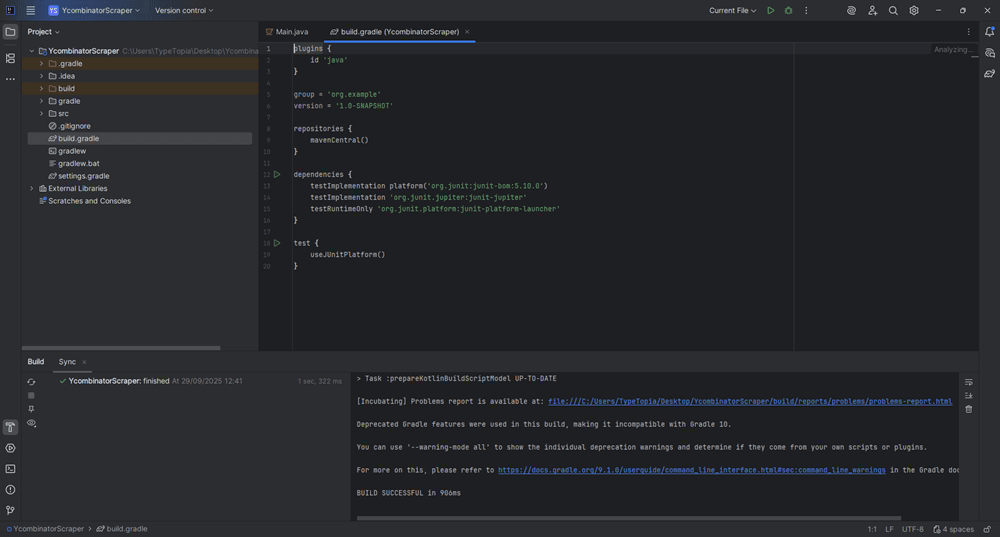
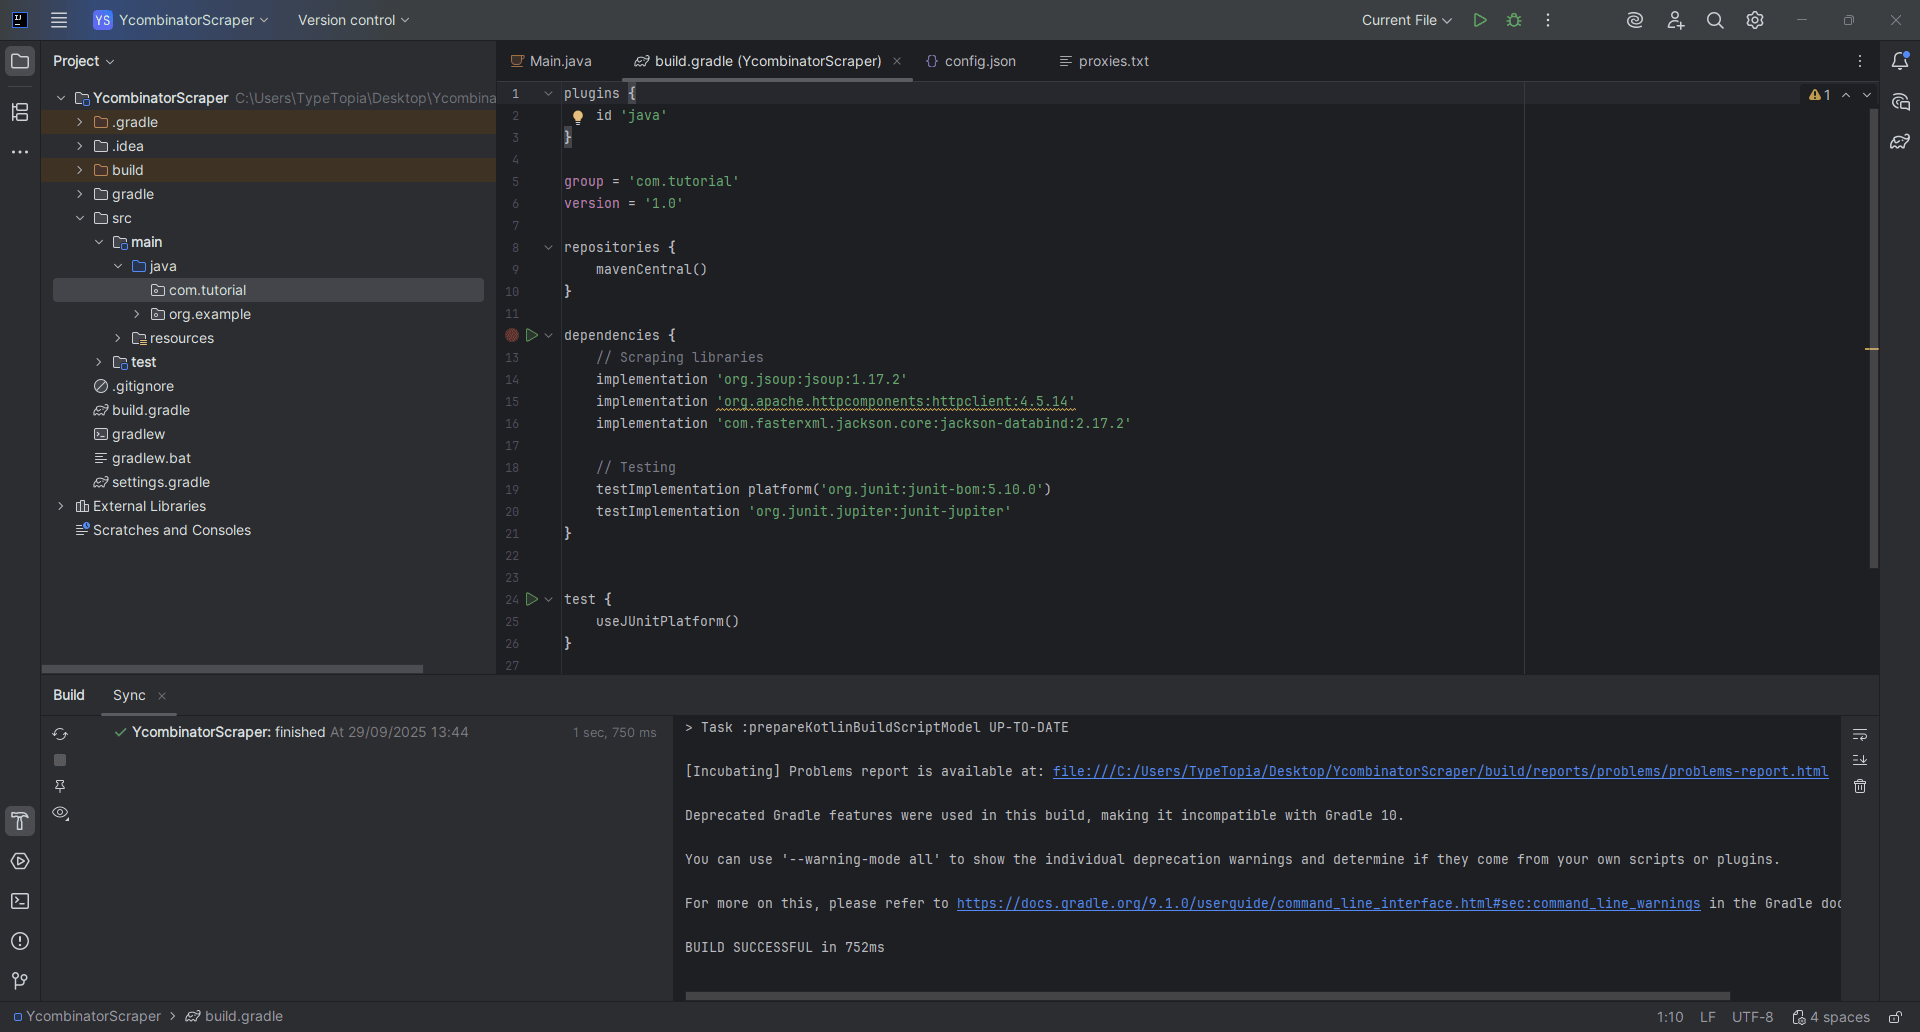
步骤三:打开 build.gradle 文件
在项目根目录下找到并打开 build.gradle
步骤四:添加核心依赖库
我们将为项目添加三个关键依赖库:
- Jsoup:负责解析并抓取目标网站的 HTML
- Apache HttpClient:支持对 HTTP 请求进行精细控制(请求头、代理、身份验证)
- Jackson Databind:用于读写 JSON 文件,例如配置文件和代理设置
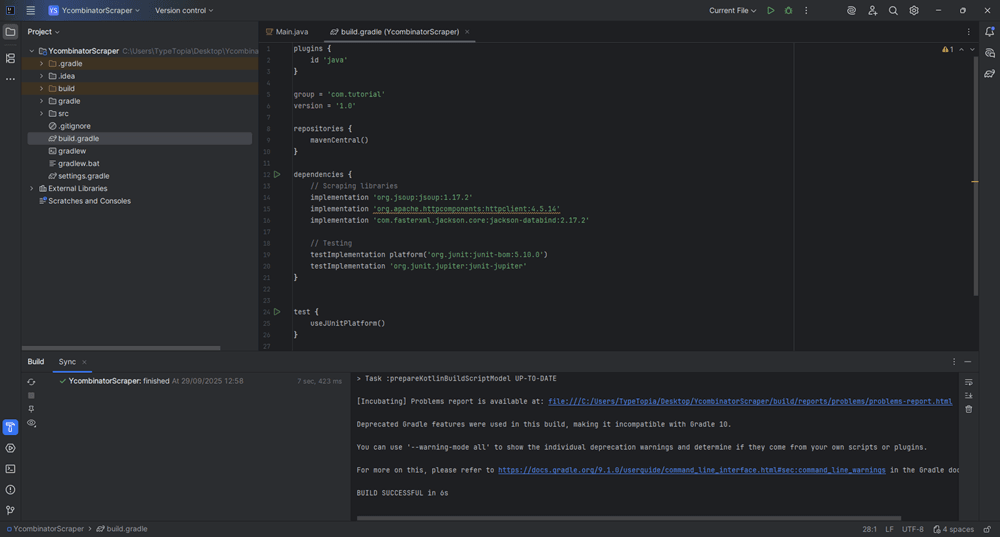
将 build.gradle 的内容替换为:
plugins {
    id 'java'
}

group = 'com.tutorial'
version = '1.0'

repositories {
    mavenCentral()
}

dependencies {
    // Scraping libraries
    implementation 'org.jsoup:jsoup:1.17.2'
    implementation 'org.apache.httpcomponents:httpclient:4.5.14'
    implementation 'com.fasterxml.jackson.core:jackson-databind:2.17.2'
    // Testing
    testImplementation platform('org.junit:junit-bom:5.10.0')
    testImplementation 'org.junit.jupiter:junit-jupiter'
}
test {
    useJUnitPlatform()
}
步骤五:同步 Gradle
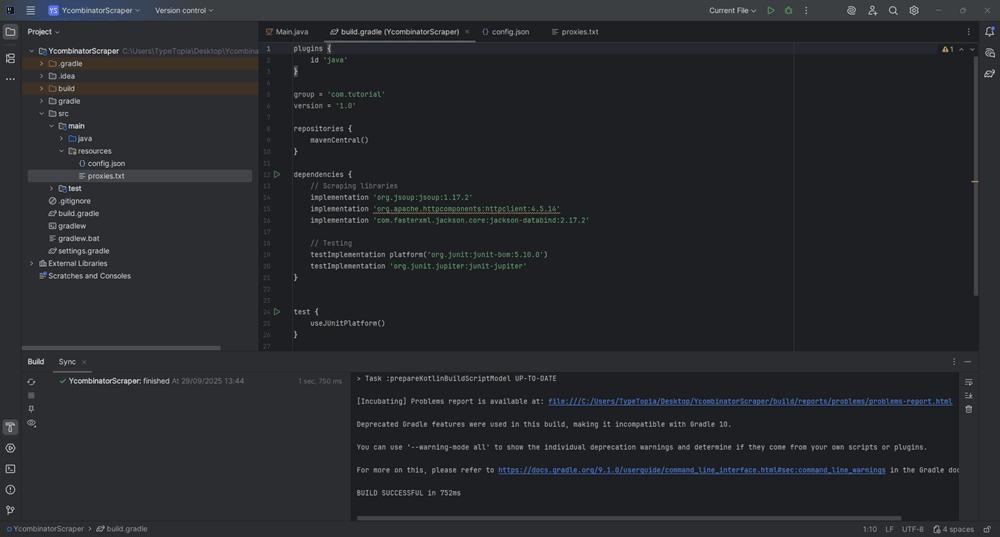
点击右下角 Build 工具窗口中的“Sync”图标,随后应会看到“BUILD SUCCESSFUL”提示
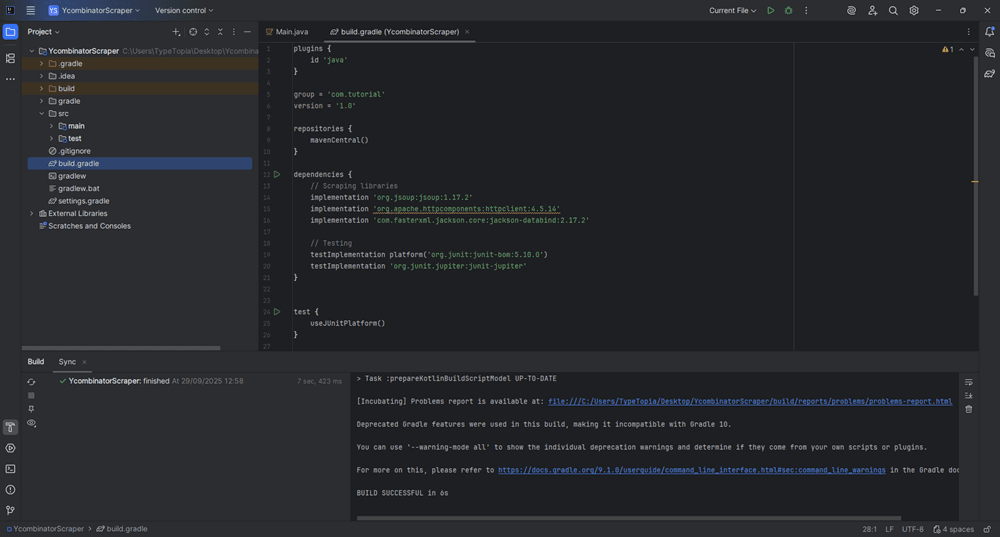
步骤六:展开 src 文件夹
在左侧的 Project 工具窗口中展开 src 文件夹,即可查看其内容
步骤七:找到 main 目录
点击 main 旁边的箭头将其展开,即可看到以下子文件夹:
- java
- resources
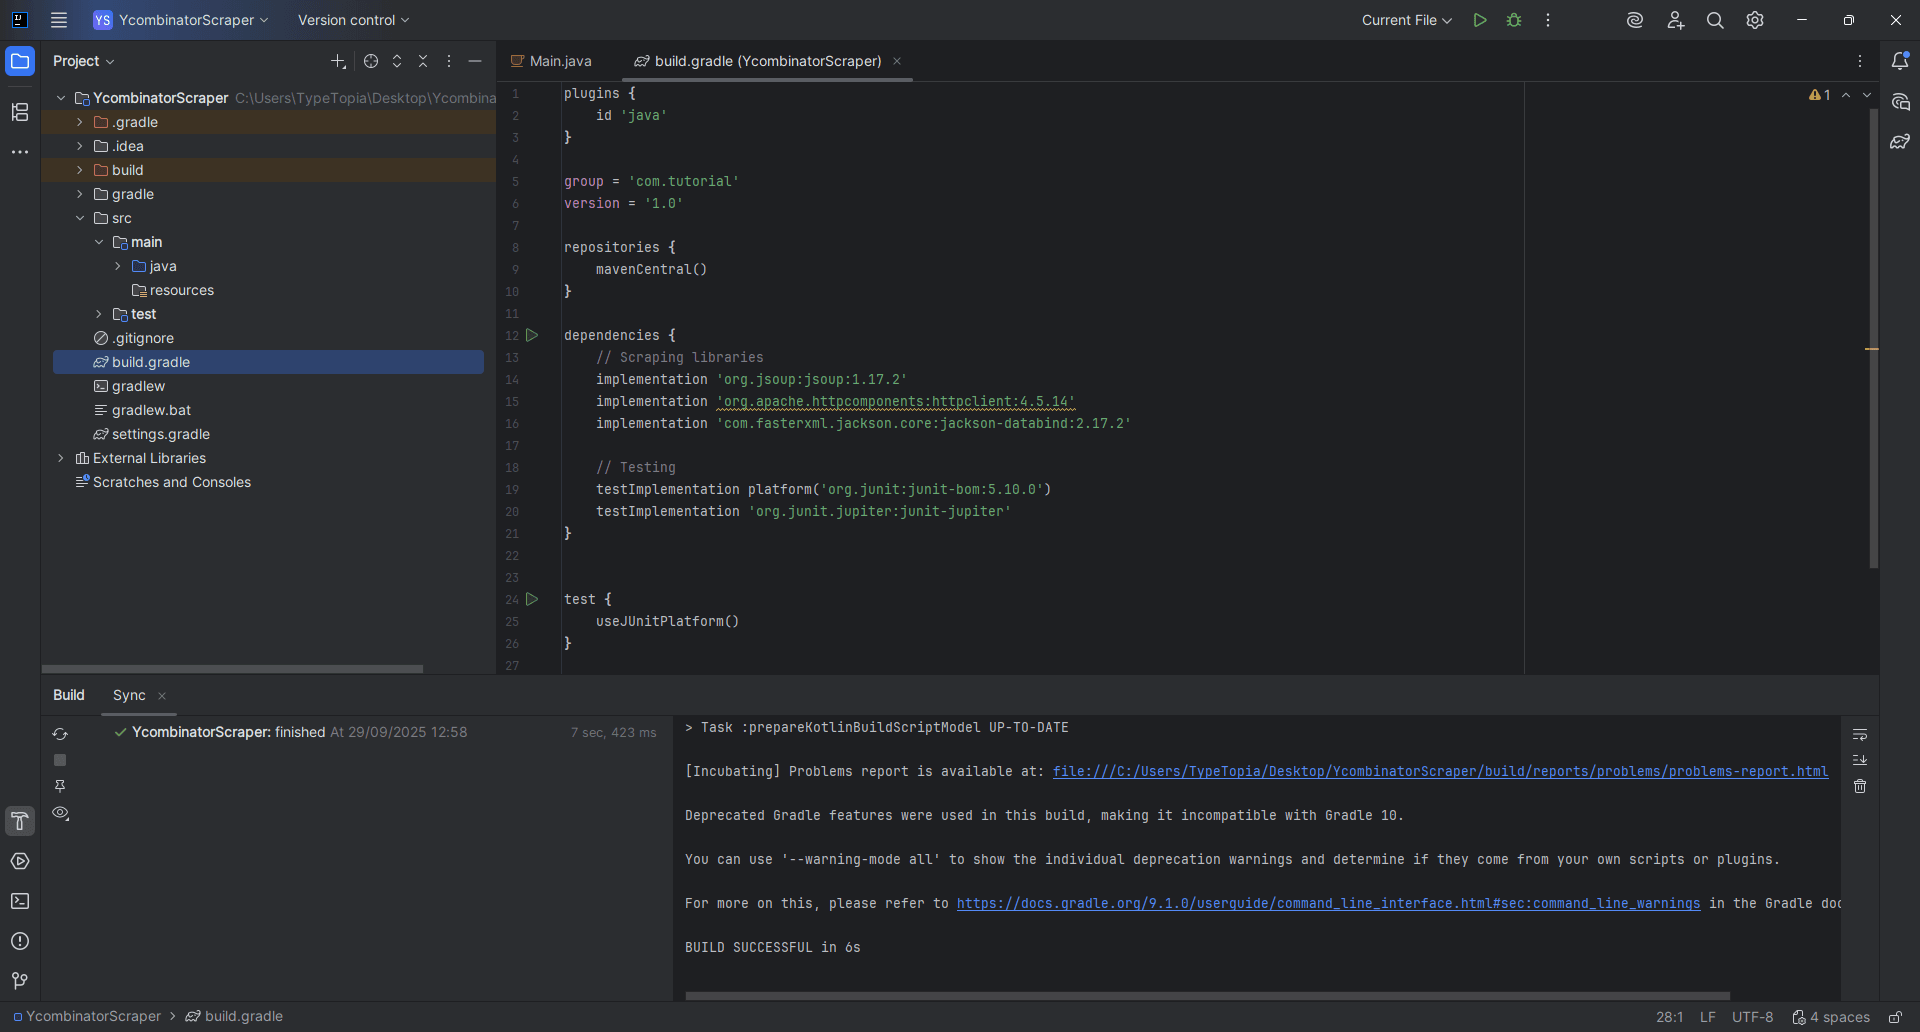
步骤八:打开 resources 文件夹
右键点击“resources”文件夹
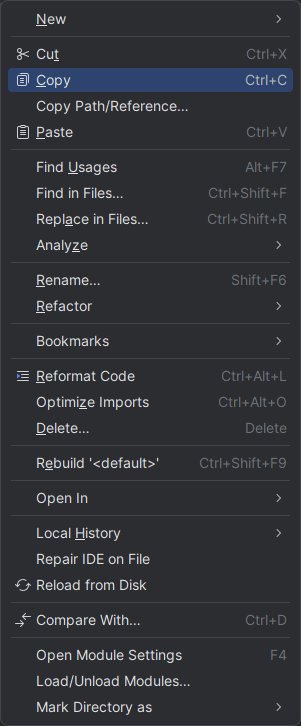
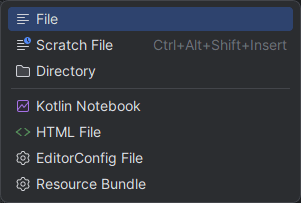
步骤九:新建文件
将鼠标悬停在“New”上,然后在下拉菜单中点击“File”
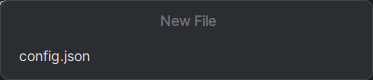
步骤十:将文件命名为 config.json
将文件命名为:
步骤十一:添加爬虫配置
在新建的 config.json 文件中添加以下内容:
{
  "startUrl": "https://news.ycombinator.com/",
  "pages": 3,
  "minDelayMs": 1200,
  "maxDelayMs": 2500,
  "retries": 3,
  "output": "hn_results.csv",
  "userAgent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36 OrinaScraper/1.0"
}
config.json 文件相当于爬虫的核心配置,其中定义了:
- 要抓取的网站(startUrl)
- 要爬取的页数(pages)
- 请求之间的等待时间(minDelayMs 和 maxDelayMs)
- 页面请求失败时的重试次数(retries)
- 结果的保存位置(output)
- 爬虫的身份标识方式(userAgent)
您可以随时调整这些设置以改变爬虫的行为,而无需修改 Java 代码
步骤十二:创建代理文件
再次右键点击 resources 文件夹,重复相同的步骤:
- 将鼠标悬停在“New”上
- 点击“File”
- 将文件命名为:
proxies.txt
按 Enter 键创建该文件。该文件保存了您的爬虫在抓取 Hacker News 时将轮换使用的住宅代理列表。
步骤十三:添加代理条目
这里我们使用来自 MarsProxies 的五个经过身份验证的住宅代理,每个代理都有不同的位置和会话 ID:
ultra.marsproxies.com:44443:mr45184psO8:MKRYlpZgSa_country-us_city-losangeles_session-j1ko4q46_lifetime-30m
ultra.marsproxies.com:44443:mr45184psO8:MKRYlpZgSa_country-us_state-alaska_session-v750sry6_lifetime-30m
ultra.marsproxies.com:44443:mr45184psO8:MKRYlpZgSa_country-us_state-kansas_session-afxhhuv5_lifetime-30m
ultra.marsproxies.com:44443:mr45184psO8:MKRYlpZgSa_country-us_state-maryland_session-u8sgsjv6_lifetime-30m
ultra.marsproxies.com:44443:mr45184psO8:MKRYlpZgSa_country-us_city-oakland_session-qlzwp7xo_lifetime-30m
想了解更多信息,请参阅本指南,了解如何使用 MarsProxies 住宅代理。此外,您还可以在此购买住宅 IP 代理。
步骤十四:再次同步 Gradle
此时,resources 文件夹中应已包含两个文件:
- config.json:定义爬虫设置
- proxies.txt:保存代理凭证
回到右下角的 Build 工具窗口,再次点击“sync”图标;如果一切正常,IntelliJ 会显示:BUILD SUCCESSFUL
步骤十五:准备添加 Java 代码
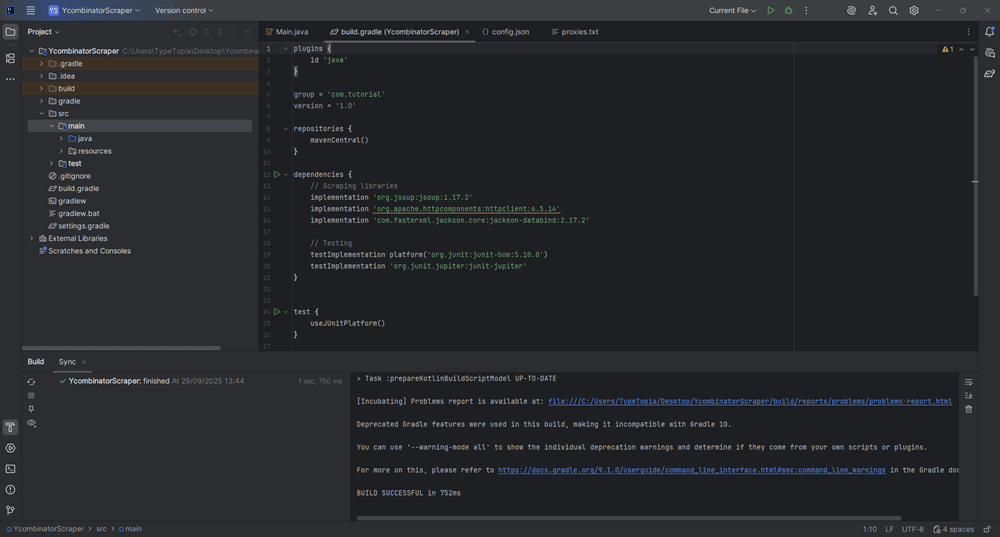
现在 config.json 和 proxies.txt 文件都已就绪,接下来可以接入实际的抓取逻辑了。首先新建一个 Java 类
在 Project 工具窗口中展开“main”:
步骤十六:创建新包
右键点击“java”以显示选项
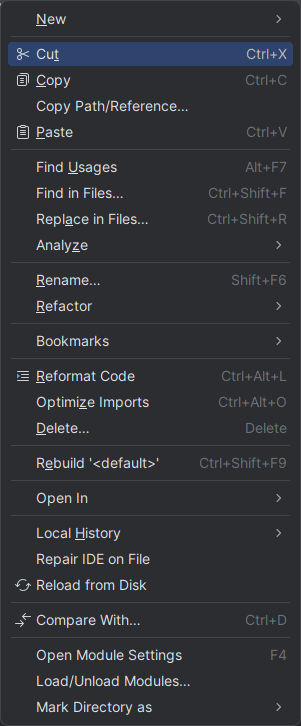
点击“New”,然后选择“Package”
将新包命名为:
com.tutorial
此时,java 目录下应已出现一个新包
步骤十七:添加新的 Java 类
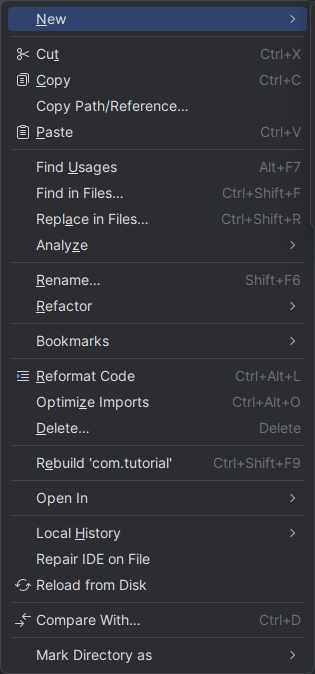
右键点击新建的 com.tutorial 包
步骤十八:为类命名
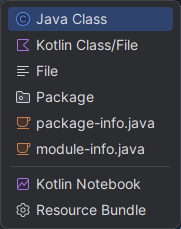
将鼠标悬停在“New”上,即可看到以下下拉菜单:
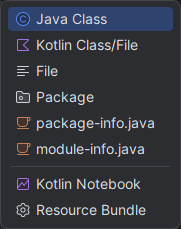
选择“Java Class”,并将新类命名为:
Ycombinatorblogpostextractor
步骤十九:添加爬虫代码
将完整的 HackerNewsScraper 类粘贴到新建的 Java 文件中,其中包含配置处理、代理支持、抓取逻辑以及各类工具函数
package com.tutorial;
import com.fasterxml.jackson.databind.JsonNode;
import com.fasterxml.jackson.databind.ObjectMapper;
import org.apache.http.HttpHost;
import org.apache.http.auth.AuthScope;
import org.apache.http.auth.UsernamePasswordCredentials;
import org.apache.http.client.CredentialsProvider;
import org.apache.http.client.methods.CloseableHttpResponse;
import org.apache.http.client.methods.HttpGet;
import org.apache.http.impl.client.BasicCredentialsProvider;
import org.apache.http.impl.client.CloseableHttpClient;
import org.apache.http.impl.client.HttpClients;
import org.apache.http.impl.conn.DefaultProxyRoutePlanner;
import org.apache.http.util.EntityUtils;
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.nodes.Element;

import java.io.*;
import java.nio.charset.StandardCharsets;
import java.security.SecureRandom;
import java.util.*;
import java.util.concurrent.ThreadLocalRandom;
import java.util.concurrent.atomic.AtomicInteger;
import java.util.stream.Collectors;

public class HackerNewsScraper {
    // Config
    static class Config {
        String startUrl;
        int pages;
        int minDelayMs;
        int maxDelayMs;
        int retries;
        String output;
        String userAgent;
    }

    // Proxy entry
    static class ProxyEntry {
        final String host;
        final int port;
        final String username;
        final String password; // may include session + geo tokens (keep as-is)
        final String label;

        ProxyEntry(String host, int port, String username, String password, String label) {
            this.host = host; this.port = port; this.username = username; this.password = password; this.label = label;
        }

        static ProxyEntry parse(String line) {
            // Expect format host:port:user:passWithSessionAndFlags
            String[] parts = line.trim().split(":", 4);
            if (parts.length < 4) throw new IllegalArgumentException("Bad proxy line: " + line);
            String host = parts[0];
            int port = Integer.parseInt(parts[1]);
            String user = parts[2];
            String pass = parts[3];
            // derive a short label from any _city- or _state- token if present
            String label = "proxy";
            int cityIdx = pass.indexOf("_city-");
            int stateIdx = pass.indexOf("_state-");
            if (cityIdx >= 0) {
                String rest = pass.substring(cityIdx + 6);
                label = rest.split("[_\\s]")[0];
            } else if (stateIdx >= 0) {
                String rest = pass.substring(stateIdx + 7);
                label = rest.split("[_\\s]")[0];
            }

            return new ProxyEntry(host, port, user, pass, label);
        }
    }

    private final Config cfg;
    private final List<ProxyEntry> proxies;
    private final AtomicInteger rr = new AtomicInteger(0);
    private final SecureRandom rng = new SecureRandom();

    public HackerNewsScraper(Config cfg, List<ProxyEntry> proxies) {
        this.cfg = cfg; this.proxies = proxies;
        if (proxies.isEmpty()) throw new IllegalStateException("No proxies loaded");
    }

    public static void main(String[] args) throws Exception {
        Config cfg = loadConfig();
        List<ProxyEntry> proxies = loadProxies();
        HackerNewsScraper app = new HackerNewsScraper(cfg, proxies);
        app.scrape();
    }

    private void scrape() throws Exception {
        try (PrintWriter out = new PrintWriter(new OutputStreamWriter(new FileOutputStream(cfg.output), StandardCharsets.UTF_8)))
            out.println("postId,rank,title,link,timeText,timeISO,commentsCount,commentsUrl");

            String url = cfg.startUrl;
            for (int p = 1; p <= cfg.pages; p++) {
                Document doc = getWithRetries(url);
                if (doc == null) throw new IOException("Failed to fetch: " + url);

                // Parse items on the page
                for (Element row : doc.select("tr.athing")) {
                    String postId = row.attr("data-id").trim();

                    // HN uses <span class="titleline"><a ...> now; keep fallback for .storylink
                    Element titleA = Optional.ofNullable(row.selectFirst("span.titleline > a"))
                            .orElse(row.selectFirst(".storylink"));
                    if (titleA == null) continue;
                    String title = titleA.text();
                    String link = titleA.attr("href");

                    Element metaRow = row.nextElementSibling();
                    String timeText = "";
                    String timeISO = "";
                    int commentsCount = 0;
                    String commentsUrl = "";

                    if (metaRow != null) {
                        Element sub = metaRow.selectFirst(".subtext");
                        if (sub != null) {
                            Element age = sub.selectFirst(".age a");
                            if (age != null) {
                                timeText = age.text();
                                // 'title' attribute contains absolute time (e.g., 2025-09-29T08:12:34)
                                timeISO = age.attr("title");
                            }
                            List<Element> itemLinks = sub.select("a[href^=item?id]");
                            if (!itemLinks.isEmpty()) {
                                Element c = itemLinks.get(itemLinks.size() - 1);
                                commentsUrl = abs("https://news.ycombinator.com/", c.attr("href"));
                                String txt = c.text();
                                if (txt.matches(".*\\d+.*")) {
                                    String digits = txt.replaceAll("\\D+", "");
                                    if (!digits.isEmpty()) commentsCount = Integer.parseInt(digits);
                                } else {
                                    commentsCount = 0; // "discuss"
                                }
                            }
                        }
                    }

                    String rank = row.selectFirst("span.rank") != null ? row.selectFirst("span.rank").text() : "";
                    out.printf(Locale.ROOT,
                            "%s,%s,\"%s\",%s,%s,%s,%d,%s%n",
                            csv(postId), csv(rank), csv(title), csv(link), csv(timeText), csv(timeISO), commentsCount, csv(commentsUrl));
                }

                // Find pagination (More)
                Element more = doc.selectFirst("a.morelink");
                if (p < cfg.pages && more != null) {
                    url = abs(cfg.startUrl, more.attr("href"));
                    sleepJitter(cfg.minDelayMs, cfg.maxDelayMs);
                } else {
                    break;
                }
            }
        }
        System.out.println("Done. Wrote " + cfg.output);
    }

    // --- Networking with rotating proxies ---
    private Document getWithRetries(String url) {
        int attempts = 0;
        while (attempts < cfg.retries) {
            ProxyEntry px = pickProxy();
            try {
                Document d = fetchViaProxy(px, url);
                if (d != null) return d;
            } catch (Exception e) {
                // log and fall through to retry with next proxy
                System.err.println("[WARN] " + px.label + " failed: " + e.getMessage());
            }
            attempts++;
            sleep(cfg.minDelayMs + 400L);
        }
        return null;
    }

    private ProxyEntry pickProxy() {
        int i = Math.floorMod(rr.getAndIncrement(), proxies.size());
        return proxies.get(i);
    }

    private Document fetchViaProxy(ProxyEntry px, String url) throws Exception {
        CredentialsProvider credsProvider = new BasicCredentialsProvider();
        credsProvider.setCredentials(new AuthScope(px.host, px.port), new UsernamePasswordCredentials(px.username, px.password));

        HttpHost proxy = new HttpHost(px.host, px.port);
        DefaultProxyRoutePlanner routePlanner = new DefaultProxyRoutePlanner(proxy);

        try (CloseableHttpClient client = HttpClients.custom()
                .setDefaultCredentialsProvider(credsProvider)
                .setRoutePlanner(routePlanner)
                .build()) {

            HttpGet get = new HttpGet(url);
            get.setHeader("User-Agent", cfg.userAgent);
            get.setHeader("Accept", "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8");
            get.setHeader("Accept-Encoding", "gzip, deflate");
            get.setHeader("Accept-Language", "en-US,en;q=0.9");

            try (CloseableHttpResponse resp = client.execute(get)) {
                int status = resp.getStatusLine().getStatusCode();
                if (status >= 200 && status < 300) {
                    String html = EntityUtils.toString(resp.getEntity(), StandardCharsets.UTF_8);
                    return Jsoup.parse(html, url);
                }
                throw new IOException("HTTP " + status);
            }
        }
    }

    // --- Utilities ---
    private static String abs(String base, String href) {
        try { return new java.net.URL(new java.net.URL(base), href).toString(); }
        catch (Exception e) { return href; }
    }

    private static String csv(String s) {
        if (s == null) return "";
        String t = s.replace("\"", "\"\"");
        if (t.contains(",") || t.contains("\n") || t.contains("\"")) return '"' + t + '"';
        return t;
    }

    private void sleepJitter(int minMs, int maxMs) {
        int delta = Math.max(0, maxMs - minMs);
        int wait = minMs + (delta == 0 ? 0 : ThreadLocalRandom.current().nextInt(delta));
        sleep(wait);
    }

    private void sleep(long ms) {
        try { Thread.sleep(ms); } catch (InterruptedException ignored) { }
    }

    private static Config loadConfig() throws IOException {
        ObjectMapper om = new ObjectMapper();
        try (InputStream in = HackerNewsScraper.class.getClassLoader().getResourceAsStream("config.json")) {
            if (in == null) throw new FileNotFoundException("config.json not found in resources");
            JsonNode node = om.readTree(in);
            Config c = new Config();
            c.startUrl = node.get("startUrl").asText();
            c.pages = node.get("pages").asInt(1);
            c.minDelayMs = node.get("minDelayMs").asInt(1200);
            c.maxDelayMs = node.get("maxDelayMs").asInt(2500);
            c.retries = node.get("retries").asInt(3);
            c.output = node.get("output").asText("hn_results.csv");
            c.userAgent = node.get("userAgent").asText("Mozilla/5.0 OrinaScraper");
            return c;
        }
    }

    private static List<ProxyEntry> loadProxies() throws IOException {
        InputStream in = HackerNewsScraper.class.getClassLoader().getResourceAsStream("proxies.txt");
        if (in == null) throw new FileNotFoundException("proxies.txt not found in resources");
        List<String> lines;
        try (BufferedReader br = new BufferedReader(new InputStreamReader(in, StandardCharsets.UTF_8))) {
            lines = br.lines().map(String::trim).filter(s -> !s.isEmpty() && !s.startsWith("#")).collect(Collectors.toList());
        }
        List<ProxyEntry> list = new ArrayList<>();
        for (String line : lines) list.add(ProxyEntry.parse(line));
        return list;
    }
}
接下来我们花点时间了解这个 Java 类的工作原理
包声明
代码的第一行,
package com.tutorial;
定义了这个类所属的 Java 包,用于告诉编译器和 IntelliJ 在 src/main/java/com/tutorial 文件夹中查找该文件的位置。这也是我们之前创建这层嵌套文件夹的原因:包名必须与文件夹结构保持一致。
导入语句
接下来是导入语句。Java 要求您显式声明所使用的每一个外部类,这与 Python 不同——在 Python 中,一次导入往往就能引入整个模块。在这个爬虫中,我们导入了:
- Jackson(JsonNode、ObjectMapper):读取 config.json,并将其字段转换为可用的 Java 对象
- Apache HttpClient(HttpHost、AuthScope、CredentialsProvider 等):构建 HTTP 请求、设置请求头,并通过代理转发流量
- Jsoup(Jsoup、Document、Element):解析 Hacker News 返回的 HTML,以便提取标题、时间戳和评论
- Java 标准库类:涉及输入输出、字符集、随机数、线程安全计数器,以及用于管理状态的集合类
这些导入共同为爬虫提供了所需的全部工具
内部辅助类:Config 和 ProxyEntry
接下来这部分代码定义了两个内部辅助类。第一个是 Config,它将 config.json 中的核心设置整合为一个 Java 对象
其中包含起始 URL、抓取页数、请求间隔延迟、重试次数、输出文件名以及 User-Agent 字符串等字段。将这些字段统一封装在一个类中,可以让配置数据在整个爬虫中保持结构化且易于访问。
随后我们定义了 ProxyEntry 类,用于表示单个代理服务器。proxies.txt 中的每一行都会被解析为该类的实例,并拆分为主机、端口、用户名、密码和标签字段。
该标签会根据密码字符串中包含的城市或州信息自动生成,便于在轮换连接时识别当前使用的是哪个代理
持久变量与构造函数
定义完辅助类之后,爬虫会创建两个持久变量:一个用于保存配置,另一个用于保存代理。cfg 字段保存了从 config.json 加载的全部设置,包括起始 URL、延迟时间、重试次数和输出文件。
爬虫不会每次都重新读取文件获取数值,而是将所有内容保存在内存中并直接引用 cfg,代理的处理方式与此相同
proxies.txt 中的每一行只需解析一次,便会以 ProxyEntry 对象的形式存入 proxies 列表,使代理轮换过程更加流畅。加载完爬虫配置和代理列表后,程序会将这些值传入构造函数完成初始化。
主方法与抓取循环
接下来,main() 方法通过调用 scrape() 触发整个抓取流程。该方法首先打开一个 CSV 写入器并创建表头行,然后从基础 URL 开始,按照配置中指定的页数进行循环处理。
对于每一页,程序会调用 getWithRetries() 尝试下载 HTML,该方法负责处理代理轮换和重试逻辑。请求成功后,爬虫会解析每篇文章,提取帖子 ID、标题、链接、时间戳和评论元数据,并将这些信息写入 CSV 文件。
如果检测到“More”链接,爬虫会将下一页加入队列,应用一段随机等待时间后继续执行;如果链接不存在或已达到页数上限,循环就会结束。处理完所有页面后,CSV 文件会完成写入,程序随后打印“Done”消息以确认抓取完成。
使用轮换代理进行网络请求
每次需要获取页面时,getWithRetries 都会按照配置中设定的固定次数进行尝试。它以轮询方式从代理池中选取代理,避免某个代理被过度使用,然后调用 fetchViaProxy 发送 HTTP 请求。
Apache HttpClient 负责管理代理凭证和路由,Jsoup 则将返回的 HTML 解析为可用的 Document 对象。通过将这些步骤分离,爬虫把网络与代理逻辑同解析逻辑区分开来,使主抓取循环更加简洁可靠。
工具函数
最后,爬虫还依赖一些小型辅助函数:
- abs():将相对链接转换为绝对 URL
- csv():格式化字符串,确保 CSV 输出安全
- sleepJitter() 和 sleep():在请求之间添加随机等待时间或固定等待
- loadConfig():读取 config.json 并构建 Config 对象
- loadProxies():读取 proxies.txt,并将每一行转换为一个 ProxyEntry 对象
这些工具函数处理着幕后的各种细节,让页面导航保持可靠、输出保持安全,并使请求行为更接近真实用户
步骤二十:运行代码
要运行爬虫,请查看 IntelliJ IDEA 窗口顶部,当前打开文件旁边会有一个绿色的运行按钮,点击即可编译并执行程序中的 main() 方法
IntelliJ 会使用之前添加的配置文件和代理文件启动爬虫,并开始将结果写入 config.json 中指定的输出 CSV 文件
步骤二十一:验证抓取结果
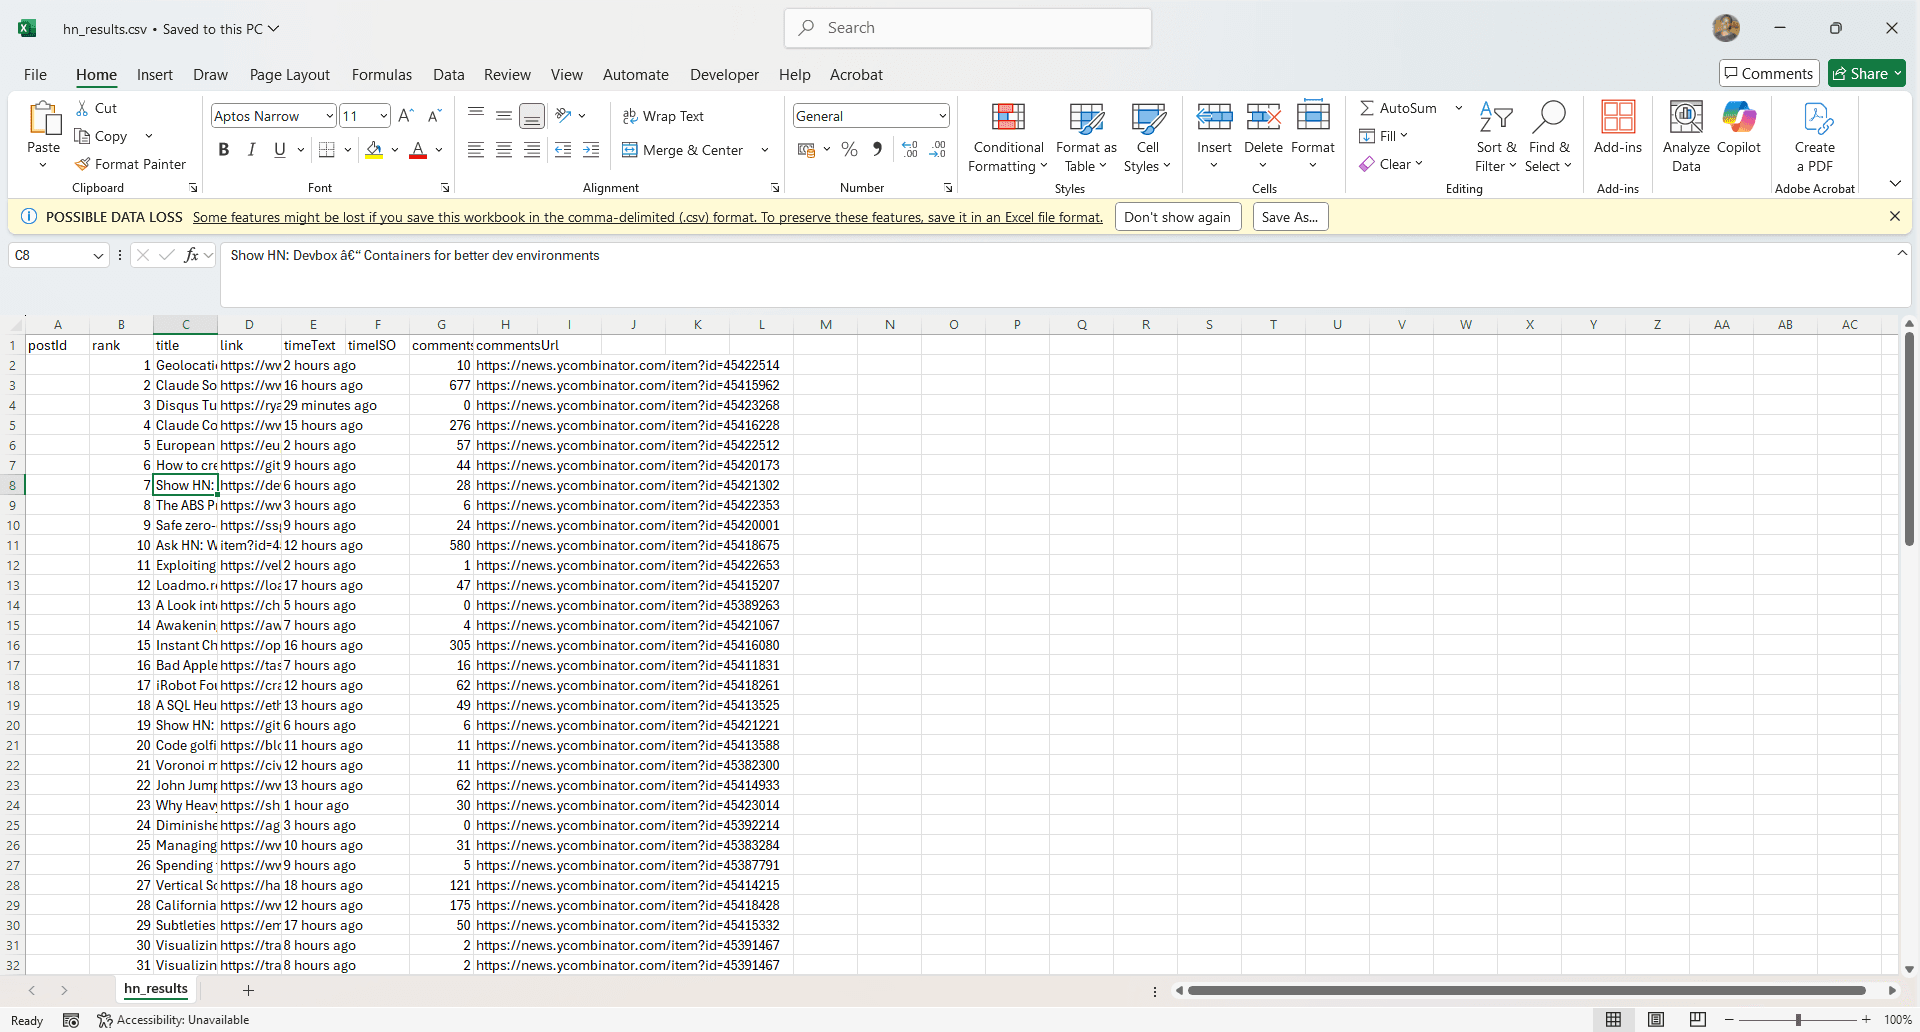
运行爬虫后,打开项目保存的文件夹,您应该会看到一个名为 hn_results.csv 的文件,其中包含本次抓取会话的原始输出结果
打开该文件后,您会看到 Hacker News 上每篇博客风格的文章都按列整理,包括:
- 帖子 ID
- 排名、标题
- 直接链接
- 相对时间
- ISO 时间戳
- 评论数量
- 评论链接
如果这些数值均符合预期,就说明您的爬虫运行正常
规范做法与合规须知
现在您已经掌握了如何用 Java 构建完全自定义的爬虫,无论是使用 Jsoup 处理静态 HTML,还是使用 Selenium 处理动态内容。但面对防护严格、反爬机制较强的页面时,Java 的处理效率不及 Python——Python 应对这类任务时摩擦更少,配套库也更简洁。
即便使用 Java,轮换代理和 User-Agent 依然是降低被封锁概率的良好实践。前面编写的代码已包含基础错误处理机制,可在请求失败时自动重试,避免整个流程崩溃。
但仅靠技术手段还不够,还应遵循合规的数据抓取原则:始终尊重网站的 robots.txt 文件,避免抓取明确禁止访问的页面数据。
最后的建议与要点
到这里就讲完了。如果您已经读到这里,说明您已经掌握了如何用 Java 构建爬虫程序、它在哪些场景下表现出色,以及什么时候改用 Python 更合适。
Java 并非快速原型开发的首选工具,但在企业系统内部工作,或大规模抓取结构化数据(尤其是来自旧系统的数据)时,它具备切实的优势。只需清楚了解它能做什么、不能做什么,务实地加以运用即可。
想了解更多 Java 数据抓取技巧?欢迎加入我们的Discord 社区
在 Java 数据抓取中,如何管理会话 Cookie 与身份认证?
使用能够在多次请求之间保留 Cookie 的 HTTP 客户端,例如搭配 CookieStore 的 Apache HttpClient,或搭配 CookieJar 的 OkHttp。先通过 POST 提交登录凭据及所有隐藏字段完成登录,捕获 Set-Cookie 请求头,或让客户端自动保存,然后在后续请求中复用同一客户端或 Cookie 上下文,使服务器能够识别您的会话。
在使用 Java 进行数据抓取时,如何绕过 CAPTCHA?
较为实用的方法是使用 Selenium 等无头浏览器渲染页面,再接入第三方 CAPTCHA 识别 API(例如 2Captcha 或 Anti-Captcha):将 site key 和页面 URL 发送给识别服务,轮询获取 token,并在提交前将该 token 注入页面或表单。对于图片类 CAPTCHA,则需截取图片并发送给识别服务,再应用返回的识别结果。
在 Java 中,数据抓取与网络爬取有什么区别?
数据抓取是指从一组页面中提取结构化数据,而网络爬取则是通过跟踪链接来发现并获取页面。Java 中的数据抓取程序通常使用 Jsoup 或 HttpClient 获取已知 URL 并处理 HTML;而爬虫程序还需加入 URL 管理、去重(使用集合或布隆过滤器)、合规控制(robots.txt、速率限制),以及调度或分布式工作节点等机制。
在 Java 数据抓取中,如何处理分页与无限滚动?
对于数字分页或偏移量分页,可识别其 URL 规律并通过程序循环遍历,使用 Jsoup 或 HTTP 客户端逐页获取内容,并重复解析相同的选择器。
在 Java 数据抓取中,如何模拟浏览器行为(请求头、延迟、鼠标移动)?
首先在每个请求中匹配常见的请求头和 Origin 字段,并在合适的情况下轮换 User-Agent。使用 ThreadLocalRandom 在操作之间添加随机等待时间和抖动,避免固定的时间模式,同时遵守 robots.txt 与速率限制,保持合规。