如何绕过 reCAPTCHA v3(2026 年指南)
Google 推出的 reCAPTCHA v3 是一种在后台静默运行的隐形 CAPTCHA,与 v2 不同,它不再显示可供用户解答的可见验证挑战,而是根据用户行为给出风险评分,以判断该操作是否合法。
但您连看都看不到,又该如何绕过它呢?
在本文中,我们将详细拆解 reCAPTCHA v3 的工作原理、为何隐形验证码更难绕过,以及绕过 reCAPTCHA v3 的实用方法。
不过,使用 Puppeteer 绕过 CAPTCHA用于非法或恶意目的会违反道德和法律规范,本教程仅用于学习交流,我们建议您查看目标网站的服务条款,以避免法律风险。
reCAPTCHA v3 是什么?为何难以绕过?
reCAPTCHA v3 是 Google 推出的成熟隐形 CAPTCHA 技术,它在后台静默运行,通过监测鼠标移动、点击、打字节奏,乃至浏览器和设备特征等信息,判断用户是否为真人。
reCAPTCHA v3 不会像可见验证码那样让用户手动解答或借助 reCAPTCHA 解析工具完成,而是在后台对每一次交互进行评估,并立即拦截未通过检测的请求。
v3 与 v2 有何不同?
reCAPTCHA v3 将关注点从拦截机器人转向了风险分析,Google 不再宣称自己能够区分人类流量与机器人流量,而是向您的后端返回一个介于 0.0 到 1.0 之间的风险评分,以及其他元数据。
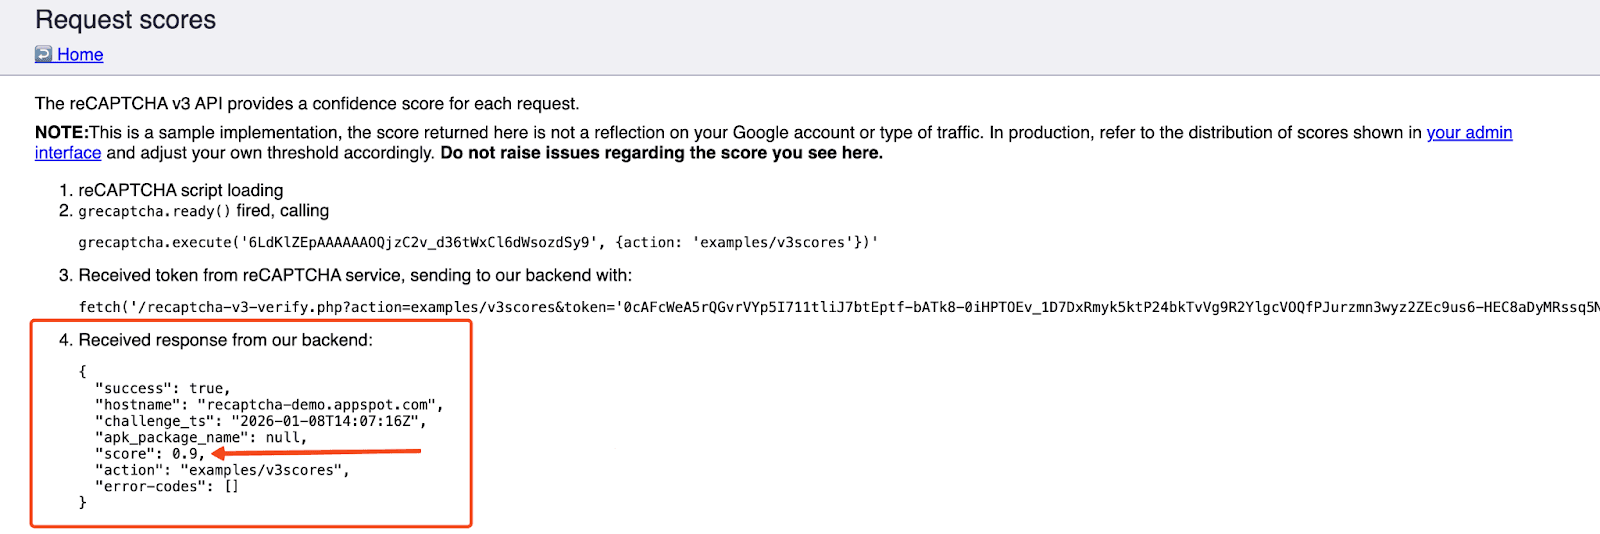
- 0.0 =极有可能是机器人
- 1.0 =很可能是合法用户
网站收到该评分后,会据此决定是否放行用户,或要求进一步验证。
v3 为何难以绕过
绕过 v3 之所以如此困难,原因如下:
- 没有可见的验证挑战——不存在拼图或弹窗,因此抓取工具的行为必须足够接近真人才能获得较高评分
- 通过阈值由网站所有者自行设定——每个网站都有各自的通过分数,因此在一个网站上有效的方法未必适用于另一个网站
- 失败时没有明确反馈——您看不到任何错误提示,请求会被拦截或在不知不觉中被重定向
- 对整体环境进行评估——reCAPTCHA v3 会结合行为、指纹和 IP 信誉对整个会话进行评分
绕过 reCAPTCHA v3 的方法
本文介绍几种行之有效的方法和工具,可以让抓取工具在各个方面都更接近真实用户,从而绕过 reCAPTCHA v3:
1. 使用真实浏览器与隐身自动化工具
成功绕过 reCAPTCHA 的第一条原则,就是让自动化行为尽可能接近真实用户,这意味着应使用真实浏览器,而非仅发送基础 HTTP 请求。
Selenium、Puppeteer、Playwright 等工具都支持 JavaScript 渲染,这一点对于不依赖 reCAPTCHA 解析工具绕过 reCAPTCHA v3 而言非常重要。
然而,仅以默认模式运行这些工具还远远不够。Google 可以轻松识别常见的自动化模式,例如navigator.webdriver标记或缺失的浏览器特征,因此开发者通常会叠加使用隐身层,例如:
- puppeteer-extra-plugin-stealth(Puppeteer)
- undetected-chromedriver(Python/Selenium)
- Playwright 的隐身模式插件
这些工具通过修改插件、canvas 数据、请求头等信息来隐藏自动化指纹,隐身脚本与指纹修改通常在浏览器环境中以 JavaScript 实现,以更好地模拟真实用户环境。
此外,还应加入一些更接近真实用户行为的交互,例如适当延迟、滚动页面、打字速度变化等,以降低被检测的概率。
优点:
- 对真人行为的模拟程度较高
- 获得较高 reCAPTCHA 评分的可能性较大
- 支持完整的 JavaScript 执行
缺点:
- 占用较多 CPU 和内存资源
- 需要持续更新以应对检测手段的升级
- 速度比简单的请求式抓取更慢
2. 使用住宅代理绕过 CAPTCHA
reCAPTCHA v3 还会根据 HTTP 请求中的 IP 和 ASN 信息做出判断。
如果该 IP 存在不良历史记录,或属于已知的数据中心、云服务器地址,就更容易被判定为机器人流量。为提高成功绕过 reCAPTCHA 的概率,建议使用高质量的住宅 IP。
需要注意的是,干净的 IP 无法挽救行为本身像机器人的程序,但可以避免基于 IP 的拦截,并为其提供更好的初始信誉。
许多 CAPTCHA 解析服务商也建议在处理 v3 任务时使用自己的代理,因为 IP 质量会显著影响返回的评分。
优点:
- 真实用户 IP 有助于提升信任度
- 有助于避免基于 IP 的拦截
- 与浏览器自动化配合效果良好
缺点:
- 单独使用效果有限
- 低质量 IP 会损害信誉
3. 使用 CAPTCHA 解析服务
如果您的方案仍然获得较低评分,可以尝试使用专门的 CAPTCHA 解析工具,市面上有许多 CAPTCHA 解析公司和服务,宣称能够自动解决 reCAPTCHA v3。
2Captcha、CapSolver、Anti-Captcha 等平台都提供 API,可以在其自有的浏览器集群上生成有效令牌,从而自动解决 reCAPTCHA v3。
当自身方案无法获得足够高的评分时,这类服务可以作为有效的备用方案,但并非完美无缺,尤其是在大规模抓取场景下。
优点:
- 可通过简单的 API 调用轻松集成
- 当 reCAPTCHA v3 评分过低时,是不错的备用方案
- 支持多种 CAPTCHA 类型,包括 reCAPTCHA v2 的回退验证
缺点:
- 成本可能会不断累积
- 需要进行配置并管理 API 密钥
- 仍然依赖 IP 质量
4. 组合使用多种技术
没有任何单一技术能够在所有情况下轻松绕过 reCAPTCHA v3,更可靠的方案往往会综合运用上述所有工具。
若 IP 信誉较差,单独使用隐身浏览器仍可能被判定为可疑;若浏览器行为呈机械化特征,单独使用代理也无济于事;单独使用解析服务虽能通过验证,但成本会迅速增加。而将这些技术结合起来,则能相互补充、相互强化,使整套方案在表现和行为上更接近真实用户。
提示:如需了解更多内容,请参阅我们的详细指南——绕过 CAPTCHA 的 10 个实用技巧。
优点:
- 可弥补单一方法的不足
- 更适合长期稳定的抓取工作
缺点:
- 搭建和维护的复杂度更高
- 资源消耗较大
如何绕过 reCAPTCHA v3
应让抓取工具更好地融入环境,使其行为更接近真人,而非明显的脚本。
环境要求
开始之前,请确保已满足或安装以下条件:
- Python 3.9+
- Playwright(用于浏览器自动化)
- BeautifulSoup + lxml(用于解析)
- 高质量住宅代理(来自 MarsProxies)
- 具备基础的 Python 知识
搭建虚拟环境
下载并安装 Python:如果尚未安装,请前往 Python 官方网站完成安装,然后再创建虚拟环境
python -m venv venv
执行以下命令以激活 Python 虚拟环境:
# for Windows
venv\Scripts\activate

# macOS / Linux
source venv/bin/activate
安装所需的库
pip install playwright beautifulsoup4 lxml
创建虚拟环境可以为您提供一个独立的环境,用于安装所需的全部工具。Playwright 还会自动下载 Chromium、Firefox 和 WebKit 浏览器。
第1步:确认目标网站使用的是 reCAPTCHA v3
可以通过以下方式检查目标网站是否确实使用了 reCAPTCHA v3:
- 在 Chrome 中打开该网站
- 打开开发者工具(按 F12)
- 切换到 Network 标签
- 刷新页面
- 筛选出与 reCAPTCHA 相关的网络请求
如果该网站使用了 reCAPTCHA v3,通常会看到类似以下 URL 的请求:
https://www.google.com/recaptcha/api.js?render=...
如果没有出现任何结果,说明该页面很可能没有使用 reCAPTCHA v3。本示例中,我们将抓取Lulu and Georgia网站的家具促销页面。
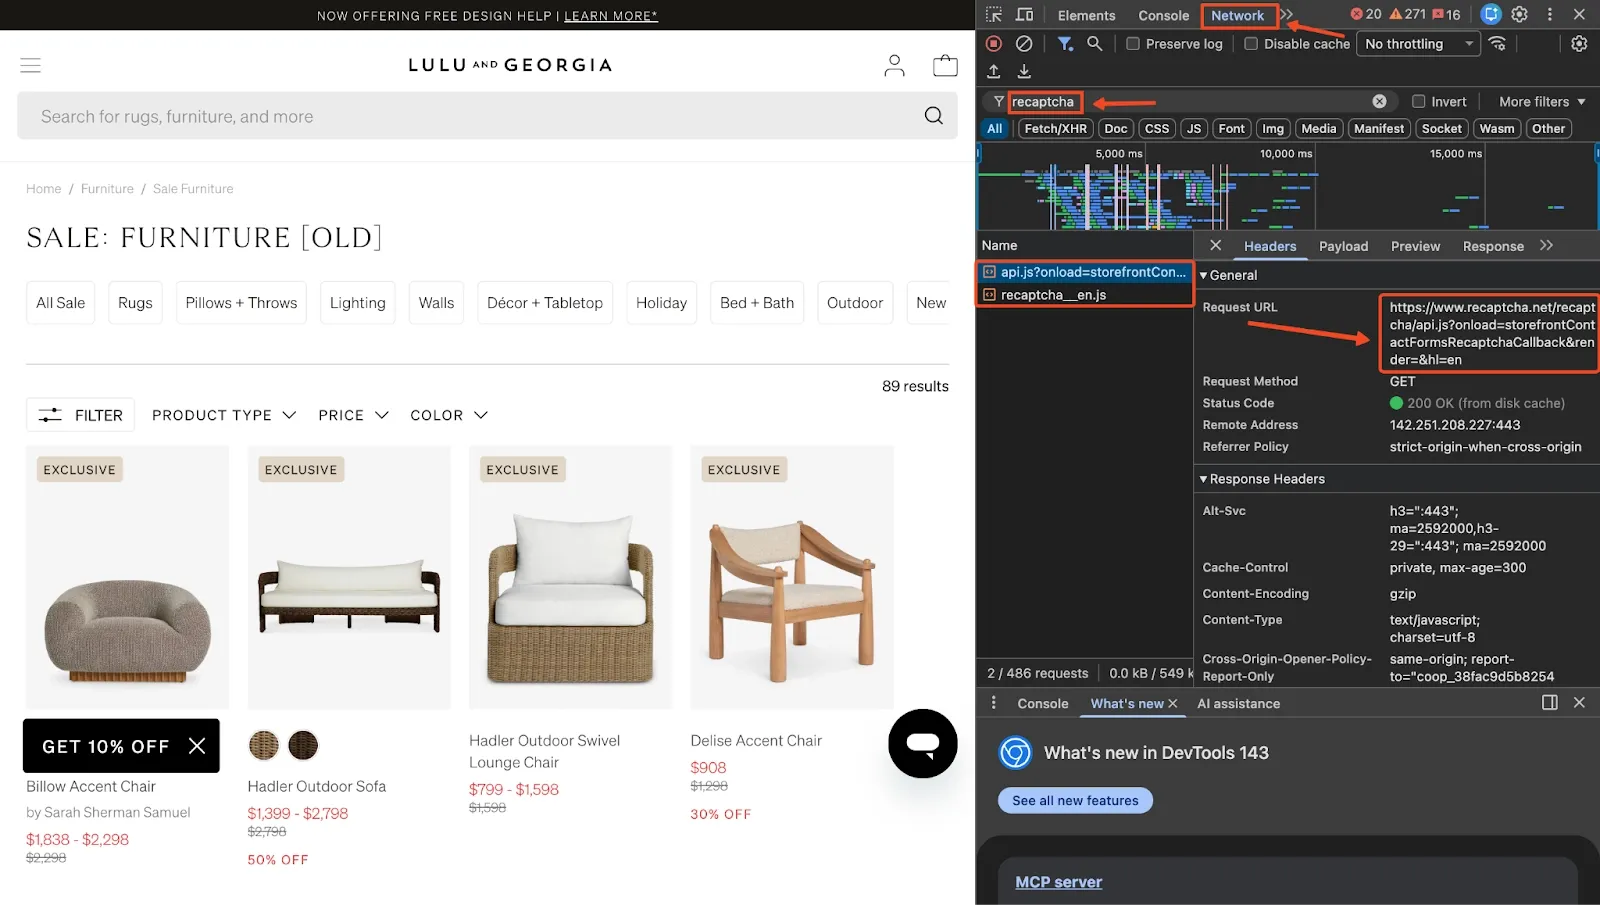
查看网络日志后可以发现,页面在刷新后会加载 reCAPTCHA 脚本,这说明该网站确实使用了 reCAPTCHA v3。因此,我们的浏览器自动化需要表现得更自然,并通过干净的住宅 IP 进行请求。
第2步:导入所需的库并定义核心变量
首先导入所需模块,并定义待抓取的 URL。
import asyncio
import random
from playwright.async_api import async_playwright
from bs4 import BeautifulSoup
接下来,定义目标页面:
TARGET_URL = "https://www.luluandgeorgia.com/collections/sale-furniture-1"
这正是我们此前确认包含 reCAPTCHA v3 请求的页面,我们将抓取促销页面中展示的家具商品。
此时,项目已拥有清晰的入口以及后续抓取流程所需的全部共享依赖。
第3步:添加住宅代理(推荐使用 MarsProxies)
为避免 reCAPTCHA 评分过低,您需要使用高质量的住宅 IP,reCAPTCHA v3 对 IP 信誉非常敏感,干净的住宅代理可以让您获得更高的初始评分。
将代理信息添加到脚本中。
PROXIES = [
    "mr10478lWc5:MlXBxpEKLa_country-us_state-california@ultra.marsproxies.com:44443",
    "mr10478lWc5:MlXBxpEKLa_country-us_state-california@ultra.marsproxies.com:44443",
    "mr10478lWc5:MlXBxpEKLa_country-us_state-california@ultra.marsproxies.com:44443",
]
然后创建一个辅助函数,以 Playwright 所需的格式随机返回一个代理:
def get_proxy():
    proxy = random.choice(PROXIES)
    auth, server = proxy.rsplit("@", 1)
    user, pwd = auth.split(":", 1)
    host, port = server.split(":")
    return {
        "server": f"http://{host}:{port}",
        "username": user,
        "password": pwd,
    }
这样可以确保每次抓取会话都来自真实的住宅 IP,而不是容易被 Google 立即识别的数据中心地址。
第4步:加入隐身处理与基础人类行为模拟
接下来要让浏览器看起来不那么像自动化程序,而更接近真实用户的环境,这正是隐身补丁与简单行为模拟发挥作用的地方。
async def apply_stealth(page):

    await page.add_init_script("""
        Object.defineProperty(navigator, 'webdriver', { get: () => undefined });
        Object.defineProperty(navigator, 'plugins', {
            get: () => [
                { name: 'Chrome PDF Plugin' },
                { name: 'Chrome PDF Viewer' },
                { name: 'Native Client' }
            ]
        });
        Object.defineProperty(navigator, 'languages', { get: () => ['en-US', 'en'] });
        window.chrome = { runtime: {} };

        const originalQuery = window.navigator.permissions.query;
        window.navigator.permissions.query = (params) => (
            params.name === 'notifications'
                ? Promise.resolve({ state: Notification.permission })
                : originalQuery(params)
        );
    """)
该函数会隐藏navigator.webdriver属性,降低页面检测到浏览器自动化的可能性。随后我们还会添加一些虚拟插件和语言设置,使其更接近常规的 Chrome 安装环境。
之后,可以模拟一些“杂乱”的人类交互行为:
async def simulate_human(page):
    # Random mouse movements
    for _ in range(random.randint(2, 4)):
        await page.mouse.move(
            random.randint(100, 800),
            random.randint(100, 500)
        )
        await asyncio.sleep(random.uniform(0.1, 0.3))

    # Scroll down gradually
    for _ in range(3):
        await page.evaluate(
            f"window.scrollBy(0, {random.randint(200, 400)})"
        )
        await asyncio.sleep(random.uniform(0.3, 0.7))
    # Small pause and scroll back up
    await asyncio.sleep(random.uniform(0.6, 1.6))
    await page.evaluate("window.scrollTo(0, 0)")
    await asyncio.sleep(random.uniform(0.3, 0.5))
这里并不需要完美还原真人操作,只需避免“加载页面→立即抓取→零交互关闭浏览器”这种机械化模式,因为这正是 reCAPTCHA v3 经过训练专门用于识别的行为模式。
第5步:从渲染后的 HTML 中解析商品信息
页面加载完成并渲染动态内容后,即可安全获取 HTML 并提取商品数据。在 Lulu and Georgia 这个页面上,商品以 Algolia 搜索结果的形式呈现。
def parse_products(html, limit=5):

    soup = BeautifulSoup(html, "lxml")
    products = []
    product_cards = soup.select("ol.ais-Hits-list li.ais-Hits-item section.productCard")

    for card in product_cards[:limit]:
        product = {}
        name = card.select_one("h3.TileTitle")
        if name:
            product["name"] = name.get_text(strip=True)
        designer = card.select_one("h4.TileSubtitle")
        if designer:
            product["designer"] = designer.get_text(strip=True)
        sale_price = card.select_one("section.text-bright-red")
        if sale_price:
            product["sale_price"] = sale_price.get_text(strip=True)
        orig_price = card.select_one("section.text-dark-gray.line-through")
        if orig_price:
            product["original_price"] = orig_price.get_text(strip=True)
        discount = card.select_one("span.productCard__message--discount")
        if discount:
            product["discount"] = discount.get_text(strip=True)
        if product.get("name"):
            products.append(product)
    return products
这里我们使用 CSS 选择器配合 BeautifulSoup 定位每个商品卡片,并提取名称、设计师、促销价、原价、折扣等关键字段。
要获取这些选择器,只需在浏览器中检查页面,将鼠标悬停在您关注的元素(标题、价格、链接)上,然后复制其类名或结构即可。
第 6 步:将所有内容整合到主抓取脚本中
至此,您已拥有所有构建模块,现在可以将它们整合成一个脚本:
import asyncio
import random
from playwright.async_api import async_playwright
from bs4 import BeautifulSoup

TARGET_URL = "https://www.luluandgeorgia.com/collections/sale-furniture-1"

# Residential Proxies
PROXIES = [
    "mr10478lWc5:MlXBxpEKLa_country-us_state-california@ultra.marsproxies.com:44443",
    "mr10478lWc5:MlXBxpEKLa_country-us_state-california@ultra.marsproxies.com:44443",
    "mr10478lWc5:MlXBxpEKLa_country-us_state-california@ultra.marsproxies.com:44443",
]
def get_proxy():
    """Get random proxy in Playwright format."""
    proxy = random.choice(PROXIES)
    auth, server = proxy.rsplit("@", 1)
    user, pwd = auth.split(":", 1)
    host, port = server.split(":")
    return {"server": f"http://{host}:{port}", "username": user, "password": pwd}


async def apply_stealth(page):
    # Apply stealth scripts to bypass bot detection.
    await page.add_init_script("""
        Object.defineProperty(navigator, 'webdriver', { get: () => undefined });
        Object.defineProperty(navigator, 'plugins', {
            get: () => [
                { name: 'Chrome PDF Plugin' },
                { name: 'Chrome PDF Viewer' },
                { name: 'Native Client' }
            ]
        });
        Object.defineProperty(navigator, 'languages', { get: () => ['en-US', 'en'] });
        window.chrome = { runtime: {} };

        const originalQuery = window.navigator.permissions.query;
        window.navigator.permissions.query = (params) => (
            params.name === 'notifications'
                ? Promise.resolve({ state: Notification.permission })
                : originalQuery(params)
        );
    """)

async def simulate_human(page):
    """Simulate human-like behavior with mouse movements and scrolling."""
    # Random mouse movements
    for _ in range(random.randint(2, 4)):
        await page.mouse.move(random.randint(100, 800), random.randint(100, 500))
        await asyncio.sleep(random.uniform(0.1, 0.3))

    # Scroll down gradually
    for _ in range(3):
        await page.evaluate(f"window.scrollBy(0, {random.randint(200, 400)})")
        await asyncio.sleep(random.uniform(0.3, 0.7))

    await asyncio.sleep(random.uniform(0.6, 1.6))

    # Scroll back up
    await page.evaluate("window.scrollTo(0, 0)")
    await asyncio.sleep(random.uniform(0.3, 0.5))

def parse_products(html, limit=5):
    """Parse top products from HTML using correct Algolia selectors."""
    soup = BeautifulSoup(html, "lxml")
    products = []

    # Find products in search results
    product_cards = soup.select("ol.ais-Hits-list li.ais-Hits-item section.productCard")

    for card in product_cards[:limit]:
        product = {}

        # Product name
        name = card.select_one("h3.TileTitle")
        if name:
            product["name"] = name.get_text(strip=True)

        # Designer
        designer = card.select_one("h4.TileSubtitle")
        if designer:
            product["designer"] = designer.get_text(strip=True)

        # Sale price (red text)
        sale_price = card.select_one("section.text-bright-red")
        if sale_price:
            product["sale_price"] = sale_price.get_text(strip=True)

        # Original price (strikethrough)
        orig_price = card.select_one("section.text-dark-gray.line-through")
        if orig_price:
            product["original_price"] = orig_price.get_text(strip=True)

        # Discount
        discount = card.select_one("span.productCard__message--discount")
        if discount:
            product["discount"] = discount.get_text(strip=True)

        if product.get("name"):
            products.append(product)

    return products

async def scrape():

    print("\n  Running scraper...")
    proxy = get_proxy()
    # Random viewport for fingerprint variation
    viewport = random.choice([
        {"width": 1920, "height": 1080},
        {"width": 1366, "height": 768},
        {"width": 1536, "height": 864},
    ])

    async with async_playwright() as p:
        # Launch browser with stealth settings
        browser = await p.chromium.launch(
            headless=False,
            channel="chrome",
            args=["--disable-blink-features=AutomationControlled", "--no-sandbox"]
        )

        context = await browser.new_context(
            viewport=viewport,
            user_agent="Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
            locale="en-US",
            timezone_id="America/Los_Angeles",
            proxy=proxy,
            ignore_https_errors=True,
        )

        page = await context.new_page()
        await apply_stealth(page)

        print(f" Navigating to: {TARGET_URL}")

        try:
            await page.goto(TARGET_URL, wait_until="domcontentloaded", timeout=60000)

            # Wait for products to load
            await page.wait_for_selector("ol.ais-Hits-list", timeout=30000)

            # Simulate human behavior
            await simulate_human(page)
            print("Page loaded successfully!")
            html = await page.content()

            # Parse products
            products = parse_products(html)
            print(f"\n Found {len(products)} products:")

            for i, prod in enumerate(products, 1):
                print(f"{i}. {prod['name']}")
                if prod.get('designer'):
                    print(f"   {prod['designer']}")
                if prod.get('sale_price'):
                    print(f"   Price: {prod['sale_price']}")
                if prod.get('original_price'):
                    print(f"   Was: {prod['original_price']}")
                if prod.get('discount'):
                    print(f"   {prod['discount']}")
                print()

            return products

        except Exception as e:
            print(f"Error: {e}")
            return []

        finally:
            await browser.close()
            print("Browser closed")
if __name__ == "__main__":
    asyncio.run(scrape())
请务必将用户名和密码占位符替换为您实际的住宅代理凭据。如果您还没有账户,可以在 MarsProxies 注册后跟着操作。
运行该文件后,您会在终端中看到打印出的一小份促销家具商品列表。
Running scraper...
Navigating to: https://www.luluandgeorgia.com/collections/sale-furniture-1
Page loaded successfully!

 Found 5 products:
1. Billow Accent Chair
   by Sarah Sherman Samuel
   Price: $1,838 - $2,298
   Was: $2,298

2. Hadler Outdoor Sofa
   Price: $1,399 - $2,798
   Was: $2,798
   50% OFF

3. Hadler Outdoor Swivel Lounge Chair
   Price: $799 - $1,598
   Was: $1,598

4. Delise Accent Chair
   Price: $908
   Was: $1,298
   30% OFF

5. Koppel Accent Chair
   Price: $698
   Was: $998
   30% OFF

Browser closed
整个流程更接近正常的购物会话,而不是那种瞬间抵达、抓取数据后又立刻消失的机器人行为。
如何处理令牌获取、指纹模拟与回退方案
reCAPTCHA v3 通常会在用户点击按钮或访问页面时自动触发 grecaptcha.execute()。如果仍然遭到拦截,您可以尝试以下两种方案。
方案一:由网站自动处理
如果令牌是在表单提交过程中注入的(例如注入隐藏的 g-recaptcha-response 字段),Playwright 脚本只需点击用户会点击的同一按钮即可,浏览器会自动触发令牌生成并在内部完成处理。
方案二:手动注入(进阶)
如果需要完全控制,您可以手动注入令牌:
const token = grecaptcha.getResponse(); // within the browser
在 Playwright 中,可以使用 page.evaluate() 执行该脚本、获取令牌,再将其填入相应的输入字段。大多数抓取脚本并不需要这样做,除非令牌用于 AJAX 请求且表单不会自动注入该令牌。
回退方案建议
即使配置再完善,有时仍可能得分偏低而遭到拦截。遇到这种情况时,可以尝试以下方法:
- 轮换至新的代理会话
- 更改 User-Agent 和屏幕尺寸
- 增加等待时间并放慢输入速度
- 采用退避重试机制(不要立即连续重试)
请注意:reCAPTCHA v3 不会告知请求被拦截的原因,有时需要自行推断并加以调整。
风险、局限性与法律考量
绕过 reCAPTCHA v3 是一场持续的攻防博弈,其中存在几项值得注意的风险与局限性。网站会不断更新检测系统,Google 也会持续优化 reCAPTCHA 的评分模型,今天有效的方法几个月后未必依然有效。
即使使用住宅代理并搭建了逼真的浏览器环境,如果网站检测到异常行为,仍可能出现得分偏低、意外拦截甚至 IP 被完全封禁的情况。
此外还需考虑法律层面的问题。在符合条件的情况下,抓取公开可访问的数据通常是被允许的,但绕过 CAPTCHA 等访问控制机制,可能会引发严重的合规问题,具体取决于目标网站的服务条款以及您所在地区的法律法规。
如果不确定边界在哪里,可以在 MarsProxies 博客上查看我们关于网络数据抓取法律问题的完整介绍。
总结
绕过 reCAPTCHA v3 确实可行,但绝非易事。由于 reCAPTCHA v3 会在后台默默地为用户打分,您的抓取脚本需要在干净的 IP 上运行,且在外观、动作与行为上都更接近真实用户。
结合 Python 或 JavaScript 浏览器自动化、隐身技巧、接近真实用户的交互模式、优质住宅代理,并以 reCAPTCHA 解析工具作为回退方案,可以显著提升应对 reCAPTCHA v3 的请求成功率。
一如既往,请在合法合规的范围内负责任地使用这些技巧,并遵守所访问网站的相关规定。
如果您在为抓取脚本选用稳定住宅 IP 方面有任何疑问,欢迎联系我们 24/7 全天候客服团队,也可以加入我们的 Discord 社区,获取其他代理用户分享的更多经验。
能否稳定地绕过 reCAPTCHA v3?
并非总能如此。您可以提高成功几率,但没有任何方法能保证每次都获得满分。
如何判断绕过是否成功,以及是否获得了有效的评分或令牌?
判断是否成功,通常要看网站是否允许您继续操作。如果页面正常加载、请求被接受,并且没有被重定向、要求验证或拦截,说明本次会话很可能获得了足够高的分数。
住宅代理能否保证成功绕过 reCAPTCHA v3?
不能,住宅代理无法保证绝对成功,但能显著提高成功几率。使用住宅代理或移动代理可以获得信誉更好的干净 IP,有助于 reCAPTCHA 给出更高的评分。
是否有免费或开源工具有助于绕过 reCAPTCHA v3?
有,Playwright 和 Selenium 等工具在 Python 和 JavaScript 中均可使用,都属于开源浏览器自动化框架。但请注意,仅靠免费工具无法绕过 reCAPTCHA v3,除非您的整体配置依旧表现得接近真实用户,并运行在信誉良好的 IP 上。
是否需要手动解答 CAPTCHA 验证?
不需要,reCAPTCHA v3 不要求选图或点击复选框,而是通过对行为打分,整个验证过程在后台完成,无需用户交互。