核心要点:
- AI 数据抓取工具不仅依赖写死的 XPath 和 CSS 选择器,还运用计算机视觉、OCR 与语义上下文分析来适应网站的变化。
- 无代码 AI 数据抓取工具适合非开发者使用,通常提供点选式工作流搭建功能;而 API 优先的 AI 数据抓取工具则提供更高的自定义程度,并可集成到现有的数据抓取流程中。
- 与传统方法相比,AI 数据抓取工具通常速度更慢、成本更高,但借助机器学习提升了采集数据的准确性。
AI 数据抓取工具可自动完成关键的数据抓取任务,例如在复杂的动态网站中识别正确的元素;其中一些工具专为非开发者设计,只需输入自然语言指令甚至通过鼠标点击,即可提取结构化数据。
市面上既有适合个人项目的低价 AI 数据抓取工具,例如 Thunderbit 或部分 Apify actor;也有像 Oxylabs 这样面向企业、能够流畅处理大规模项目的工具。这项技术仍处于前沿阶段,偶尔出现小问题在所难免,但发展速度很快。
我们精选了 10 款适用于不同使用场景的 AI 数据抓取工具,无论个人还是企业,只要希望简化结构化数据采集流程,都能在本文找到相应的功能介绍、价格信息与测试示例。
不过,这类工具不太可能完全取代传统的数据抓取工具。如需进一步了解,请访问我们的数据采集服务推荐列表。
AI 数据抓取工具一览
在深入了解详细列表之前,先来看一份 AI 数据抓取工具的对比表。
Firecrawl
API 优先的数据抓取平台
深度调研、网站设计克隆、AI 智能体网络爬取与数据抓取
支持
支持,通过云端实现
支持
16 美元/月
Browse AI
无代码平台
网站变化监测、自动数据元素识别、自动化工作流
支持
支持,通过云端实现
支持
19 美元/月
ScrapeGraphAI
API 优先的数据抓取平台
自然语言提示、Markdown 精简
支持
支持
支持
20 美元/月
Crawl4AI
开源 Python 库
Markdown 清理、基于大语言模型的网页数据抓取
支持(通过 Playwright)
支持,可自定义路由
支持
免费
Apify
云端市场与数据抓取生态系统
数据抓取工具推荐、无代码数据抓取、丰富的大语言模型集成
支持
支持,自动化处理
支持
29 美元/月
Thunderbit
Chrome 浏览器扩展
一键提取、分页处理
支持
支持,通过云端实现
支持
9 美元/月
Octoparse
桌面应用与网页界面
自动数据元素识别、无代码工作流
支持(Chromium 引擎)
支持,自动化处理且更难被检测
支持
69 美元/月
ScrapingBee
API 优先的数据抓取工具
数据抓取代码生成、上下文分析、自然语言提示
支持(通过无头 Chrome 执行)
支持(经典代理、优质代理及更难被检测的代理)
支持
19 美元/月
BrightData
企业级数据分析平台
自然语言提示、绕过反机器人防护、代理处理等功能
支持
支持,提供自有基础设施
支持
1.50 美元/千次页面加载
Oxylabs
企业级数据分析平台
支持 MCP、绕过反机器人防护、上下文分析等功能
支持
支持,提供自有基础设施
支持
30 美元/月
我们如何评测这些 AI 数据抓取工具
我们亲自使用每款工具的免费方案进行测试,考察其数据元素捕捉的准确度、提取速度、用户界面以及 AI 助手功能。
在大多数情况下,我们在自己的网站上运行这些 AI 数据抓取工具,提取价格数据、博客文章或摘要信息等元素;此外,我们还观察了 AI 智能体在互联网上搜索信息的方式。
最后,我们还核实并评估了价格、功能完整性、用户在线评价及代理支持情况等客观指标。
10 款 AI 数据抓取工具对比
以下列出的 AI 数据抓取工具均运用人工智能技术采集数据,但这并非优劣排名。入选工具各有所长,彼此之间既有共同点,也存在诸多差异。
1. Firecrawl:适合开发者与大语言模型工作流
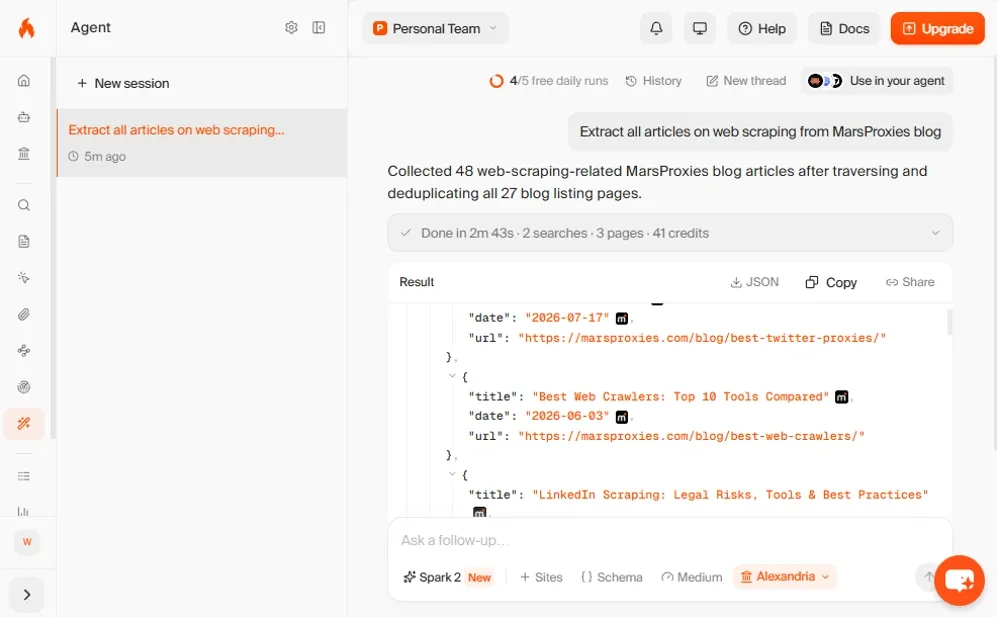
Firecrawl 是一种 API 优先的数据抓取引擎,主要面向开发者设计,可输出 JSON、Markdown 等适合大语言模型使用的格式。我们让它的智能体爬取我们的博客,提取所有与数据抓取相关的文章。
整个过程耗时 2 分 43 秒,消耗了免费版 1000 个额度中的 41 个。Firecrawl 不仅提取了与数据抓取直接相关的文章,还提取了仅包含相关章节的文章。
它支持 18 项集成,包括 Claude、ChatGPT、Grok Build 和 Zapier,您可以让它执行 SEO 审查、克隆网站设计、开展深度调研等实用工作流程。
其定价方案采用积分制,从 16 美元/月(Hobby)到 599 美元/月(Scale)不等,企业用户还可协商批量折扣。
优点
- 免费方案无需信用卡
- 集成与工作流程丰富
- 输出节省 token
缺点
- 随 token 用量增加,费用可能上升
- 存在一定学习门槛
2. Browse AI:无代码 AI 数据抓取工具
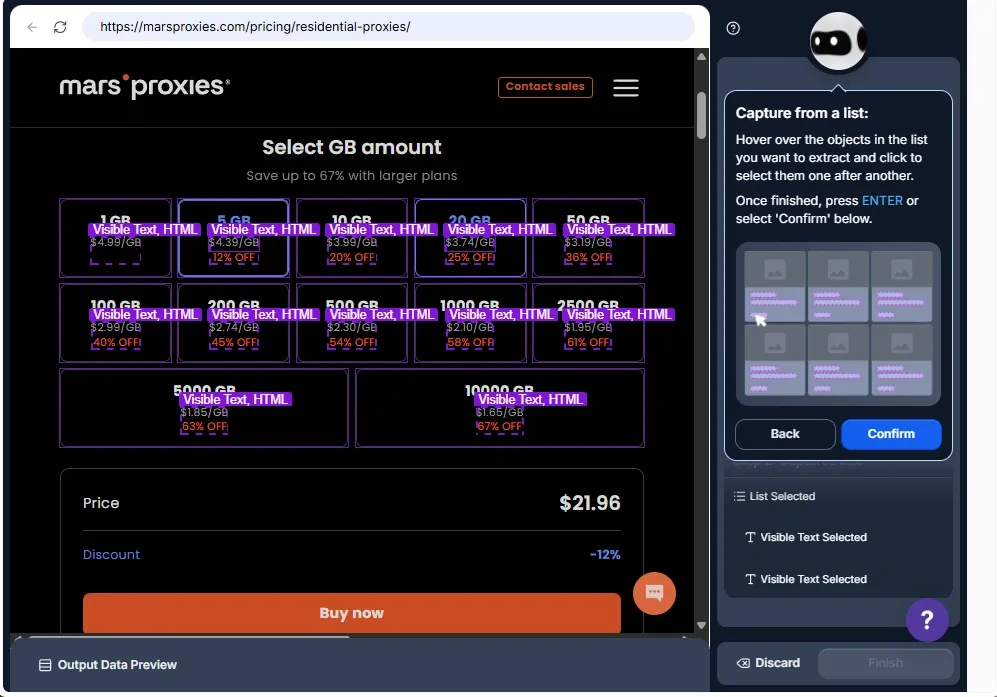
Browse AI 是一种非常适合新手使用的无代码数据提取平台,还支持监测网站变化,可构建自定义 AI 数据抓取工具,Browse AI 将其称为 robots。
我们选择提取自己的住宅代理数据,您还可以设置目标网站是否需要登录,这体现了 Browse AI 对自动化的专注,也让数据抓取新手更容易上手。
只需将光标移到目标数据上,robot 就会给出后续指引,帮助您创建自动化工作流程。
Browse AI 宣称服务用户超过 77 万位,可一次性从 50 万个页面中提取数据,并提供 Chrome 扩展程序(评分为 5 星中的 3.9 星)及 250 个预构建 robots。
Personal 方案为 19 美元/月,Professional 方案为 69 美元/月,面向企业的 Premium 方案为 500 美元/月;此外还提供免费方案,以及额度充值、专属引导等付费增值服务。
优点
- 无代码,新手友好
- 点选式数据提取
- 提供 Chrome 扩展程序
缺点
- 自定义程度有限
- 有用户反馈客服支持存在问题
3. ScrapeGraphAI:适合基于 AI 的结构化数据提取
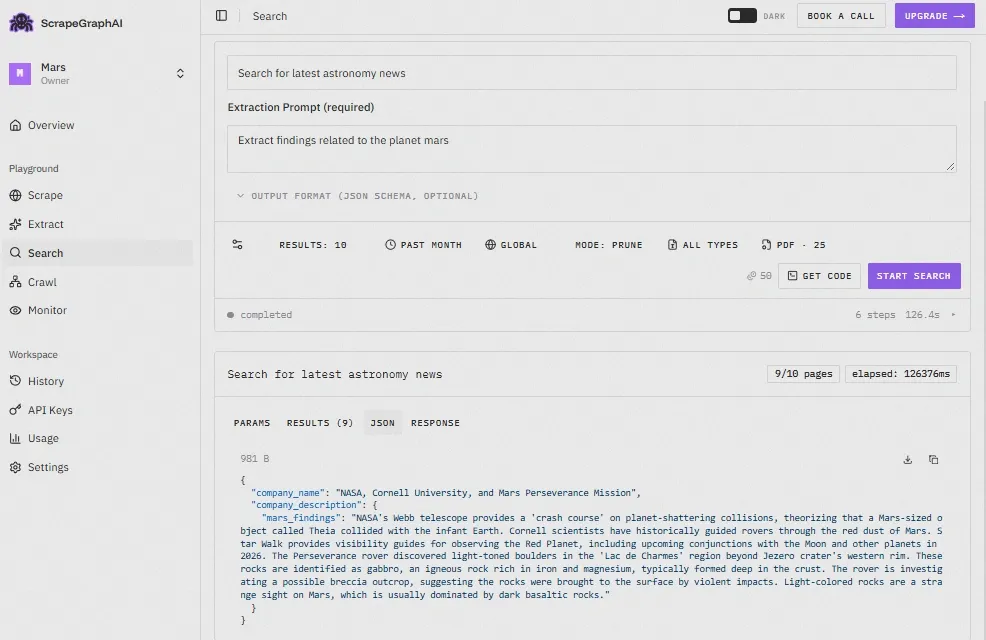
ScrapeGraphAI 是一种 API 优先的数据抓取平台,界面与 Firecrawl 相似,提供 scrape、search、monitor、extract、crawl 五个端点。
您可以将它与 Python、JavaScript SDK、n8n、Zapier 等工具集成,方便开发者进行自定义;不过平台本身的设置选项很有限,基本只能添加协作者和更改配色方案。
我们让 ScrapeGraphAI 搜索关于火星的最新新闻。
使用自然语言提示的操作方式与其他 AI 工具一样简单,它以 JSON 结构化格式返回了结果——这正是借助 ScrapeGraphAI 加快数据提取速度的方法之一。
这款数据抓取工具提供免费方案,Starter 方案为 20 美元/月,Growth 方案为 100 美元/月,Pro 方案为 500 美元/月,企业用户可联系获取定制报价。
优点
- 提示词即可轻松生成 JSON 数据
- 提供 Markdown 精简选项以节省额度
- 可自定义网站监测周期
缺点
- 偶尔出现抓取请求失败
- 不适合执行复杂的、模拟真人操作的任务
4. Crawl4AI:开源 AI 数据抓取工具
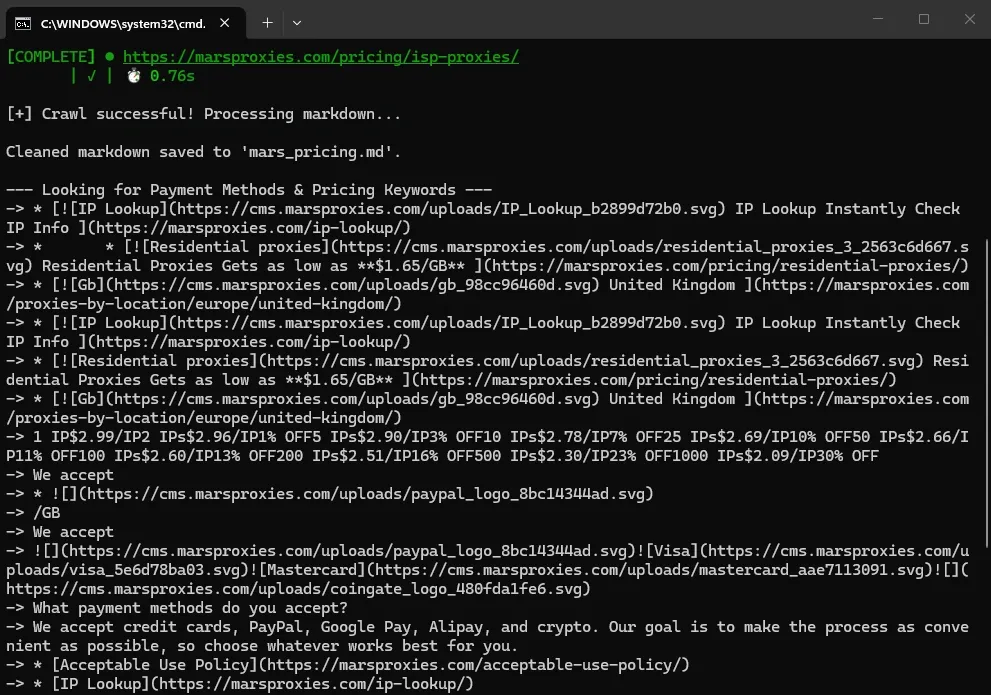
Crawl4AI 是一种完全开源的数据抓取工具,但并不适合新手:它没有浏览器控制台,也没有任何点选式界面,需要通过终端在设备上安装,同时还需预先安装 Python 和 Git。
该工具可提取去除了 HTML 冗余代码的结构化数据,既支持使用 XPath 和 CSS 选择器的传统数据抓取方式,也支持基于 AI 的数据抓取;我们借助 Crawl4AI 配合 Playwright 库,免费提取了我们的代理价格数据。
输出结果看起来有点杂乱,但我们想展示的是终端中成功完成的任务:价格数据确实都在其中,您可以将其解析为数字;JavaScript 渲染由 Playwright 处理,整个抓取工具在本地运行起来也很顺畅。
顺便一提,它完全免费。官方提供数据提取入门指南,剩下的就要靠您自己摸索了。
优点
- 完全免费
- 完全开源
- 高度可自定义
- 支持自托管
缺点
- 学习门槛较高
- 未内置反机器人检测机制
5. Apify:数据抓取与自动化生态系统
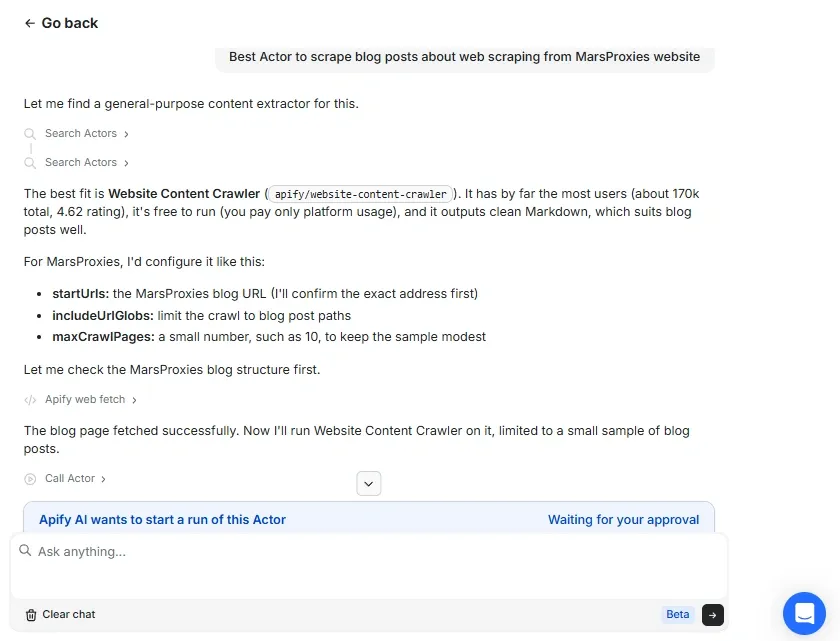
Apify 是一个大型市场,提供数千个被称为 actor 的数据抓取工具,开发者可以找到高度可定制、针对特定任务的抓取工具,而非开发者也能在无需编写任何代码的情况下使用 AI 数据抓取工具。
除了 actor 之外,Apify 也在其他环节集成了 AI 功能,可参考上图中的示例。
Apify 无需我们自行寻找适合任务的 actor:它会运用自身工具分析网站结构,并推荐合适的方案,这对数据抓取新手来说非常实用。
它推荐的 Website Content Crawler 工具可处理 JavaScript 渲染、清理数据,并支持下载为 PDF、DOC、DOCX、XLS(X)、CSV 等格式,每处理 1000 个摘要页面费用为 2 至 3 美元,具体价格会因任务复杂度及所用 actor 不同而有所变化。
优点
- 适合开发者与普通用户使用
- 提供数千个预构建 actor
- 可为任务推荐合适的 actor
缺点
- 总费用难以预估
- 容易被锁定在 Apify 平台内
6. Thunderbit:适合基于浏览器的快速抓取
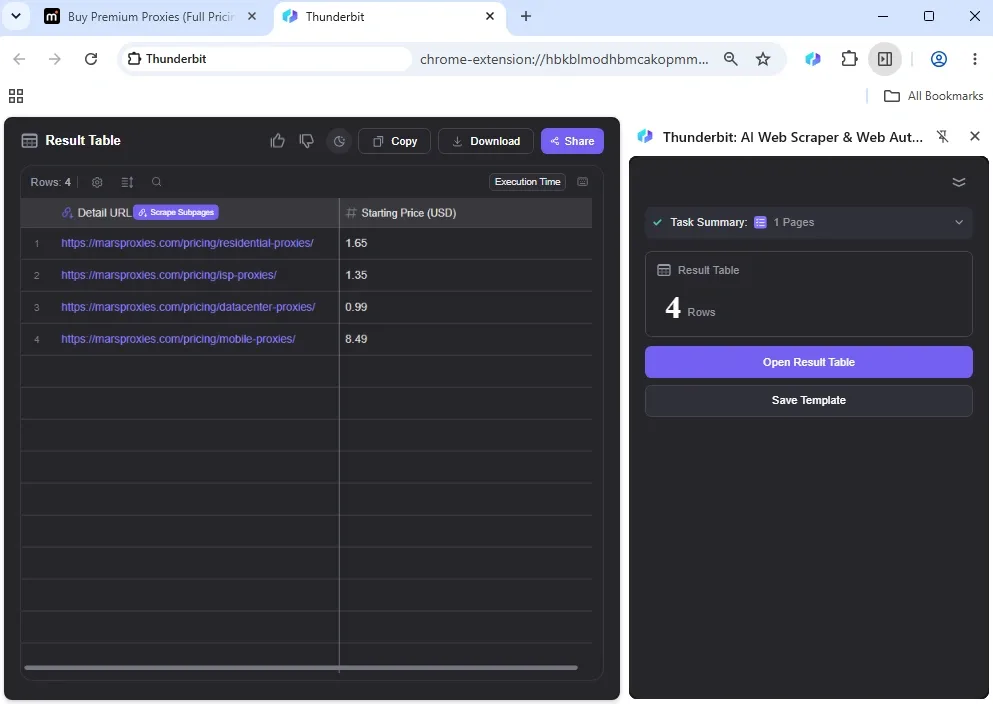
在本文列出的工具中,Thunderbit 对新手尤为友好,宣称可一键抓取网页,我们测试时确实如此;但面对更复杂的网站结构,该工具会出现失败情况,我们也遇到过这种问题。
我们直接来看结果:我们让它从MarsProxies 代理价格列表中提取价格数据。
Thunderbit 在一分钟内完成了任务,但当我们把它用在结构更复杂的数据中心代理定价页面上时,它返回的结果却全部错误地显示为零。
该数据抓取工具的用户评价褒贬不一,建议先试用免费版再决定是否升级付费版:Starter 方案 9 美元/月,Pro 方案 16.5 美元/月。
优点
- 一键提取数据
- 支持分页处理
- 适合新手使用
缺点
- 难以应对复杂网站
- 曾有用户反映客服支持存在问题
- 自定义功能较为基础
7. Octoparse:适合复杂工作流的可视化网络爬取工具
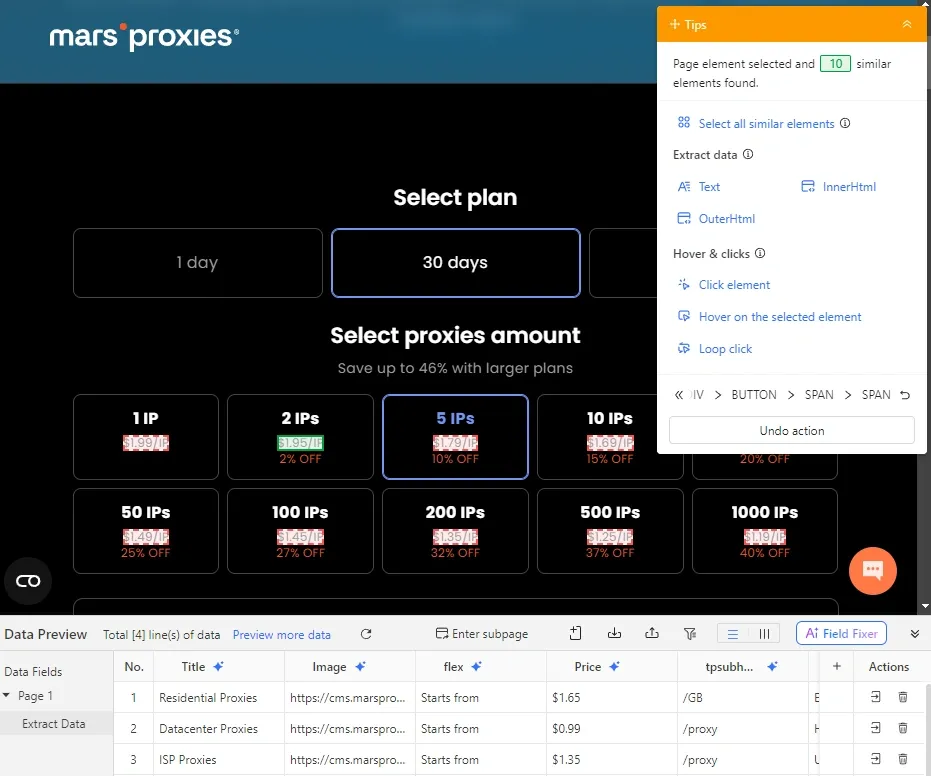
Octoparse 是一款功能强大的网络爬取平台,同时提供桌面版和浏览器版本,面向企业用户,能够从复杂来源提取结构化数据,并为多种爬取任务提供预制模板。
上图展示的是其桌面端可视化工作流构建器。在该应用中,我们输入了 Thunderbit 未能成功抓取的数据中心代理页面 URL。
将鼠标悬停在价格元素上后,Octoparse 立即定位出全部 10 个价格元素。可以看到,它同时还抓取了标题、图片等相关信息,说明这款数据抓取工具的执行效率相当高。
您还可以在其云端按自定义时间间隔安排任务运行。虽然 Octoparse 通过引导式教程介绍了全部功能,但学习曲线较陡,大量数据信息可能会让新手感到不知所措。
Octoparse 提供免费版,Standard 方案起价 69 美元/月,Professional 方案为 249 美元/月,企业版需联系销售获取定制报价。
优点
- 可抓取复杂来源数据
- 支持 IP 轮换
- 提供无代码工作流构建器
缺点
- 学习曲线较陡
- 定价较高
8. ScrapingBee:简洁易用的数据抓取 API
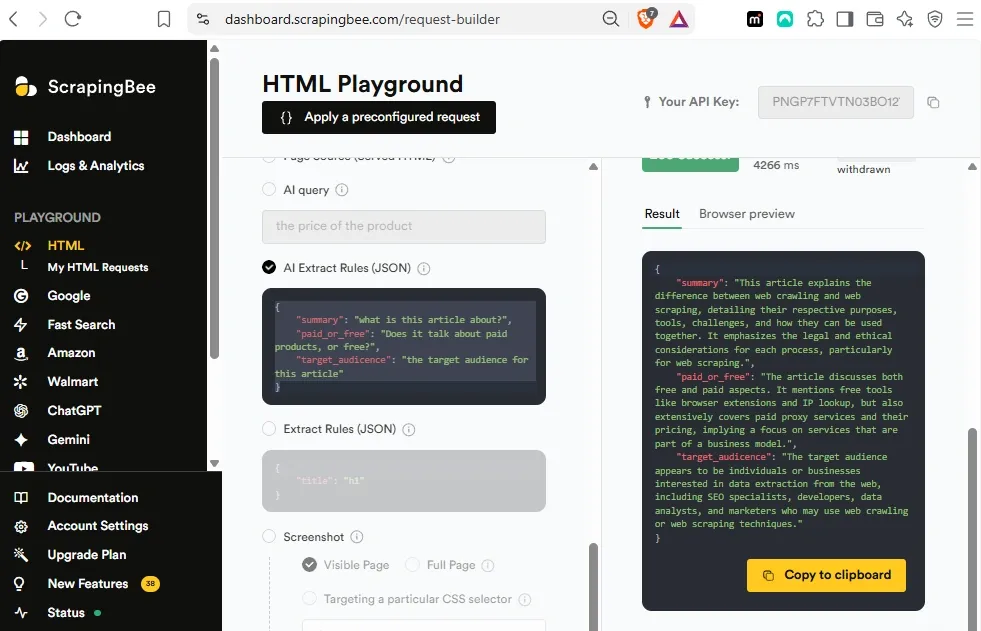
ScrapingBee 是一种可在终端或其浏览器平台上使用的数据抓取工具,提供简洁的 API,支持设置代理类型(classic、premium 或 stealth)、JavaScript 渲染、等待间隔等参数。
它提供用于抓取 Google、Amazon、Walmart 以及 ChatGPT 和 Gemini 等大语言模型的 API。其浏览器平台可生成代码片段,供开发者构建自己的 AI 抓取工具。
我们测试了 ScrapingBee 在上下文分析方面的表现,让它针对我们的网络爬取与数据抓取对比指南回答上图中的三个问题,ScrapingBee 完成得既快又准确。
免费版提供 1000 个 API 额度,标准方案从 19 美元/月(Hobby)到 599 美元/月(Business+)不等,企业方案则从 999 美元/月到 5799 美元/月不等。
优点
- 适合个人与企业用户
- API 集成简单
- 支持简单的提示词直出结果功能
缺点
- 不支持点选式数据提取
- 每月 API 调用额度有限
9. Bright Data:适合企业级规模抓取
Bright Data 是一家面向企业的数据分析公司,旗下产品涵盖代理服务、预制数据集、AI 抓取工具和各类 API。在 Trustpilot 上,其评分为 5 星中的 4.4 星,评价数超过 1000 条。
该服务具备很强的可扩展性,能够借助其代理基础设施同时发起数千个并发请求。其 Web Unlocker API 专为绕过反机器人防护(包括 CAPTCHA 验证)而设计。
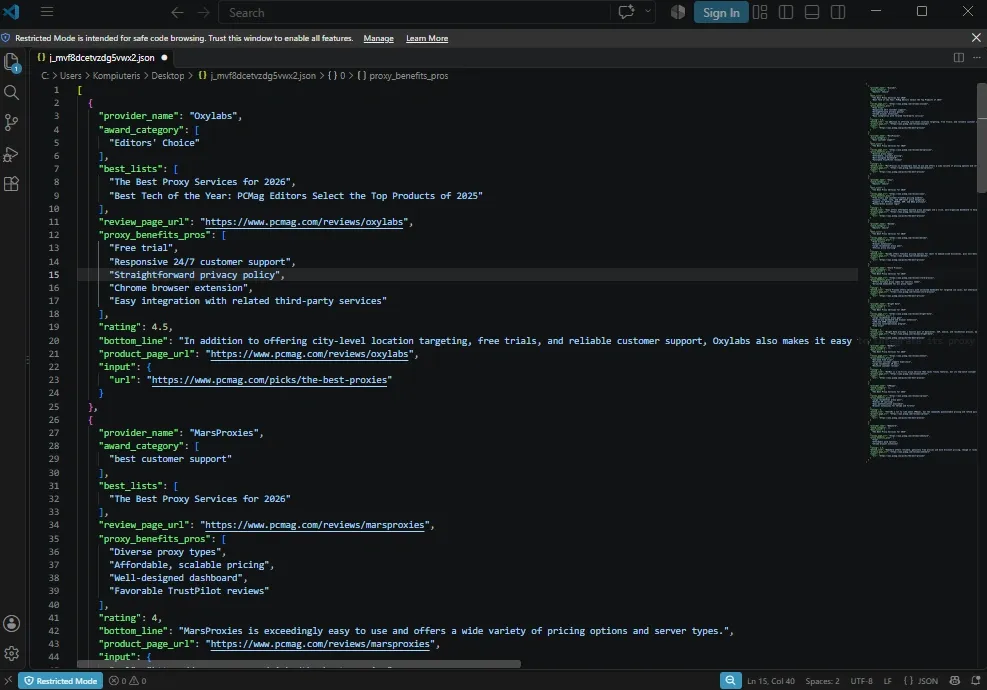
在 Bright Data 免费版允许的范围内,我们想给它一个更贴近实际业务的任务:使用自然语言提示让它抓取PCMag 的代理榜单文章,并要求列出各个分类中的获胜者,同时提取每个获胜者的其他优势信息。
Bright Data 的表现超出预期,它还连带抓取了每个获胜者各自的评测页面,共计 10 个,我们将结构化数据保存为 JSON 格式,如上图所示。
您可以选择按量计费方案,价格为每 1000 次页面加载 1.5 美元;Scale 方案起价 499 美元/月;大型企业用户请联系销售获取报价。
优点
- 提供反机器人绕过能力
- 自带代理基础设施管理
- 提示词转 JSON 输出表现出色
缺点
- 不适合个人用户使用
- 收费较高
10. Oxylabs:适合企业级 AI 抓取与反封锁场景
Oxylabs 与 Bright Data 类似,同样是面向企业的数据分析服务商,旗下产品线丰富。其 Web API 分支提供结构化数据提取工具,并支持 MCP(Model Context Protocol),可将 AI 助手与 Oxylabs 抓取工具对接。
其数据抓取工具包括搭载 AI 能力的 OxyCopilot API、Fast Search API、AI 爬虫以及无头浏览器 Agent Browser。我们将使用 Oxylabs Web API Playground 来测试其数据抓取能力。
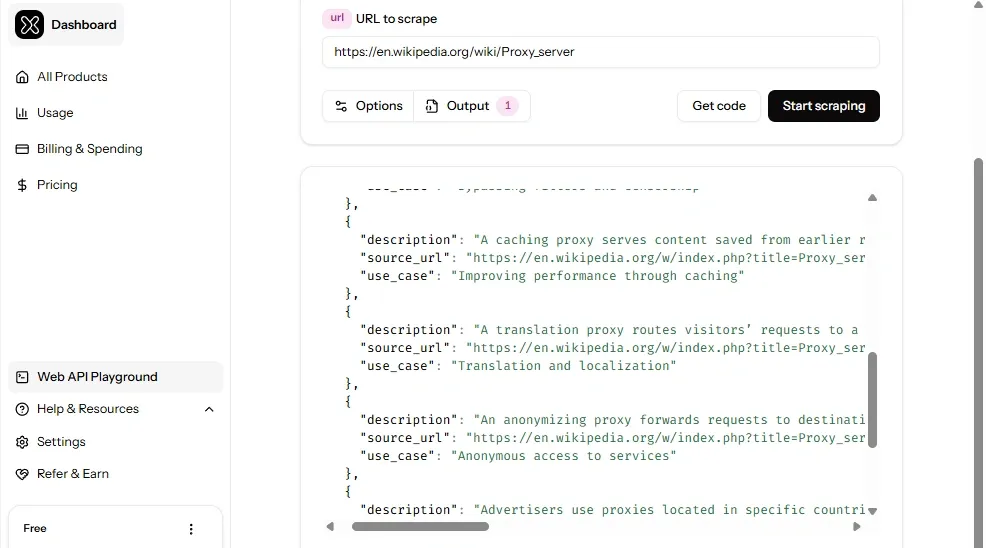
我们让它抓取Wikipedia 的代理服务器页面,提取有关正向代理的数据,并进一步访问相关链接,以 JSON 格式提取主要使用场景和优势的结构化数据。
Oxylabs 的 AI 抓取工具在面对结构复杂的页面时依然快速完成了任务,返回的结果包含主要优势说明、一个使用场景以及来源 URL。
Oxylabs Scrape 服务的 Starter 方案为 30 美元/月,Basic 方案为 100 美元/月,Flexible 方案为 500 美元/月;若需超过 2500 美元/月的大规模方案,企业用户可联系销售。
优点
- 代理网络规模较大
- 支持 Model Context Protocol
- 提供反机器人绕过工具
缺点
- 免费版功能有限
- 学习曲线较陡
哪种 AI 数据抓取工具适合您的使用场景?
综合十项评测结果,这些 AI 数据抓取工具大致可分为以下三类使用场景。
Firecrawl、ScrapeGraphAI、Crawl4AI、ScrapingBee
面向开发者的开源工具及 API
Browse AI、Thunderbit、Octoparse、Apify
无代码、适合新手
Bright Data、Oxylabs
企业级规模与进阶反封锁
AI 数据抓取工具与传统数据抓取工具对比
AI 数据抓取工具确实让数据抓取变得更简单,它们不依赖一旦网站结构变化就容易失效的固定 XPath 和 CSS 选择器。
AI 抓取工具能理解自然语言提示词,运用计算机视觉、光学字符识别(OCR)和语义分析技术,从而能够适应网站变化、抓取多模态数据,并确保数据保持最新。
但这并不意味着它们会完全取代传统的网络爬取技术。传统网络爬取速度更快,也不依赖 AI 所需的算力资源。
它的成本也更低:自建带有内部代理网络基础设施的抓取工具仅需承担维护成本,而 AI 抓取工具在大规模项目中的 Token 费用可能会大幅攀升。
AI 数据抓取工具仍然需要代理吗?
AI 驱动的数据抓取与传统数据抓取方法一样,都需要依赖代理。而且,许多网站部署了能够识别此类抓取工具的防护机制,尤其是在使用数据中心代理 IP 或完全不进行 IP 轮换的情况下。
如果您打算使用自动化 AI 工具从网站抓取数据,最好依赖优质的住宅代理或移动代理。
何时可以不使用外部代理
如果您使用的服务本身已内置代理基础设施,就无需自行管理。在我们的榜单中,不少服务(如 Oxylabs 和 Bright Data)都提供这项功能。
但依赖第三方代理网络也存在风险:它可能无法提供最优质的代理端点,从而导致抓取被封或数据不完整。如果预算充足且具备足够的技术能力,自行管理代理池能让您对结构化输出结果拥有更多掌控权。
何时适合使用外部代理
如果需要绕过反机器人防护并抓取难度较高的数据来源,建议使用外部代理。大多数大型零售网站(如 Amazon 和 Walmart)都会屏蔽抓取工具。这类企业会抓取竞争对手的数据,同时限制外部访问自身数据,以维持竞争优势。
实际上,绝大多数抓取场景都需要用到代理。网络爬取外链或复制网站设计时,如果所有 HTTPS 请求都来自同一 IP 地址,将会被网站屏蔽。
让 AI 抓取工具在 2026 年稳定抓取 Amazon 等网站
获取住宅代理结语
人工智能正在改变数据抓取方式,但并未取代传统方法。在我们的测试过程中,Crawl4AI 需要搭配 Playwright 使用,而榜单中大多数工具都使用并非由 AI 驱动的内置 Python 库。
另一方面,这些工具在自动化任务方面的表现相当出色:借助 Octoparse 可以提取海量数据,Apify 覆盖数百种使用场景,而 Oxylabs 和 Bright Data 则提供反机器人绕过能力。
所有 AI 输出结果都必须经过人工复核,因为这些工具容易出现 AI 幻觉问题,目前的技术还无法彻底解决这一问题。总而言之,最好将传统数据抓取方法与 AI 结合使用。
常见问题
最佳免费 AI 数据抓取工具是什么?
Crawl4AI 是一款出色的免费 AI 数据抓取工具,它完全开源、高度可定制,并能借助 Playwright 流畅处理 JavaScript 密集型网站。虽然上手需要一定技术基础,但 Crawl4AI 提供了详尽的入门指南。
ChatGPT 能抓取网站数据吗?
ChatGPT 是一种大语言模型,而非数据抓取工具,但它可以辅助完成网站抓取:ChatGPT 能够生成代码,供开发者和数据抓取爱好者用于自己的在线数据采集工具中。
AI 数据抓取合法吗?
AI 抓取本身是合法的,但必须遵守所在国家和地区及国际数据保护法律。在欧洲,《通用数据保护条例》(GDPR)规定了可抓取与不可抓取的数据范围;在美国,《加州消费者隐私法案》在多个州适用;在加拿大,《个人信息保护和电子文件法》(PIPEDA)则用于保护用户隐私。
AI 数据抓取工具会产生幻觉数据吗?
会的,AI 幻觉是 AI 抓取工具最突出的缺陷之一。例如,在我们测试 AI 浏览器时,曾让一个 AI 抓取工具总结一篇付费墙文章的内容。
它给出了一份详细的摘要,随后却又补充说自己其实无法访问原文内容,摘要内容是基于推测生成的。这正是传统数据抓取方法依然重要的原因,它能让开发者对结构化输出结果拥有更强的掌控力。
使用 AI 数据抓取工具需要具备编程能力吗?
不一定。编写自有代码的开发者可以根据业务需求定制抓取工具;但市场营销、SEO、人力资源、外联拓展等众多岗位的从业者,同样可以依赖人工智能来完成数据采集工作。